嗨,我是小华同学,专注解锁高效工作与前沿AI工具!每日精选开源技术、实战技巧,助你省时50%、领先他人一步。👉免费订阅,与10万+技术人共享升级秘籍!
现在做 Agent,很多人还在手动拼脚手架、接工具、改 Prompt、补运行说明,最后再自己测一遍。
PenguinHarness 的反差是:你只描述一句需求,它让 Agent 去搭建另一个 Agent 应用;应用跑起来后,还能继续评测、找问题、保存快照,再发出 N+1 版本。
最新
v0.2.1还补上了桌面端。本文不展开完整源码,只用几分钟讲清楚它到底改变了哪一层 Agent 工程。
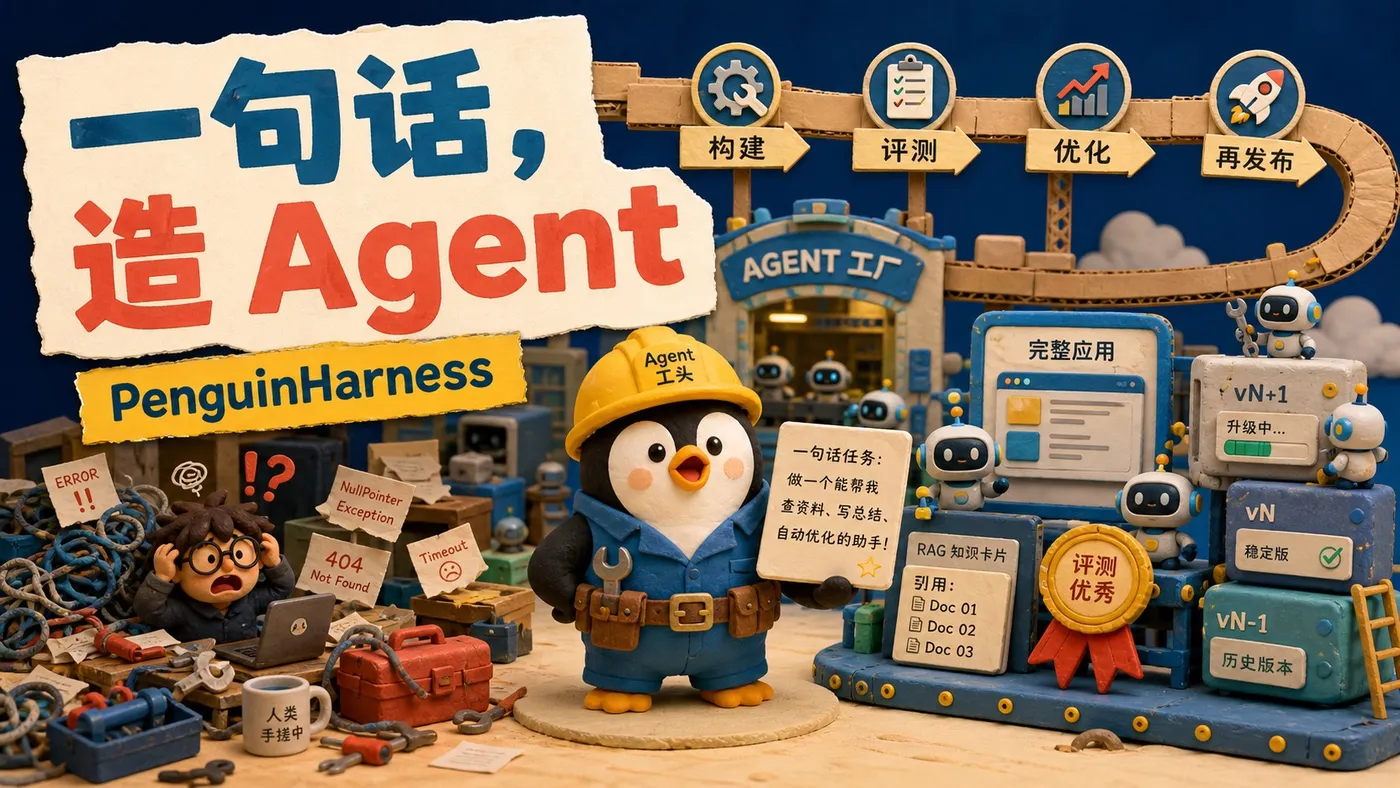
做 Agent 最费时间的,可能不是写代码
一个看似简单的 Agent 应用,通常要同时处理:
- 项目脚手架和目录结构;
- 工具、检索、模型和上下文接入;
- Prompt、配置、运行说明和错误处理;
- 测试集、评测指标、轨迹观测和版本迭代。
真正让人疲惫的是,每做一个新 Agent,都要把这套流程重新手工走一遍。
传统框架更像“给你零件和 API”;PenguinHarness 的目标更激进:把“构建 Agent”本身也交给 Agent 来完成。
PenguinHarness 到底是什么?
一句话理解:PenguinHarness 是一个自动化 Agent Builder,用自然语言生成 Agent 应用,再用 Skills 和评测闭环推动它继续优化。
官方 README 将它定位为运行在桌面或服务器上的 Agent 构建平台,支持 Linux、macOS 和 Windows。项目当前最新版本是 v0.2.1,这一版加入了桌面应用,可以双击启动完整 Web 体验;CLI、桌面端和 SDK 共用同一套数据根目录。
项目 README 声称,在自己的对比测试中,数据分析准确率领先,成本只有 Claude Code 的一小部分;但 Benchmark 套件正式公开仍列在路线图中,所以这类数字更适合作为项目方的测试口径,接入前仍要用自己的任务集复测。
它和普通 Agent 框架差在哪?
| 环节 | 常见 Agent 开发方式 | PenguinHarness 的思路 |
|---|---|---|
| 起步 | 人先搭脚手架和目录 | 用一句话描述目标 |
| 编排 | 人手动接工具、模型和 Prompt | Agent 生成应用骨架与代码 |
| 运行 | 自己补安装和启动说明 | 输出完整运行路径 |
| 评测 | 做完后再人工排查 | Benchmark、Trace 进入工作流 |
| 迭代 | 改完靠经验判断 | 快照、找失分点、优化后发布 N+1 |
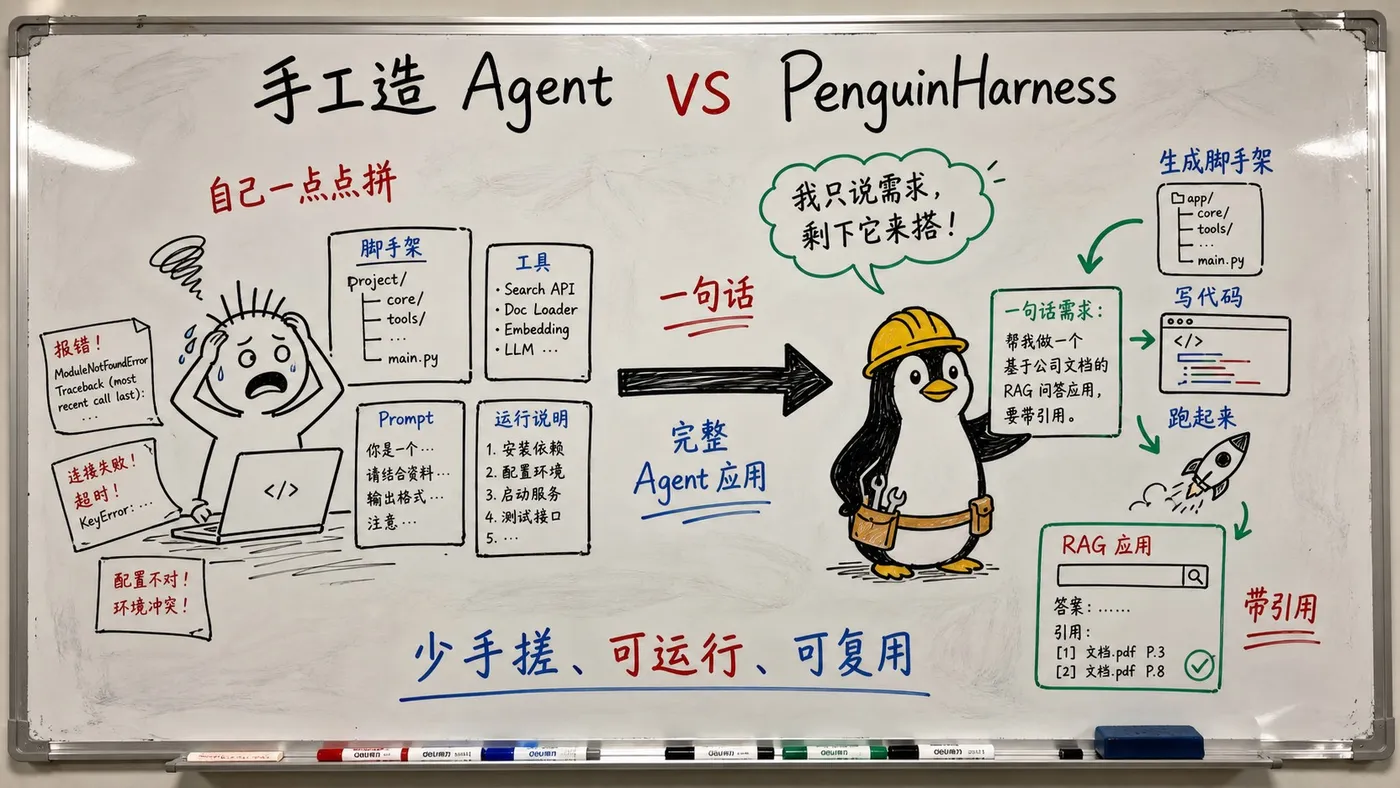
这不是“输入一句话就凭空生成完美产品”。更准确的理解是:它把 Agent 工程中最重复的搭建、运行和评测动作,做成了可以被 Agent 驱动的流水线。
一句话生成 Agent,具体会发生什么?
README 给出的示例是:让系统收集一套文档,构建一个能够回答问题、并且引用原文来源的 RAG 应用。
理想的产物不只是聊天框,而是包含:
- 文档检索和知识处理;
- 能点击回原文的引用;
- 可直接运行的项目脚手架;
- 示例问题和运行说明。
这对程序员的意义是:你可以先用自然语言验证“我要做什么”,再让系统生成第一版工程骨架,随后接手审查代码、补业务规则和加生产约束。
内置 Skills:不是工具清单,而是 Agent 的工作方法
项目开箱内置四类 Skill:
| Skill 分组 | 代表能力 |
|---|---|
| 办公效率 | data-analysis、firecrawl |
| 软件开发 | web-design、software-engineering |
| AI 应用开发 | penguin-sdk、penguin-cli、vllm、ollama |
| Agent 调优 | agent-creation、benchmark-design、agent-evaluation、agent-optimization |
更有意思的是,Agent 不只调用已有 Skill,还可以编写和优化自己的 Skill。
所以 PenguinHarness 的核心资产不只是某个模型,而是一组可以被复用、评估和持续改进的工作方法。
自进化闭环,关键在“可观测”和“可回滚”
项目描述的自进化路径可以拆成五步:
- 运行任务;
- 用 Benchmark 评测结果;
- 在 Trace 中观察请求和工具调用;
- 找到具体失分点,并在优化前保存快照;
- 生成并发布 N+1 版本。
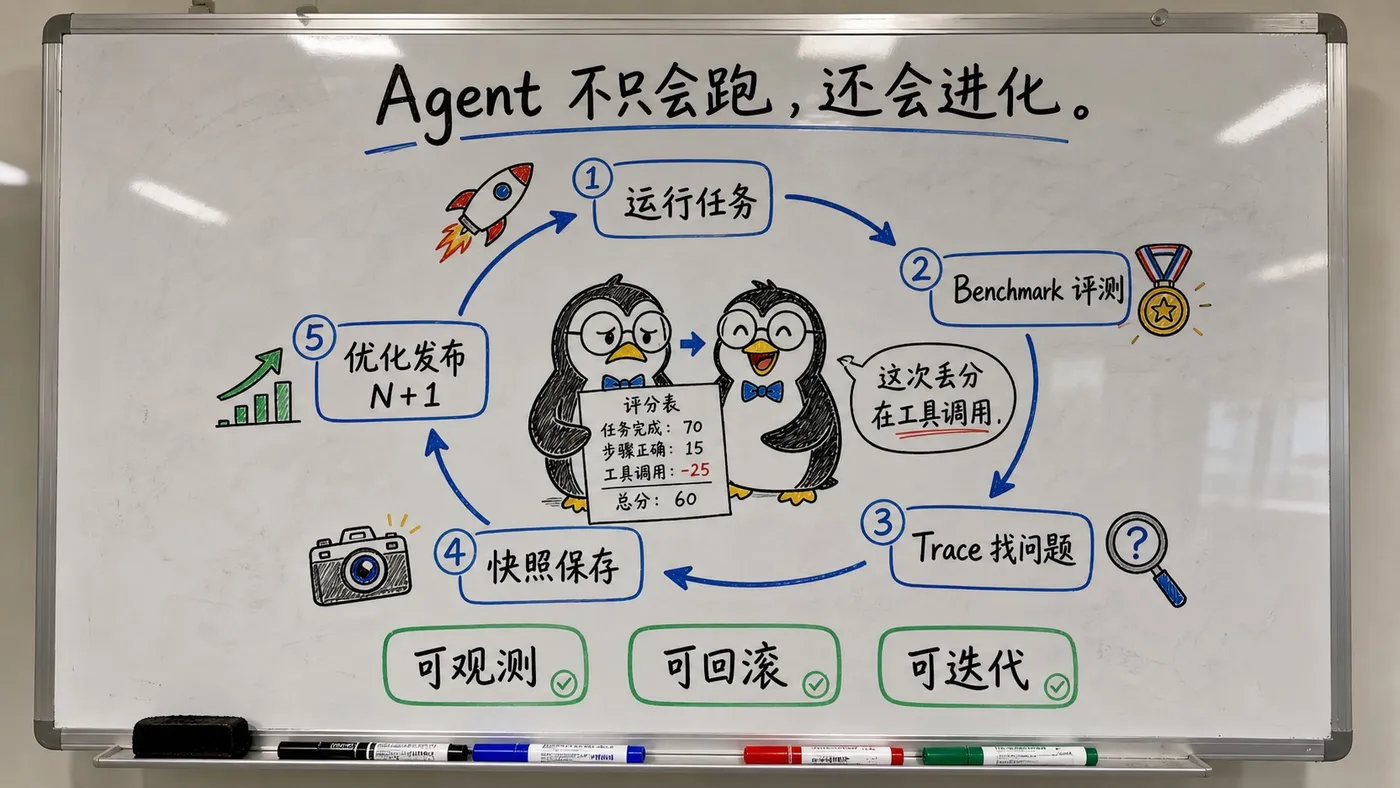
这里有一个很重要的工程判断:没有评测集和轨迹记录的“自我进化”,很容易只是模型自己说自己变强了。 PenguinHarness 至少把评测、Trace 和快照放进了同一条叙事里,给后续回归测试和问题定位留下了入口。
现在怎么跑起来?
macOS / Linux:在线安装
curl -fsSL https://penguin.ooo/install.sh | sh
penguin web
npm:安装 CLI
npm install -g @prismshadow/penguin-cli
penguin web
CLI 启动后会在本机提供 Web 体验,也可以直接执行一次性任务:
penguin run -m "Create hello.txt containing Hello, Penguin"
SDK:嵌入自己的 TypeScript 项目
import {
    createAgent, userText } from '@prismshadow/penguin-core'

const agent = await createAgent({
    agentId: 'default_agent' })
const session = await agent.createSession({
    workspaceDir: process.cwd() })

for await (const output of session.run([userText('Create hello.txt containing hi')])) {

  console.log(output)
}
使用前需要配置至少一个模型 API key。项目支持预置模型和 OpenAI 协议的自定义端点,具体模型和供应商应以当前应用配置页为准。
它适合谁?
适合:
- 想快速验证 RAG、数据分析或内部 Agent 原型的开发者;
- 需要把 Agent 创建、运行、评测和版本迭代串起来的团队;
- 希望同时使用桌面端、CLI 和 SDK 的工程环境;
- 想研究 Agent Skill 如何沉淀、复用和自我优化的人。
不适合直接当成:
- 不需要审查就能上线的自动编程黑盒;
- 不配置评测集就能自动变强的万能 Agent;
- 可以替代权限、沙箱、人工审批和生产发布流程的工具;
- 只想调用一个模型 API、完全不需要 Agent 工程管理的轻量脚本。
项目边界与我的判断
PenguinHarness 最值得关注的地方,不是“企鹅”这个名字,也不是一句话生成代码本身,而是它试图把 Agent 开发从一次性手工项目,变成一条可重复的生产和优化流程。
但边界也很清楚:
- 生成的脚手架和代码仍需要人工审查;
- 自进化质量取决于 Benchmark 的设计,指标错了,优化方向也会错;
- 工具调用涉及文件、命令和外部服务时,必须保留审批、权限和审计;
- 当前构建暂未签名,桌面端首次启动可能触发系统安全提示;
- 项目路线图中的公开 Benchmark 套件、公司级自进化和 OpenShell 集成不能当成当前已经完成的能力。
如果你只想“做一个 Agent”,它可能显得有点重;但如果你想“持续做出一批 Agent,并且知道它们为什么变好”,PenguinHarness 的方向就很有价值。
后续我会继续拆它的 Skill 结构、Trace 观测和 penguin-core SDK 调用链。