
随着AI应用大规模落地,大量线上业务的核心诉求不再是超高难度深度推理,而是稳定、低延迟、低成本的标准化任务处理。文本分类、内容摘要、图片信息提取、基础问答、轻量检索智能体这类场景,请求并发量大,单次任务逻辑简单,如果直接选用高阶大模型,会带来极高的推理成本。Qwen3.7‑Flash是通义千问3.7系列原生视觉语言轻量化高速多模态模型,相比前代版本,在多模态理解、万物识别、空间感知、智能体执行稳定性上完成全面升级,专门面向高吞吐、低延迟、轻量化图文任务打造,最大支持256K Token上下文窗口,原生支持文本、图片输入,适配批量离线处理与线上实时请求。
很多开发者初次接触这款高速模型,很容易混淆Qwen3.7‑Flash与同系列Plus、Max模型的能力边界,不清楚图片输入会折算Token产生额外费用,也不熟悉上下文缓存的降本机制,选型阶段容易出现模型错配、预算失控、请求超时等一系列问题。本文将全面介绍Qwen3.7‑Flash核心功能、详细计费规则、完整接入配置流程,搭配可直接运行的API代码、命令行工具,同时提供业务选型判断标准与生产环境避坑方案,帮助开发者快速完成模型接入,合理规划调用成本。
一、Qwen3.7‑Flash核心功能介绍
Qwen3.7‑Flash属于原生视觉语言轻量高速模型,在多模态基础能力上做了深度优化,万物识别能力更强,真实世界图像感知、空间智能能力进一步提升,Search Agent、CI Agent这类多模态智能体场景端到端执行稳定性显著增强,同时优化多模态代码生成能力,看图编程、vibe coding的体验更加流畅。模型原生支持Function Calling、结构化JSON输出、联网搜索、上下文缓存、批量推理,不支持用户侧微调。业务个性化需求,优先采用RAG检索增强、系统提示词约束、结构化输出方案实现。详情👉访问阿里云百炼大模型服务平台页面 了解。
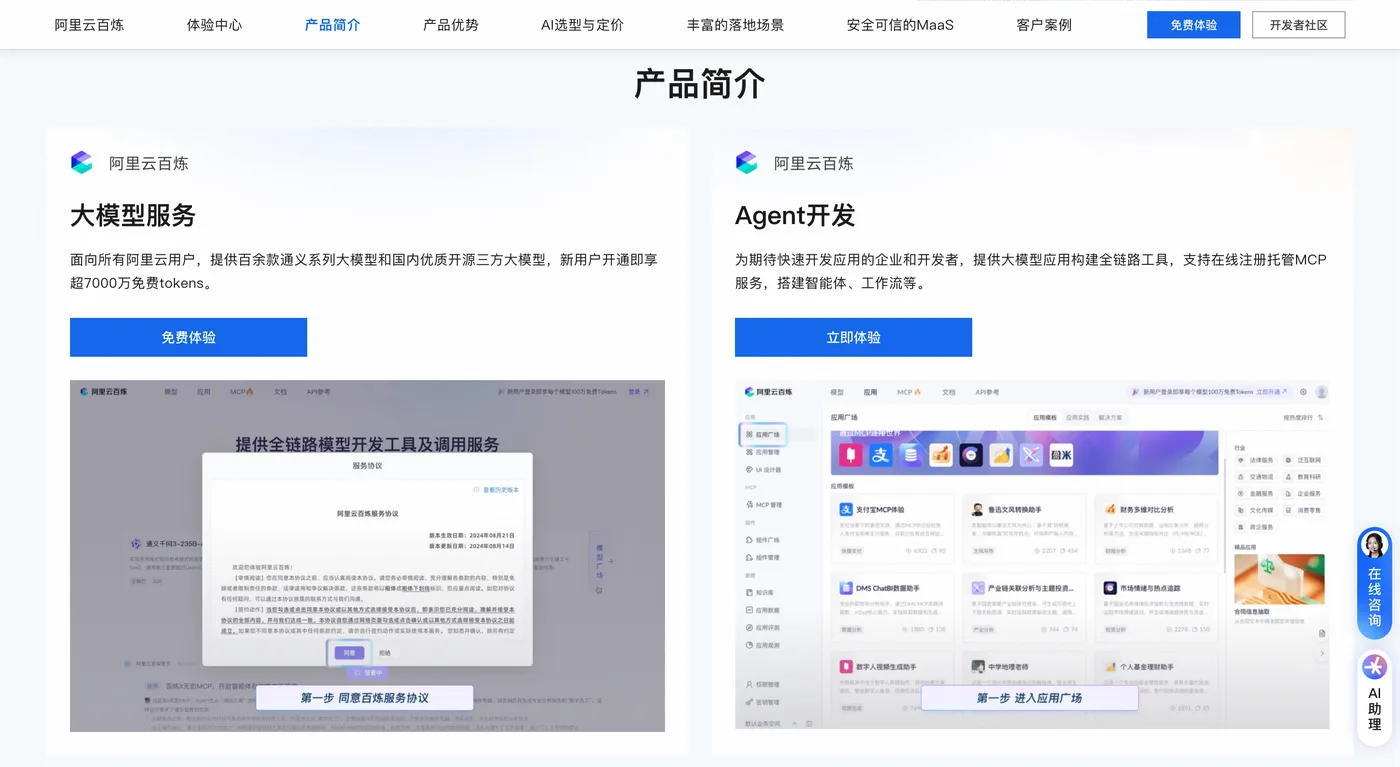
第一,轻量化多模态图像识别能力。Qwen3.7‑Flash可以完成图片基础信息提取,识别截图、简单图表、照片内容、表单、手绘草图,适合图片OCR、图片内容分类、商品图片信息提取、简单截图解读。在开发场景中,简单UI截图可以快速生成基础页面代码,基础报错截图能够识别图片内文字内容,给出简易排查方案。但对于复杂多层图表、大量公式、多元素复杂UI界面,它的推理精度会下降,这类复杂图文任务推荐Qwen3.7‑Plus。模型仅支持静态图片帧解析,不适合长视频时序事件连续分析,视频相关业务只能将视频拆分为图片帧,逐帧单独提取信息。
第二,256K上下文窗口,支持轻量化长文本处理。最大支持256K Token上下文,能够一次性载入中等长度文档、批量文本段落、中小型代码文件,适合批量文档摘要、文本分类、简单信息抽取。这里需要明确区分,256K上下文代表它能够承载较长的输入文本,并不等同于拥有超强深度长文档推理能力。Flash模型擅长从文档里面提取关键信息、做摘要、分类,但是跨章节复杂逻辑对比、多文档交叉深度分析,依然推荐Qwen3.7‑Max。上下文缓存功能同样支持,在重复知识库检索、多轮短对话场景开启缓存,命中缓存之后输入Token单价大幅降低,大批量业务场景降本效果非常明显。同时支持Batch File、Batch Chat批量任务模式,离线大批量图文处理可以享受专属优惠单价,适合离线批量文档处理、图片信息抽取业务。
第三,轻量化工具调用与简易Agent能力。Qwen3.7‑Flash原生支持Function Calling,兼容标准工具调用协议,能够对接检索工具、数据库简易查询、文件读取等轻量工具,搭建简单的检索增强智能体。模型可以完成基础任务拆解,判断是否调用外部工具,拿到返回结果之后继续回答,适合轻量搜索Agent、简单文档问答Agent。但长周期、数十轮循环迭代、多工具串联的复杂智能体,Flash模型容易出现工具调用参数错误、任务跑偏,这类复杂Agent业务建议升级到Plus或者Max。基础代码生成能力可以满足脚本编写、简单函数开发、基础代码补全,轻量化vibe coding场景响应迅速。
第四,结构化输出与高并发推理能力。原生支持强制JSON结构化输出,可以稳定按照指定JSON格式返回结果,后端程序直接解析,省去大量文本清洗、正则匹配开发工作量。模型架构专门针对高并发、低延迟场景优化,单实例支持更高吞吐量,单次请求响应时延更低,适合在线客服、内容审核、图文素材批量处理这类高QPS线上业务。同时支持前缀续写能力,适合代码补全、短文续写场景,内置联网搜索能力,基础信息查询场景可以调用搜索工具获取外部资料辅助回答。
第五,通用轻量化生产力场景能力。适合大批量文本内容分类、文章摘要、图片信息抽取、表单提取、简单扫描文档文字提取、客服问答等标准化任务。这类业务请求量大、单任务逻辑简单,对响应速度和成本敏感,不需要极强深度推理,Qwen3.7‑Flash就是最佳选型。在企业内容库批量处理、素材自动化打标签、简单图文质检场景,能够稳定承载海量请求,大幅降低整体调用成本。
二、Qwen3.7‑Flash计费规则详解
Qwen3.7‑Flash支持多种计费模式,包含按量计费、资源包、Token Plan订阅套餐、节省计划。抵扣优先级固定:免费额度优先消耗,其次资源包,再是订阅套餐,全部耗尽后自动切换按量计费。
按量计费采用阶梯定价,按照单次请求输入Token数量划分档位,0至32K、32K至128K、128K至256K三档,不同档位输入、输出单价不同,输入Token和输出Token分开计价,输出Token单价高于输入。文本按照文字折算Token;图片输入会根据图片分辨率、画面尺寸折算输入Token,图片分辨率越高,消耗Token越多,高并发批量图片处理业务,图片压缩是控制成本的关键。
在Function Calling场景,系统提示词、用户图文输入、历史对话、工具返回内容全部计入输入Token;模型生成的思考内容、工具调用参数、最终回答计入输出Token。轻量Agent多轮循环调用时,工具返回结果持续累积输入Token,业务侧需要设置最大调用轮次,防止无限循环带来账单暴涨。
上下文缓存分为显式缓存与隐式缓存,创建缓存阶段消耗Token,后续调用命中缓存,输入Token单价会大幅优惠。在RAG知识库、高频重复prompt场景,开启缓存可以显著降低长期调用成本。Batch File离线批量任务、Batch Chat模式拥有独立优惠单价,大批量离线图文提取业务优先选用批量接口,进一步压缩成本。
资源包属于预付费套餐,一次性购买固定额度Token,专门用于Qwen3.7‑Flash调用抵扣,相比按量计费单价更低,适合项目验证、短期大批量测试。资源包存在有效期,到期未使用额度自动失效,不支持退款,不同模型资源包相互独立,不能跨模型抵扣。
Token Plan订阅套餐为包月模式,套餐内额度可以跨多款模型共享,适合长期稳定持续调用的业务。订阅套餐可以搭配Coding Plan使用,面向轻量代码开发场景享受专属折扣。节省计划面向企业大规模长期调用场景,采购周期越长折扣力度越高,自动抵扣账单。
新人开通百炼平台,可领取Qwen系列模型免费试用Token额度,用于测试Qwen3.7‑Flash能力,免费额度有有效期限制,额度耗尽或到期自动失效。未实名认证账号,免费额度耗尽后无法继续调用,完成实名认证后,额度耗尽自动转为按量计费。
计费避坑重点:第一,图片会折算输入Token,批量业务务必前端压缩图片分辨率,降低图片尺寸,减少Token消耗;第二,阶梯定价,单次请求输入Token超过档位阈值,单价会上升,长文本任务尽量拆分,避免单次请求触发更高档位;第三,轻量Agent要设置最大工具调用轮次,防止无限循环持续消耗Token;第四,批量离线处理优先使用Batch接口,享受专属低价。
为了实时监控模型调用消耗,我们可以使用CLI命令查询Qwen3.7‑Flash调用记录,统计Token消耗:
aliyun dashscope ListCallRecords --Model qwen3.7-flash --StartTime 2026-09-01T00:00:00Z --EndTime 2026-09-16T23:59:59Z
执行该命令,会返回该时间段内所有Qwen3.7‑Flash调用记录,包含输入Token、输出Token、调用时间、返回状态,方便统计账单消耗,评估预算使用情况。
三、Qwen3.7‑Flash接入配置完整流程
整体接入分为账号准备、API密钥创建、环境配置、接口调用、业务调试、生产上线六个步骤。详情👉访问阿里云百炼大模型服务平台页面 了解。
第一步,账号准备。注册并完成账号实名认证,进入百炼平台控制台,开通模型服务权限,开通后即可使用Qwen3.7‑Flash。未完成实名认证的账号,无法进行付费调用。
第二步,创建API Key。进入控制台密钥管理页面,新建API密钥,保存密钥信息,密钥具备模型调用权限,需要妥善保管,禁止硬编码写在前端代码、公开代码仓库中,防止密钥泄露,产生盗刷账单。生产环境推荐使用环境变量、密钥托管服务保存密钥。
第三步,本地或服务器环境准备。推荐Python开发环境,安装依赖包,用于调用模型API。
pip install requests dashscope openai
第四步,编写基础对话调用代码,测试基础对话能力。下面是可直接运行的Python调用示例,兼容OpenAI兼容接口,修改模型名称参数即可切换模型。
import os
from openai import OpenAI

# 从环境变量读取API密钥,避免硬编码
DASHSCOPE_API_KEY = os.getenv("DASHSCOPE_API_KEY")
client = OpenAI(
    api_key=DASHSCOPE_API_KEY,
    base_url="[https://dashscope.aliyuncs.com/compatible-mode/v1](https://dashscope.aliyuncs.com/compatible-mode/v1)"
)

def qwen37flash_chat(user_prompt):
    payload = {

        "model": "qwen3.7-flash",
        "messages": [
            {
   "role": "system", "content": "你是高效的信息提取助手,简洁输出,优先返回结构化内容。"},
            {
   "role": "user", "content": user_prompt}
        ],
        "temperature": 0.7,
        "max_tokens": 2048
    }
    resp = client.chat.completions.create(**payload)
    return resp.choices[0].message.content

if __name__ == "__main__":
    res = qwen37flash_chat("提取这段文本的核心关键词,输出JSON格式")
    print(res)
在服务器终端配置环境变量,填入密钥,执行脚本测试:
export DASHSCOPE_API_KEY="sk-xxxxxxxxxxxxxxxxxxxxxxxxxxxx"
python3 qwen37flash_demo.py
第五步,多模态图片输入调用示例,上传图片链接,实现图片信息提取、简单OCR解析。
import os
import requests

DASHSCOPE_API_KEY = os.getenv("DASHSCOPE_API_KEY")
url = "[https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions](https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions)"
headers = {
   "Authorization": f"Bearer {DASHSCOPE_API_KEY}", "Content-Type":"application/json"}

payload = {

    "model":"qwen3.7-flash",
    "messages":[
        {
   "role":"user",
         "content":[
             {
   "type":"text","text":"提取图片表单中的所有文字信息,输出JSON列表"},
             {
   "type":"image_url","image_url":{
   "url":"https://xxx/form_image.png"}}
         ]
        }
    ],
    "temperature":0.7
}
resp = requests.post(url,headers=headers,json=payload)
print(resp.json())
第六步,Function Calling工具调用示例,搭建轻量检索智能体。模型读取图文信息后,调用检索工具获取资料。
import os
from openai import OpenAI

DASHSCOPE_API_KEY = os.getenv("DASHSCOPE_API_KEY")
client = OpenAI(api_key=DASHSCOPE_API_KEY, base_url="[https://dashscope.aliyuncs.com/compatible-mode/v1](https://dashscope.aliyuncs.com/compatible-mode/v1)")

tools = [
    {

        "type": "function",
        "function": {

            "name": "simple_search",
            "description": "检索知识库,查询基础资料,返回摘要信息",
            "parameters": {

                "type": "object",
                "properties": {
   "query": {
   "type": "string", "description": "检索关键词"}},
                "required": ["query"]
            }
        }
    }
]

messages = [
    {
   "role":"user",
     "content":[
         {
   "type":"text","text":"根据图片里的产品名称,检索知识库获取产品简介"},
         {
   "type":"image_url","image_url":{
   "url":"https://xxx/product_img.png"}}
     ]
    }
]

resp = client.chat.completions.create(
    model="qwen3.7-flash",
    messages=messages,
    tools=tools,
    tool_choice="auto",
    temperature=0.7
)
print(resp.choices[0].message)
第七步,生产环境调试与上线。开发阶段先用免费额度测试,验证图文提取、问答效果,确认业务符合预期。上线前配置账单告警,设置消费阈值,当账单达到阈值自动停止调用,防止超额扣费。同时增加异常捕获逻辑,处理网络超时、限流、图片解析失败、模型调用失败等场景。图片链接需要确保公网可访问,否则模型无法读取图片内容。大批量请求场景,增加限流与队列控制,避免瞬间流量冲击接口,触发限流报错。
四、业务选型指南:什么时候选择Qwen3.7‑Flash
Qwen3.7‑Flash属于高速经济型多模态模型,推理速度快、单位Token成本低,适合高并发、任务逻辑简单的图文业务,需要结合任务复杂度、输入模态、预算综合判断。
适合选用Qwen3.7‑Flash的场景:
- 高并发在线问答、客服对话、文本分类、文章摘要、关键词提取,单轮任务逻辑简单,请求量大,对延迟与成本敏感;
- 大批量图片基础OCR、图片打标签、商品图片信息提取、简单表单识别,仅需要提取图片内基础文字信息,不做复杂图表深度分析;
- 轻量检索Agent、简易知识库问答,工具调用轮次少,任务链路短,不需要几十轮连续工具循环;
- 离线批量文档处理、批量图文素材标注,使用Batch批量接口,进一步压低整体处理成本。
不推荐选用Qwen3.7‑Flash的场景:
- 复杂图表、多层表格、复杂公式深度图文联合推理,需要精细数据分析,推荐Qwen3.7‑Plus;
- 长周期多轮复杂智能体、大型多文件代码工程、几十万字长文档跨章节深度逻辑分析,选用Qwen3.7‑Max;
- 长视频时序事件理解、超高难度多模态复杂推理任务,需要选用更高阶旗舰模型。
推荐采用分层路由架构,实现成本优化。通过代码判断请求类型,简单图文、基础文本任务路由到Flash;常规中等复杂度图文混合任务路由到Qwen3.7‑Plus;纯文本超高难度长文档推理交给Qwen3.7‑Max;超高难度多模态复杂任务路由至旗舰模型。简单路由示例代码:
def route_model(user_input, has_image:bool, task_complex:bool):
    # 简单图文任务,使用flash
    if has_image and not task_complex:
        return "qwen3.7-flash"
    # 图片+复杂分析,选用plus
    elif has_image and task_complex:
        return "qwen3.7-plus"
    # 超长纯文本深度推理,选用max
    elif len(user_input) > 6000 and task_complex:
        return "qwen3.7-max"
    else:
        return "qwen3.7-flash"
将该路由逻辑嵌入后端服务,自动分配模型,把低成本高速模型作为流量底座,高阶模型只处理少量复杂请求,大幅降低整体业务的调用开销。
五、生产环境避坑指南与常见问题
问题1:传入图片链接,模型返回图片加载失败。排查图片链接是否为公网可访问地址,检查图片大小、分辨率,过大图片建议前端压缩;确认接口请求体格式正确,image_url参数配置无误。批量业务建议统一压缩图片,一方面降低图片加载失败概率,另一方面减少Token消耗。详情👉访问阿里云百炼大模型服务平台页面 了解。
问题2:大批量图片业务,账单上涨速度超出预期。图片会折算输入Token,高清大图消耗更高。解决方案:前端预处理图片,降低分辨率,压缩图片尺寸,非必要不使用超高分辨率原图;单次请求限制图片数量,不要一次性传入大量图片;使用Batch批量接口处理离线任务,享受优惠单价。
问题3:长文本输入,触发更高阶梯定价,成本上升。Qwen3.7‑Flash采用阶梯计价,单次输入Token超过阈值单价上升。长文本任务建议拆分请求,将超长文档拆分为多个分段,避免单次请求进入高价档位,同时开启上下文缓存,减少重复内容Token消耗。
问题4:轻量Agent出现工具调用参数错误、任务中断。Flash适合短链路轻量工具调用,多轮复杂任务容易出现幻觉。解决方案:限制最大工具调用轮次,增加返回结果校验;工具描述尽量简洁明确,减少复杂参数定义;复杂Agent任务直接切换Plus模型。
安全层面,API密钥严禁前端暴露,生产环境使用密钥托管,设置最小权限。同时配置限流策略,限制单用户每秒请求数量,防止突发流量造成账单暴增。编写简单账单监控脚本,定时查询消费金额,触发告警:
from aliyunsdkcore.client import AcsClient
from aliyunsdkbssopenapi.request.v20171214 import QueryBillRequest
import json

client = AcsClient("AccessKeyID","AccessKeySecret","cn-hangzhou")
warn_threshold = 100

def get_dashscope_bill(cycle):
    req = QueryBillRequest.QueryBillRequest()
    req.set_ProductCode("dashscope")
    req.set_BillingCycle(cycle)
    resp = client.do_action_with_exception(req)
    bill_data = json.loads(resp)
    return bill_data

if __name__ == "__main__":
    bill_result = get_dashscope_bill("2026-09")
    print(json.dumps(bill_result,ensure_ascii=False,indent=2))
脚本可以查询百炼月度账单,实时监控消费,一旦接近预算阈值,及时调整调用策略。可以配置定时任务,每天自动运行该脚本,实现消费预警。
# 每天凌晨2点执行账单监控脚本
0 2 * * * python3 /root/dashscope_bill_check.py >> /root/bill_log.txt
六、总结
Qwen3.7‑Flash作为通义千问3.7系列高速经济型多模态模型,主打低延迟、高吞吐、低成本,支持256K上下文、图片基础识别、轻量工具调用,非常适合高并发标准化业务,例如批量图文提取、客服问答、文本分类、图片标签化、简易检索智能体。它的定位是业务流量底座,承接绝大多数简单请求,把Plus、Max等高成本模型留给少数复杂任务,这是多模型混合调度架构的核心思路。详情👉访问阿里云百炼大模型服务平台页面 了解。
选型核心原则是按需分配模型。业务请求量大、任务逻辑简单,包含基础图片识别需求,优先选用Qwen3.7‑Flash;图文任务存在复杂图表、深度分析需求,切换Qwen3.7‑Plus;纯文本超长深度推理、大型代码工程场景使用Qwen3.7‑Max。开发者可以先使用免费额度完成原型验证,测试图文提取效果,确认满足业务需求,再结合按量计费、资源包、订阅套餐搭配使用。
整套接入流程简单清晰,只需要完成账号开通、密钥创建、API接口开发,即可快速将多模态能力集成到应用、轻量智能体、批量文档处理系统中。同时借助CLI命令、Python监控脚本,持续监控Token消耗、账单情况,设置告警机制,规避计费风险。项目迭代过程中,优化提示词、开启上下文缓存、前端压缩图片、搭建模型路由策略,持续降低调用开销。
无论是个人开发者搭建轻量图文问答工具,还是企业落地高并发线上客服、批量图文素材处理系统,Qwen3.7‑Flash都是控制整体AI调用成本的核心选择。在多模型分层调度体系中,由Flash承载绝大多数常规请求,高阶模型处理复杂任务,在响应速度、并发承载能力、调用成本三者之间实现最优平衡,支撑大规模AI业务稳定落地。


