
输入框旁边写着“最多 10 个字”,用户只输入了几个表情,计数却已经到 10。另一边,用数组展开代替 length 后,带肤色的手势仍被拆开,截断结果也改变了原来的含义。
问题往往出在“字”没有被定义。JavaScript 字符串长度、Unicode 码点数量、用户感知的字符数量,是不同的口径。本文用可运行的独立示例,解释如何选择计数单位,并在完整文本边界截断。
米米商聊的手机端产品资料确认动态可包含文字。这类文本入口为讨论计数规则提供了背景;本文不推断其客户端如何计数,也不公布或改写产品实际字数限制。下文代码、阈值和示意图均为独立教学设计。
1. 一个 length,不能回答所有“有多少字”的问题
MDN String.length 明确其单位是 UTF-16 码元。常用汉字或英文字母通常占一个码元,但 😀 占两个。
对合法 Unicode 文本,[...text] 按码点迭代,可以保留补充平面字符的代理对。它仍会拆开由多个码点组成的组合字符和表情序列。
这里采用字素簇作为更接近用户感知字符的计数单位。Unicode UAX #29 定义文本分段边界,也说明字素簇与具体字形呈现并不完全相同。因此,“一个字素簇”不等于“一定显示成一个图案”,更不等于“占一格宽度”。
| 合成样例 | UTF-16 码元 | 码点 | 本次环境的字素簇 |
|---|---|---|---|
中 |
1 | 1 | 1 |
😀 |
2 | 1 | 1 |
e\u0301,e 后接组合重音 |
2 | 2 | 1 |
👍🏽,手势加肤色修饰符 |
4 | 2 | 1 |
🇨🇳,两个区域指示符 |
4 | 2 | 1 |
👨👩👧👦,包含零宽连接符的家庭序列 |
11 | 7 | 1 |
表中的结果已在本次 Node.js 环境执行核对。不同运行时携带的 Unicode 分段数据可能不同;具体表情是否合并显示,也受字体和渲染环境影响。
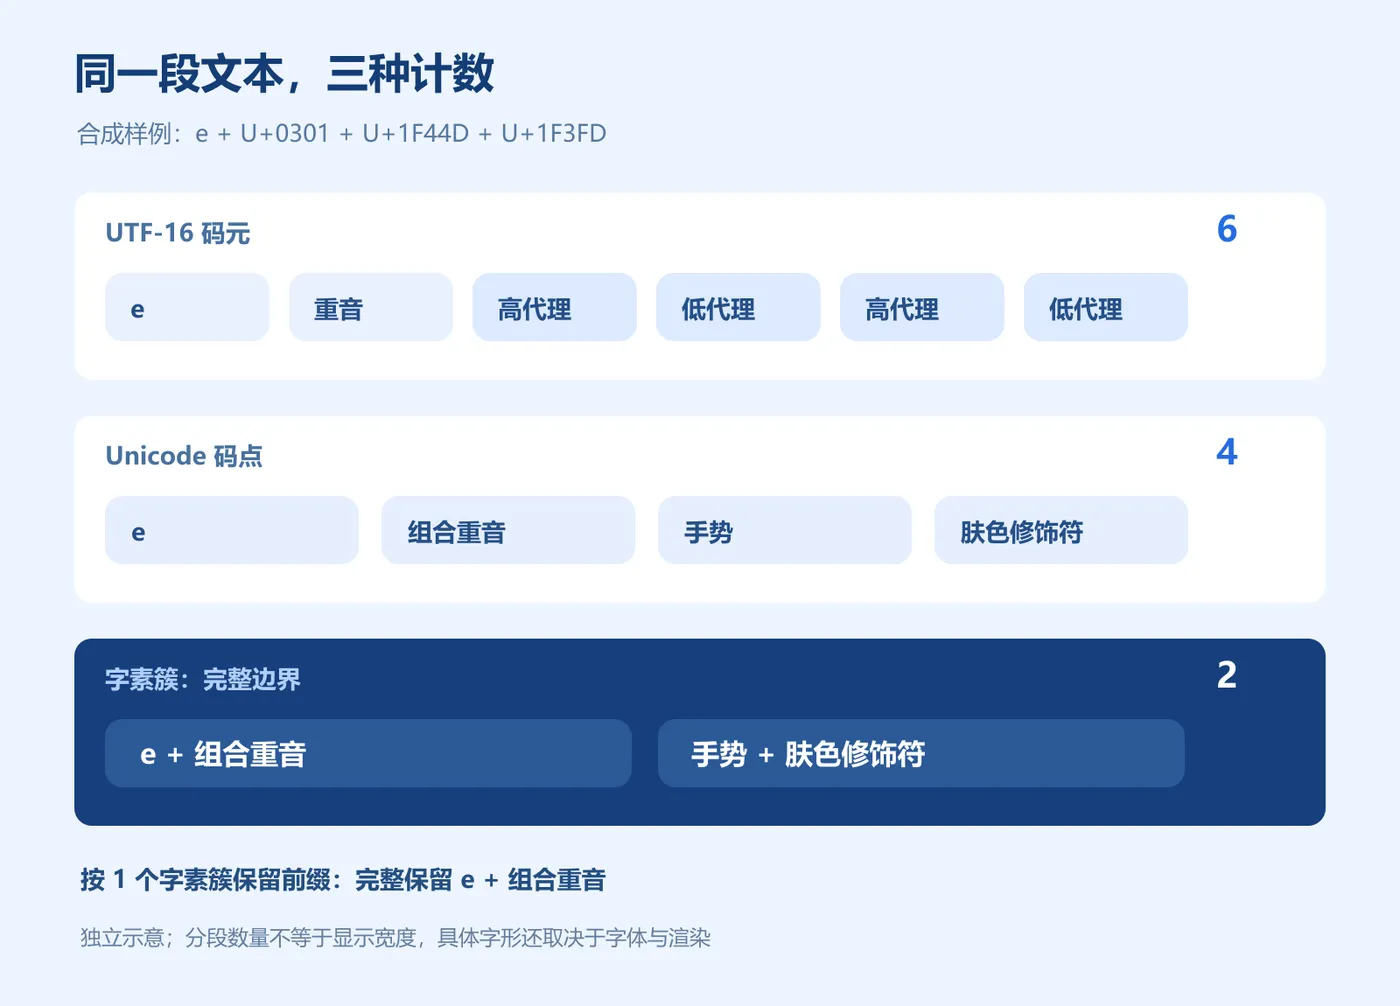
图:对 e\u0301👍🏽 分别计数,结果为 6 个 UTF-16 码元、4 个码点、2 个字素簇。此图为独立技术示意,不是产品界面。
2. 两种直接截断为什么都可能有问题
"😀".slice(0, 1) 会留下半个代理对,结果已经不是完整的 Unicode 字符。后续编码或展示可能替换、拒绝或改变这个值。
[..."👍🏽"].slice(0, 1).join("") 保留了合法码点,但结果是 👍,肤色修饰符丢失。对 e\u0301 做同样处理,结果变成 e,重音被移除。码点完整不代表字素簇完整。
需要保留用户感知字符边界时,可以使用 Intl.Segmenter,并明确指定 granularity: "grapheme"。词分段和句分段是另外两种任务,不能混用来统计字符。
还有一个容易被忽略的前提:JavaScript 字符串本身允许孤立代理项。String.isWellFormed() 用于检查这类情况。本例选择拒绝不完整输入,而不是悄悄替换后继续保存;实际产品应明确自己的修复或拒绝规则。
3. 按字素簇保留前缀的独立实现
本例只处理纯文本,返回完整前缀、保留的字素簇数量,以及是否截断。它不添加省略号、不去除空白、不改变换行,也不自动规范化原文。
为避免“一个字素簇内堆积大量组合符”绕过资源预算,本例另设最多 20000 个 UTF-16 码元;字素簇上限接受 0 至 1000 的整数。这两项是教学阈值,不是产品限制或通用安全数值。字符串进入函数之前,接口层仍需控制请求体大小。
if (typeof Intl.Segmenter !== "function" ||
    typeof String.prototype.isWellFormed !== "function") {

  throw new Error("Required text APIs are unavailable");
}

const segmenter = new Intl.Segmenter("zh", {

  granularity: "grapheme",
});
const MAX_CODE_UNITS = 20000;

function requireText(text) {

  if (typeof text !== "string") {

    throw new TypeError("text must be a string");
  }
  if (text.length > MAX_CODE_UNITS) {

    throw new RangeError("text exceeds the code-unit budget");
  }
  if (!text.isWellFormed()) {

    throw new TypeError("text contains a lone surrogate");
  }
}

function countGraphemes(text) {

  requireText(text);
  let count = 0;
  for (const part of segmenter.segment(text)) count += 1;
  return count;
}

function clipGraphemes(text, limit) {

  requireText(text);
  if (!Number.isInteger(limit) || limit < 0 || limit > 1000) {

    throw new RangeError("limit must be an integer from 0 to 1000");
  }
  let kept = 0;
  for (const part of segmenter.segment(text)) {

    if (kept === limit) {

      return {
    text: text.slice(0, part.index),
               kept, truncated: true };
    }
    kept += 1;
  }
  return {
    text, kept, truncated: false };
}
part.index 是原字符串中的 UTF-16 起始位置,正好可以交给 slice。算法不是按任意码元切割,而是先找分段边界,再截取原文。多观察到一个分段才知道确实有内容被去掉;刚好达到上限时不应误报截断。
kept 表示保留数量,不是原文总数量。若需要“原文当前多少字”的计数,应单独调用 countGraphemes。它会遍历完整文本;截断函数则在发现第一个超额分段后返回。本例没有做大文本性能基准。
运行第二段示例前,先执行上述函数定义:
const mixed = "e\u0301👍🏽";
console.assert(mixed.length === 6);
console.assert([...mixed].length === 4);
console.assert(countGraphemes(mixed) === 2);

const clipped = clipGraphemes(mixed, 1);
console.assert(clipped.text === "e\u0301");
console.assert(clipped.kept === 1 && clipped.truncated);
console.assert(clipped.text.isWellFormed());

const exact = clipGraphemes("👍🏽", 1);
console.assert(exact.text === "👍🏽");
console.assert(exact.kept === 1 && !exact.truncated);

console.assert("😀".slice(0, 1).isWellFormed() === false);
console.assert([..."👍🏽"].slice(0, 1).join("") === "👍");
console.assert(clipGraphemes("", 0).truncated === false);
console.assert(clipGraphemes("中", 0).truncated === true);
console.assert(countGraphemes("\r\n") === 1);
最后一条特意保留换行边界:本次规则把 CRLF 分为一个字素簇。空格、换行和独立的组合符也可能形成分段,所以这里的数量不是“可见汉字数量”。排除空白或标点是另一套业务规则,需要单独定义。
4. 输入框显示计数,原生 maxlength 却是另一种口径
MDN maxlength 说明原生上限使用 UTF-16 码元。把 maxlength="10" 配上“最多 10 个字素簇”的说明,会产生口径冲突:十个单码点笑脸本身就需要二十个码元,带修饰符或连接符的序列还可能更长。
不能靠把上限乘二解决所有情况,一个字素簇可以包含多个码点。可以将较宽的码元预算作为独立的资源限制,再按字素簇提供业务提示;两个限制都应让用户能够理解,不应把资源拒绝错误伪装成“字数超限”。
中文输入法、候选字选择和其他组合输入也需要独立处理。compositionend 表示组合输入会话完成或取消。若在组合过程中每次收到输入事件就重写文本,可能破坏用户尚未完成的输入。
本文建议组合过程中暂缓破坏性的裁切,待组合结束并取得最终值后重新核验;具体事件次序、光标恢复和受控组件更新仍需在目标浏览器与真实输入法测试。这里没有提供或声称已验证完整输入控件。
摘要展示和编辑输入也不应共用同一处理动作:展示摘要可以生成截断副本,保存时则要明确是报错、请求用户修改,还是允许有提示地裁切。不要让纯函数的默认选择直接决定用户原文是否被覆盖。
5. 分段、规范化和后端校验要约定一致
预组合的 é 与 e\u0301 在本次环境中都各算一个字素簇,但二者的码元、码点和字节表示仍不同。String.normalize() 提供不同规范化形式;字素簇计数本身不意味着已经统一了字符串表示。
是否采用 NFC、在哪个阶段采用、是否保留原始文本,必须由业务约定。规范化后索引也可能改变,不能拿规范化字符串的分段位置切原始字符串。本例始终在原文上分段并返回原文前缀。
| 需要回答的问题 | 建议明确的单位或规则 |
|---|---|
| 输入框对用户提示多少字符 | 字素簇及空白、换行等计入规则 |
| JavaScript 索引与 slice 位置 | UTF-16 码元位置 |
| 网络请求、数据库存储是否超预算 | 具体编码后的字节及请求体限制 |
| 两段文本是否按业务视为相同 | 规范化、比较和原文保留策略 |
| 前端通过而后端为何拒绝 | 相同分段规则、版本、规范化顺序和阈值 |
前端提示不能替代后端校验。不同语言的字符串长度 API 可能使用不同单位;双方即使都叫“字符数”,也需要共享规则和测试样本。分段数据随运行时更新,若要求严格一致,应固定或约定规则版本,并用相同样本核对双方结果。
对富文本、平台自定义表情、提及节点和附件描述,先定义计数对象再应用规则。把 HTML 源字符串送入纯文本函数,会连标签一起统计;把显示宽度等同于字素簇数量也会产生另一类错误。
6. 本次实际验证与适用范围
本次运行环境为 Node.js v24.19.0、ICU 78.3、Unicode 17.0;从文章原样提取两个 JavaScript 代码块并执行,另完成 18 类本地验证。覆盖普通文本、补充平面字符、组合重音、肤色修饰符、旗帜、连接符序列、键帽、CRLF、空值、零上限、恰好上限、非法输入、孤立代理项与资源预算等情形。
组合样本还验证了返回值始终是原文前缀、位于原输入的分段边界,且不会生成孤立代理项;计数与截断标记按本例约定一致。带大量组合符的单个字素簇也验证了独立码元预算,说明“只限制字素簇数量”并不能限制全部资源消耗。
验证范围是本地纯函数及合成文本,不包括产品客户端、目标浏览器的输入控件、真实输入法、字体呈现、服务接口、跨语言后端或性能基准。
创作说明:本文由 AI 辅助阅读官方技术资料、起草和制作示意图;独立代码与本地验证由 AI 编写并执行。产品背景仅采用已有手机端资料,示例不代表产品内部实现。
参考资料:


