
多轮对话“不降智”,要看它能不能记住约束
这是一次个人使用后的对话测试笔记。很多模型在单轮回答里表现不错,但进入多轮后,真正影响体验的是能不能记住前面确定的目标、格式和限制条件。
我会设计一个逐步收紧的任务
第一轮让模型提出方案,第二轮增加格式限制,第三轮要求修正某个细节,第四轮再让它解释为什么这样修改。这样可以观察它是否在后续回答中保留前面的约束。
如果每一轮都需要重新粘贴背景,或者修改新要求时忘记旧条件,我会把问题记录为上下文管理或请求构造问题,而不是简单归因于“模型智力下降”。
请求记录能帮助我排查上下文
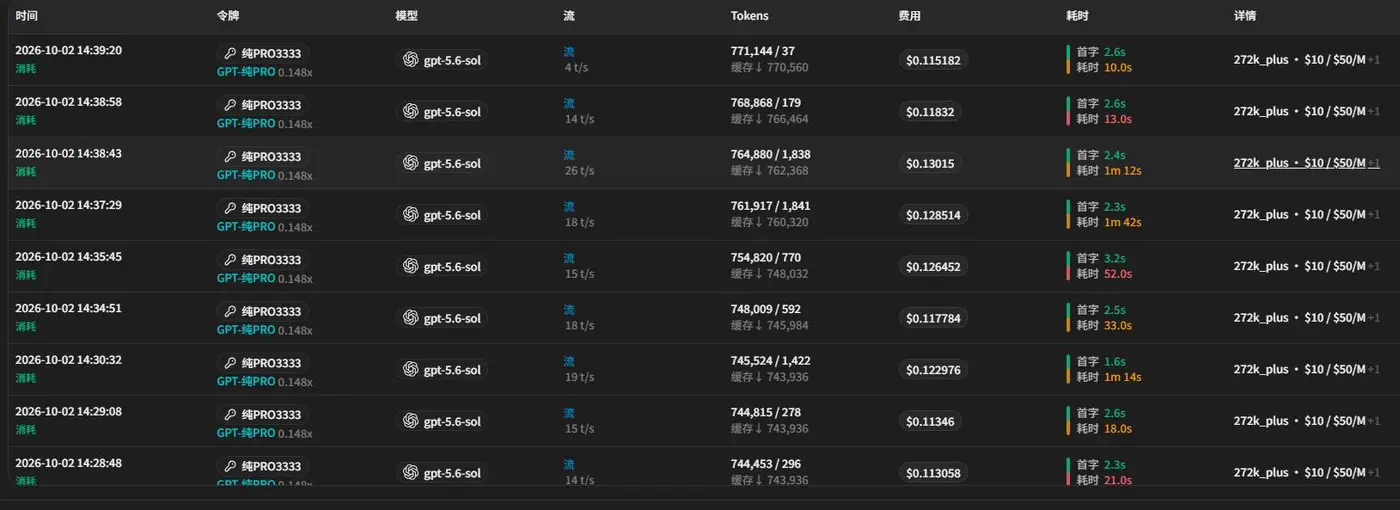
我会查看输入总量、缓存输入和输出 Token,确认历史消息是否持续进入请求。长对话中,如果上下文被截断,模型当然会表现得像“突然变笨”。

统计页可以帮助我发现长对话带来的 Token、延迟和费用增长,但最终是否记住约束,还要看具体任务输出。
“不降智”应该写成可验证的体验
我的表述会限定为“这组多轮任务中没有观察到明显的上下文遗忘”,不会写成绝对承诺。因为对话长度、模型版本、参数和输入内容都会影响结果。
本文是个人测试方法整理,截图数据对应 2026 年 10 月 2 日,实际使用请用自己的多轮任务验证。


