
记忆增强智能体按「对任务的效果」决定留哪条记忆——但效果估计完全依赖「被检索到」。从未被检索的记忆,删了和留着结果一模一样,它的真实效用永远无法被现有方法识别。这篇论文用因果干预框架解决这个「检索层正性违反」:对检索动手而非对存储动手,让每条记忆的效用变得可识别。
arXiv · 2026-10-01
arXiv 2610.02070 · Causal Memory Policy: Making Memory Utility Identifiable by Intervening on Retrieval · 2026-10-01 · 伊利诺伊理工
问题:从未被检索的记忆,效用无法识别
记忆增强智能体的核心决策是「留哪些记忆」。主流方法:估计每条记忆对任务表现的影响,按影响排序淘汰。
但这里有个结构性盲点:效用估计完全依赖被检索到的记忆。一条记忆如果从未被检索(查询词没匹配上、排序靠后),它的存在与否对任务结果没有任何影响——你删掉它,指标纹丝不动。
于是「删了没影响」被误读为「没有价值」。但真实情况可能是:它只是没被给过机会。一条存对了但检索词不巧错开的记忆,和一条真的垃圾记忆,在现有指标下不可区分。这在因果推断里叫正性违反(positivity violation)——干预的某个取值从未被观察到,效果就无法识别。
方法:对检索干预,不对存储干预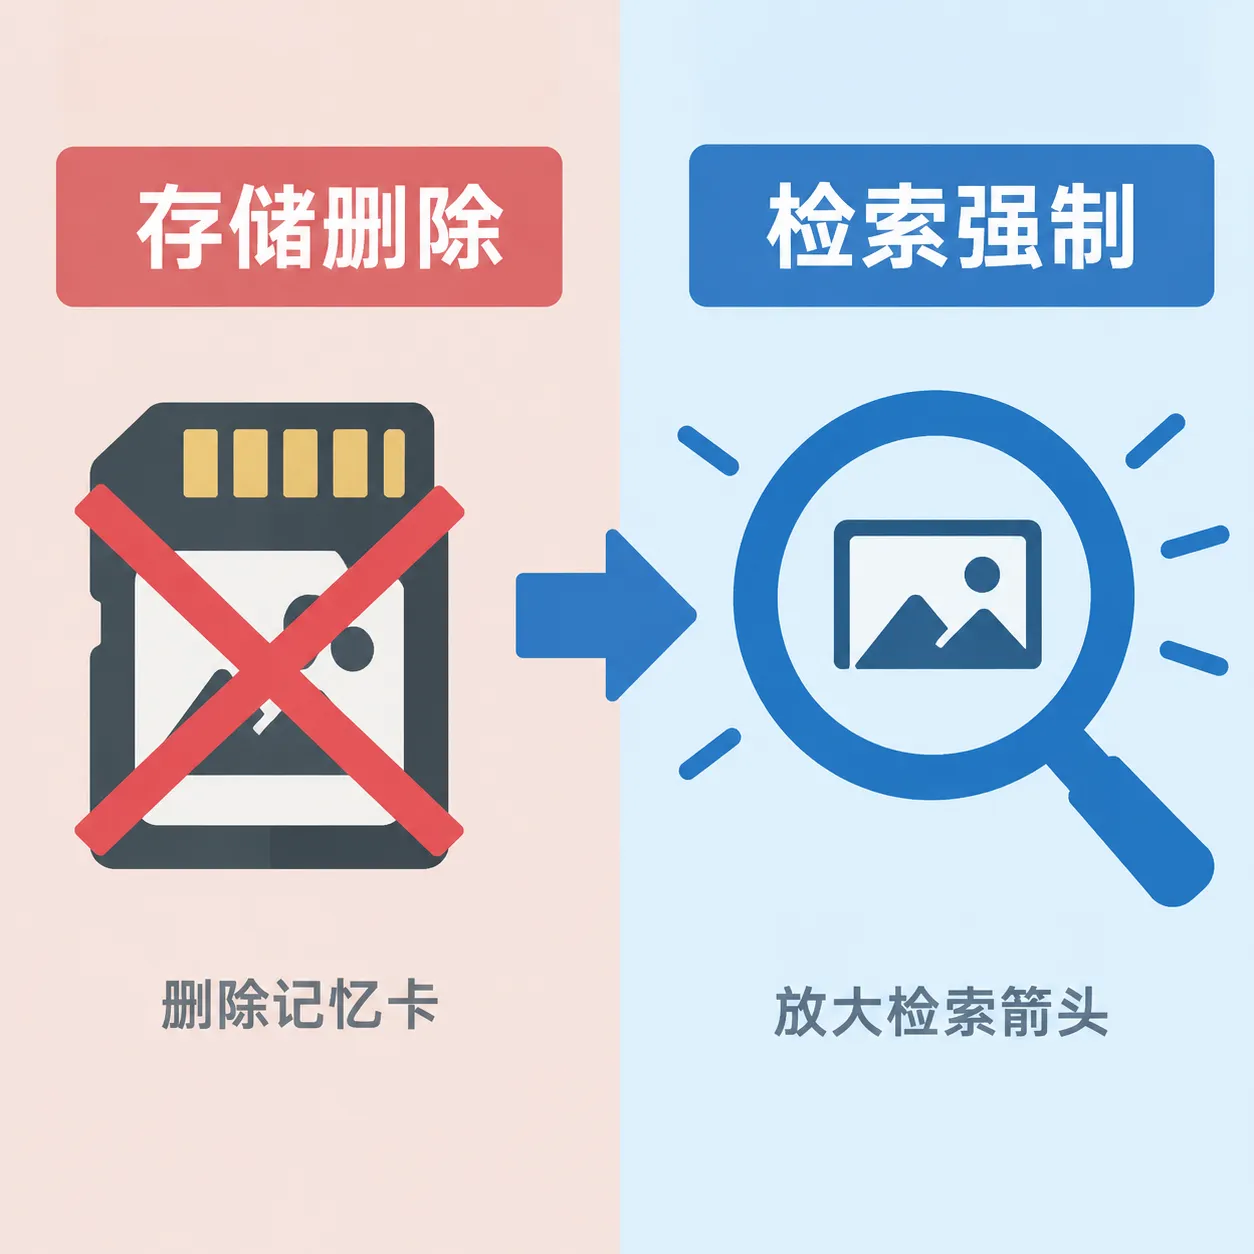
论文提出 CMP(Causal Memory Policy)——把记忆增强智能体形式化为结构因果模型(SCM),检索是记忆与任务效果之间的中介变量。
关键转换:现有方法对存储做干预(删这条记忆看效果变化)——对从未被检索的记忆,这个干预是空操作。CMP 对检索做干预——强制做一次「若不检索 vs 检索」的对照:
- 不是「删掉这条记忆会怎样」(对未检索记忆无效) - 而是「强制检索这条记忆会怎样」(对任何记忆都能测出效果)
通过对检索中介的干预,恢复了记忆效用的因果分解——包括那些从未自然参与过任务的记忆。估计量还满足无偏性(论文给出了形式化论证)。
这个问题为什么真实存在
一个直白的场景:用户问「怎么配置定时任务」,记忆库里有条写得极好的定时任务指南,但它的标签词是「cron 调度」——检索词没对上,这条记忆从未被召回。运行十次任务,它从未出现。 - 现有系统:删了没影响(从未被用到)→ 被清理 → 永远丢失 - CMP:强制检索一次做对照 → 发现它其实写得很好 → 保留并调整检索映射
「从未被用到」和「没用」是两件事——这就是检索层正性违反的实践含义。而且这类问题在记忆库变大后更严重(条目越多,单条被检索的概率越低,「从未被检索」的池子越大)。
为什么值得读
- 把记忆管理的盲点形式化了——「未检索记忆的效用不可识别」从直觉变成有名字的因果缺陷(正性违反),这是能引用的概念 2. 干预对象的转换很妙——从「对存储动手」转为「对检索动手」,一步之差解决了结构性盲点 3. SCM 形式化的红利——因果框架给了无偏性论证,不是启发式修补 4. 与记忆系统实践直接相关——任何做记忆清理/淘汰的系统都应该检查:你的清理规则是否会把「没被给过机会的好记忆」误杀
与 BuddyMe 的经验印证
BuddyMe 的经验循环把每版决策与产物落盘,记忆条目保留完整检索轨迹(哪条记忆被哪些任务召回过)——这正好是 CMP 式干预需要的数据基础:知道哪些记忆从未被检索,才能对它们做定向对照。我们做记忆分层时发现过同款问题:表面「零引用」的记忆,强制召回测试后质量很高——只是检索词没对上。CMP 的贡献是把这种经验直觉形式化成了因果框架。每天免费 4500 万 token,够对长尾记忆池跑完整的对照评估。
BuddyMe 每日免费 4500 万 Token。


