自动标注实战:X-AnyLabeling、autodistill 与 Grounded-SAM 全流程
还在用 LabelImg 一张张手拉框、手写脚本转 VOC/COCO?
现在开源社区已经有成熟方案:基础模型预标注 → 人工审核 → 平台管理 → 数据飞轮。标注从“体力活”变成“审核活”,效率提升一个量级。
本文按实际操作顺序介绍现代标注工作流:预标注 → 审核 → 导出 → 训练 → 回灌,并给出 X-AnyLabeling、autodistill、Grounded-SAM 的用法与选择建议。
系列导航:标注完数据后训练可参考《车牌识别实战》,提升检测效果可参考《小目标检测实战》,部署上线可参考《检测模型部署成 Web 服务》。

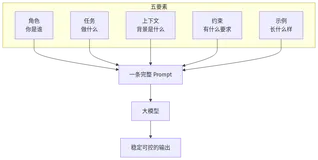
图 1:数据飞轮四步循环——预标注 → 审核 → 导出训练 → 模型回灌,越往后人工介入越少。
一、现代标注工作流:核心是"数据飞轮"
传统做法是“人工逐张标注”。现代做法是模型预标注、人工审核,形成四步循环:
| 步骤 | 做什么 | 工具 |
|---|---|---|
| 预标注 | 用基础模型自动生成框或掩码 | X-AnyLabeling、Grounded-SAM |
| 审核 | 人工只负责修正和补漏 | X-AnyLabeling 工作区 |
| 导出训练 | 导出为训练格式,训练一个小模型 | 平台导出 + YOLO |
| 模型回灌 | 用训练好的小模型预标注下一批 | X-AnyLabeling 加载自有模型 |
关键转变:人工从"画每一个框"变成"改模型给的框"。一个熟练标注员,手标 100 张要几小时;审核模型预标注的 100 张只要几十分钟,而且越往后越准——这就是"数据飞轮"。
二、X-AnyLabeling:把基础模型接进标注界面
这是目前较主流的开源方案之一,定位为AI 驱动的跨平台标注应用,将“模型预标注 + 人工审核”整合在同一个界面中。
核心能力:
- 模型库:内置 100+ 个模型配置,覆盖 YOLO、SAM、DINO、Qwen、PPOCR 等系列;
- 推理后端:本地跑(ONNX Runtime、TensorRT、OpenCV DNN、PyTorch),也可以连远程服务(SGLang、vLLM、TGI);
- 导出格式:COCO、VOC、YOLO、DOTA、MOT、MASK、PPOCR、MM-Grounding、ShareGPT 等——格式转换由平台负责,无需自行编写脚本;
- 任务覆盖:分类、检测、分割、姿态估计、跟踪、OCR、文档解析、视频分类、图像描述等;
- 标注形状:多边形、矩形、旋转框、圆形、线条、点、掩码。
典型用法:安装完成后 → 选择预训练模型(或接入自有模型)→ 一键预标注 → 在工作区中审核修正 → 导出为 YOLO/COCO 格式 → 进行训练。
相比传统工具的优势:传统工具(如 LabelImg)通常只提供“画框”功能,模型推理需要在另一处完成。X-AnyLabeling 将两者整合,审核与预标注在同一界面内完成,无需在工具间来回切换。
三、三种预标注方式,按场景选
不是所有预标注都一样。三种方式,对应三种需求:
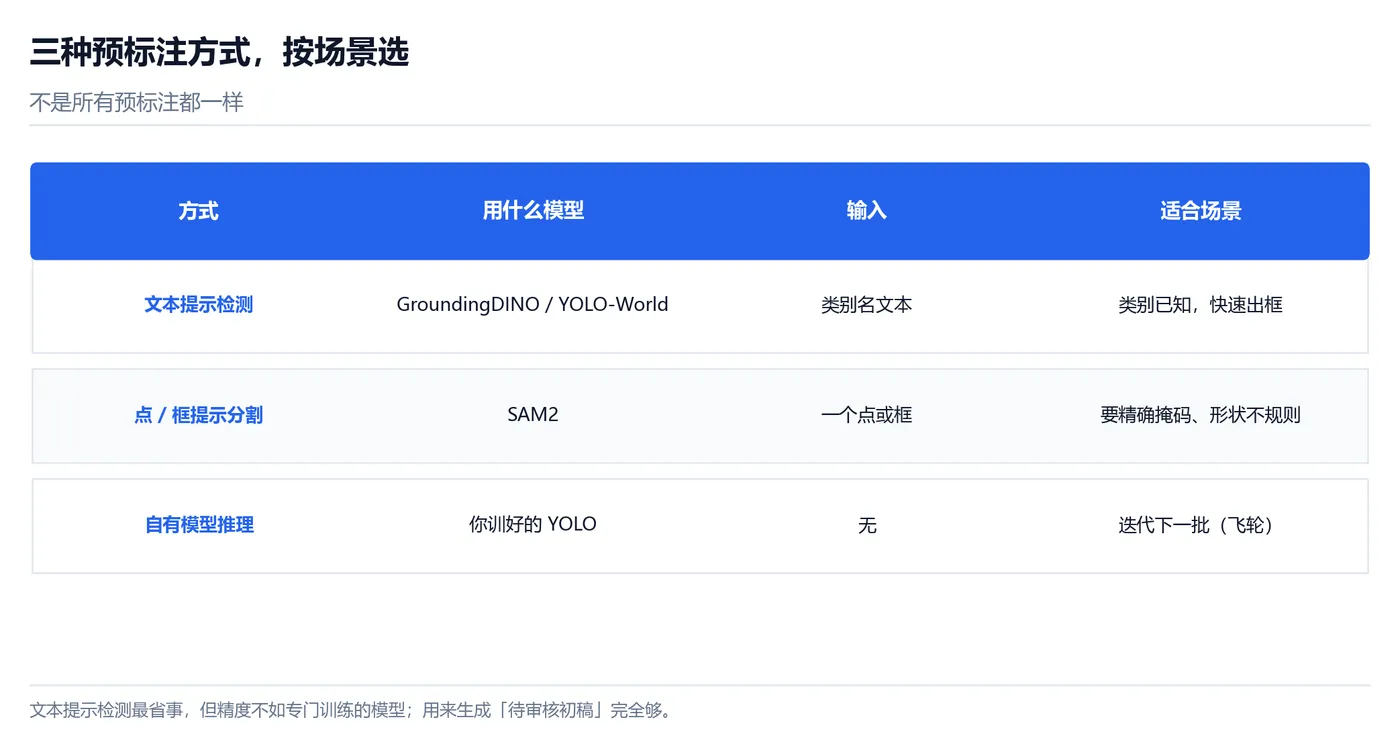
图 2:三种预标注方式对比——文本提示检测、点/框提示分割、自有模型推理,按场景选择。
| 方式 | 用什么模型 | 输入 | 适合场景 |
|---|---|---|---|
| 文本提示检测 | GroundingDINO / YOLO-World | 类别名文本 | 类别已知,要快速出框 |
| 点 / 框提示分割 | SAM2 | 一个点或一个框 | 要精确掩码、形状不规则 |
| 自有模型推理 | 你训练好的 YOLO | 无(直接推理) | 迭代下一批数据(飞轮) |
文本提示检测最省事:不用准备任何标注,直接写类别名(比如 "safety helmet"、"license plate"),模型就能框出画面里对应的目标。代价是精度不如专门训练的模型,但用来生成“待审核的初稿”完全够。
点 / 框提示分割适合需要掩码的场景:在目标上点一下,SAM2 就能给出精确轮廓,比手描多边形快得多。
自有模型推理是飞轮的关键:当你有了一批审核好的数据和训练好的模型,用它去预标注下一批,精度比通用基础模型高得多。越往后,人工需要修改的越少。
四、autodistill:零手动标注,用基础模型蒸馏小模型
如果目标是“训练一个能在边缘或低配设备上运行的小模型”,autodistill 是更彻底的方案——它用大而慢的基础模型自动生成标注,再训练一个小而快的监督模型,全程不需要人工标注。
# pip install autodistill autodistill-grounded-sam autodistill-yolov8
from autodistill.detection import CaptionOntology
from autodistill_grounded_sam import GroundedSAM
from autodistill_yolov8 import YOLOv8

# 1) 用文本描述定义类别(ontology:描述 -> 类别名)
ontology = CaptionOntology({

    "safety helmet": "helmet",
    "worker head without helmet": "no_helmet",
})

# 2) 基础模型(GroundedSAM = GroundingDINO + SAM)自动标注
base_model = GroundedSAM(ontology=ontology)
dataset = base_model.label(input_folder="./unlabeled", extension=".jpg")

# 3) 用自动标注好的数据训练一个小模型
target_model = YOLOv8("yolov8n.pt")
target_model.train(dataset, epochs=100)
它的价值:把"基础模型的泛化能力"蒸馏进"小模型的推理速度"。基础模型跑得慢但什么都认识,小模型跑得快,但只会识别你训练过的类别——autodistill 把两者接起来。
必须注意的边界:
- 自动标注 ≠ 免审核。 基础模型会漏标、会错类。autodistill 生成的标注至少要抽样审核一遍,尤其是稀有类;
- ontology 的描述词很关键。 写
"car"和写"vehicle"召回的目标不一样。描述要贴近目标实际外观; - 类别不能太细。 基础模型对"语义级"的类(人、车、头盔)识别好,对"像素级"的细分类(塑料瓶 vs 玻璃瓶)识别差。细分类要靠自己补数据训练。
具体 API 与包名以 autodistill 官方文档为准,不同基础模型/目标模型的组合对应不同的插件包。
五、数据集平台怎么选
预标注之外,还需要"数据集管理"——版本、审核、统计、找问题样本。主流平台各有侧重:
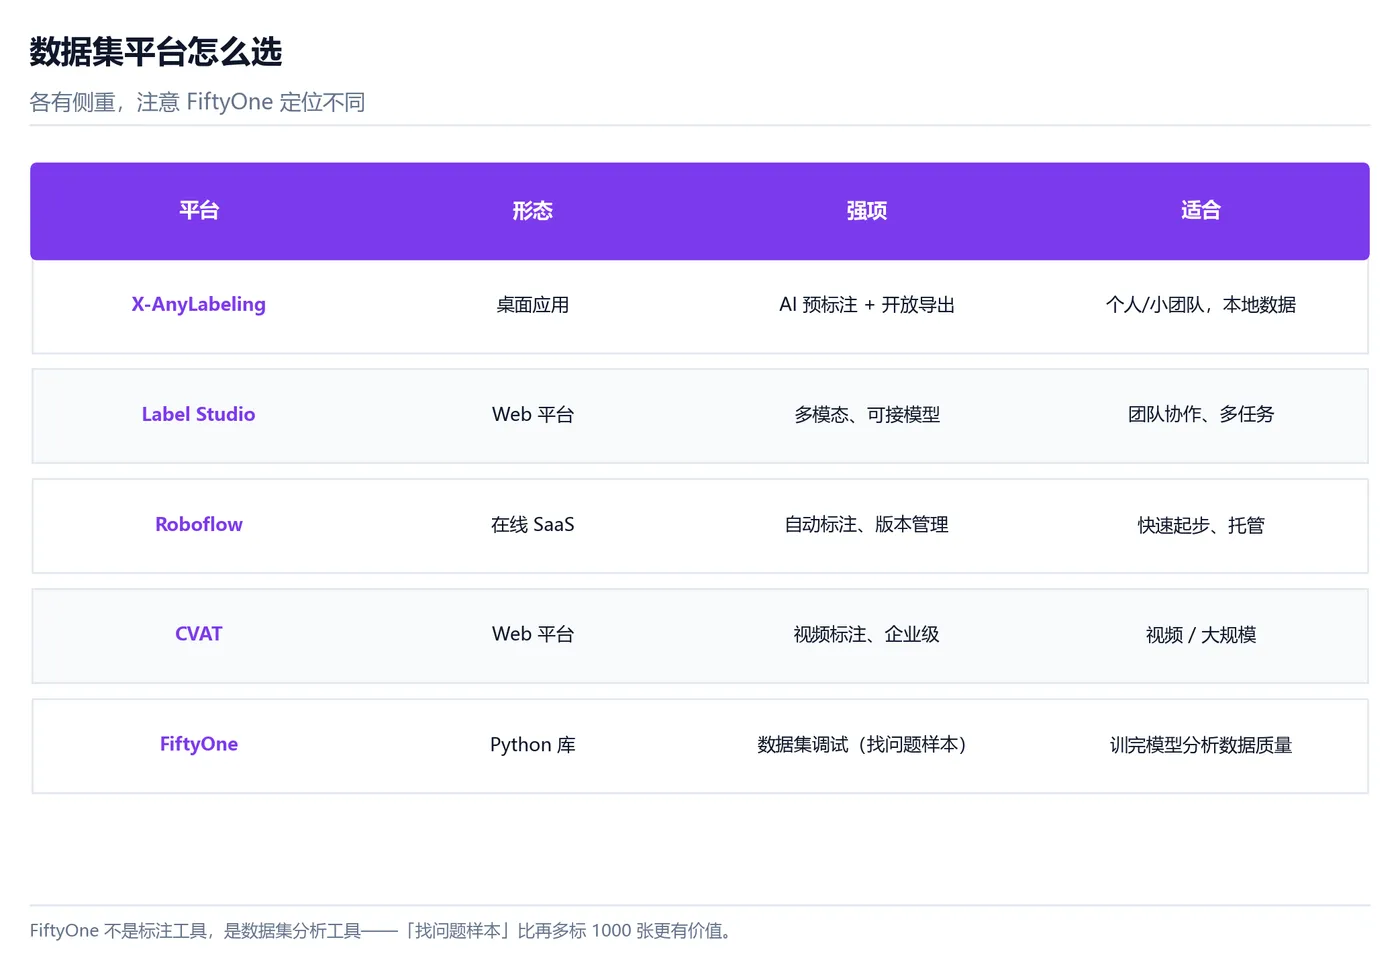
图 3:主流数据集平台对比——X-AnyLabeling、Label Studio、Roboflow、CVAT、FiftyOne 各有侧重。
| 平台 | 形态 | 强项 | 适合 |
|---|---|---|---|
| X-AnyLabeling | 桌面应用 | AI 预标注 + 开放格式导出 | 个人/小团队,本地数据 |
| Label Studio | Web 平台 | 多模态、ML backend 可接模型 | 团队协作、多任务类型 |
| Roboflow | 在线 SaaS | 自动标注、版本管理、一键导出 | 快速起步、要托管 |
| CVAT | Web 平台 | 视频标注、企业级 | 视频/大规模标注 |
| FiftyOne | Python 库 | 数据集调试(找问题样本、可视化) | 已训练完模型,要分析数据质量 |
注意 FiftyOne 的定位不同:它主要不是"标注工具",而是数据集分析工具——用来看"哪些样本模型错得最多""类别分布长什么样""有没有重复"。“找问题样本”这个能力,往往比再多标注 1000 张图更有价值。
选择建议:个人做毕设/小项目,用 X-AnyLabeling(本地、免费、AI 预标注强)就够;要团队协作和多模态任务,上 Label Studio;要托管和版本管理,用 Roboflow;模型训练完了想分析数据质量,用 FiftyOne。
六、审核不能省:预标注的三种坑
自动标注把效率提上去了,但审核这一步绝不能省。三种典型问题:
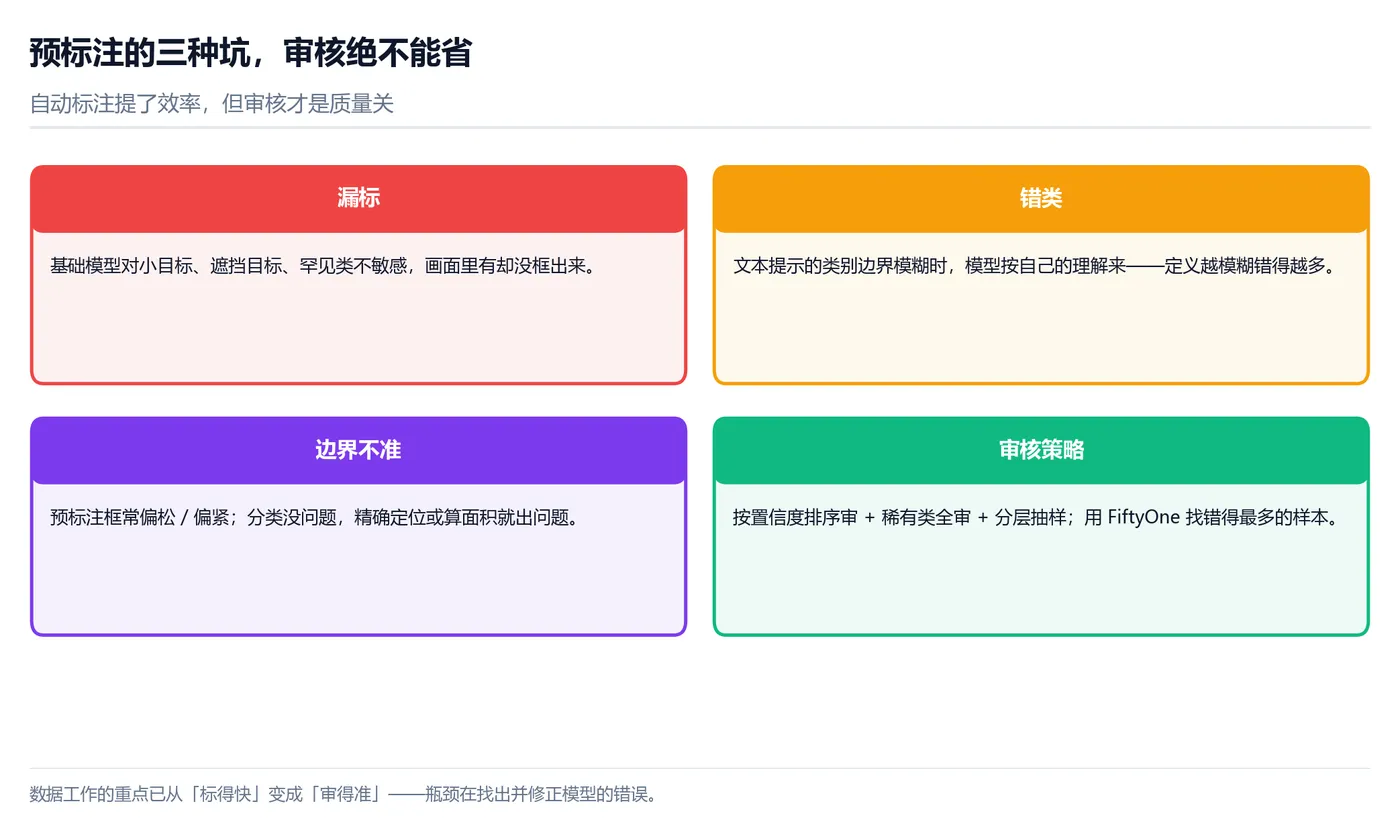
图 4:预标注常见问题——漏标、错类、边界不准,审核时需针对性排查。
坑一:漏标。 基础模型对某些类不敏感(尤其小目标、遮挡目标、罕见类)。表现是"画面里明明有,但没框出来"。抽查时要专门找这类漏标。
坑二:错类。 文本提示的类别边界模糊时(比如 "helmet" 到底包不包括工地的遮阳帽),模型会按自己的理解来。类别定义越模糊,错类越多。
坑三:边界不准。 预标注的框常常"偏松"或"偏紧"。用于分类没问题,用于精确定位或算面积就会出问题。
审核策略(按效率排序):
- 按置信度排序审核:优先审低置信度的,高置信度的抽查。多数预标注工具支持按分数排序;
- 分层审核:稀有类全审,大类抽查;
- 专项审核:这一轮专门查漏标,下一轮专门查错类,比一次什么都查更高效;
- 用 FiftyOne 找问题样本:把模型训练完,用 FiftyOne 找出“模型错得最多”的样本,这些才是最该补标注或重新标注的。
七、卡住时的排查顺序
- 预标注结果全是空的 → 检查模型是否加载成功、ontology 描述词是否太生僻;
- 漏标多 → 换更强的检测模型,或对漏标的类单独用自有模型预标注;
- 错类多 → 回到类别定义,把描述词写具体(加限定词);
- 掩码不准 → 分割任务换 SAM2,或改用点/框提示而不是文本提示;
- 导出格式对不上 → 用平台自带的导出,别自己写转换脚本(这就是老做法);
- 训练完效果差 → 用 FiftyOne 找问题样本,优先补标模型错得最多的那批。
一个必须转变的观念:数据工作的重点,已经从“标得快”变成“审得准”。 预标注让“标注”不再是瓶颈,瓶颈变成了“怎么高效地找出并修正模型的错误”。把审核策略和问题样本挖掘做扎实,比多标几千张图有价值得多。
最后一句:手拉框 + 手写格式转换脚本,已经被"基础模型预标注 + 平台审核 + 数据飞轮"取代。把精力从“标注数据”转到“审核数据”和“找问题样本”上,这才是现在拉开差距的地方。
说明:文中涉及的 X-AnyLabeling、autodistill、Grounded-SAM、SAM2、Label Studio、Roboflow、CVAT、FiftyOne 均为开源或公开可用的工具/平台,其功能、版本与 API 请以各自官方文档为准(本文成稿时 X-AnyLabeling 仍在活跃维护)。基础模型的自动标注结果必须经过人工审核后才能用于训练,尤其稀有类与小目标。各类阈值、ontology 描述与审核比例需结合自己的数据回归确认。