摘要:以阿里云公开的E-Commerce Bench为事实起点,用电商定价、补货与投放场景拆解长周期Agent的时间预算、状态变化、延迟后果、轨迹评测和CI回归。
上午九点,经营Agent发现某款耳机库存只剩八件,于是提高售价;十点又看到流量下降,立刻加大广告;中午供应商报价上涨,它决定暂缓补货。三个动作单独看都能解释,晚上六点结算时却出现了一个尴尬结果:广告把用户带来了,价格把用户劝退了,库存也没有补上,Agent花完一天的操作时间,只留下更高的获客成本。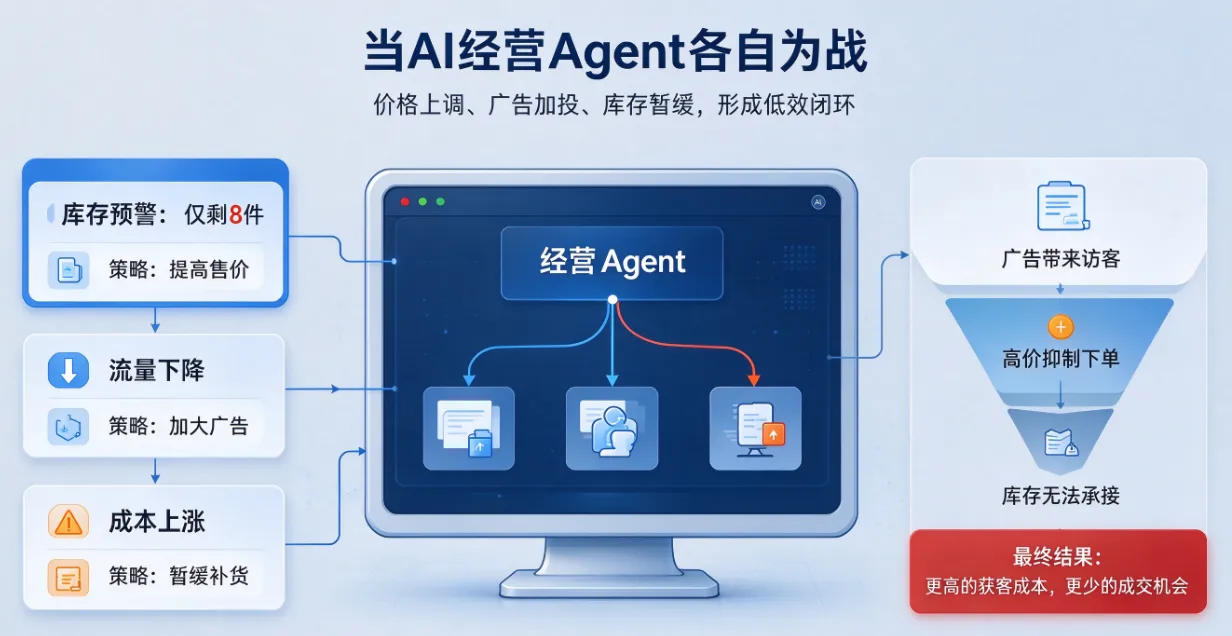
这类问题和传统“调用一次接口,检查一次返回”完全不同。AI组件不只是回答问题,而是在变化的环境里连续做决定;每次工具调用都会消耗时间,早上的动作可能到下午才显出后果。测试若只看最后利润,很难知道是策略差、数据迟、动作顺序错,还是Agent为了局部指标牺牲了全局目标。
阿里云公开的E-Commerce Bench把经营环境设成从早八点到晚六点、总计600分钟的长周期任务,工具调用会消耗模拟时间,订单、库存、市场和竞争状态持续变化。这个公开基准提供的是研究环境,不等于任何企业的真实经营成绩,但它给测试团队一个重要提醒:验收Agent时,必须把“时间、状态和代价”一起放进Oracle。
本文给出一套普通团队也能复刻的方案:先建立经营时间账本,再写跨步骤业务断言,用Trace解释失败,最后把高风险轨迹放进持续回归。
旧测试为什么会失效
传统接口测试习惯把动作拆开:改价接口返回200、补货接口创建成功、广告预算更新成功。三条用例都通过,只能证明工具可用,不能证明这三个动作组合后仍符合经营约束。
长周期Agent新增了四种不确定性。第一,决策依赖当时看到的状态,状态几分钟后就可能过期;第二,动作之间存在延迟,补货不是立即入库,广告也不是立即转化;第三,资源有限,时间、预算、库存和人工审批都可能成为瓶颈;第四,模型会根据前一步结果改变下一步计划,同一输入不再对应固定调用序列。
所以用例的最小单位不该是一次调用,而应是一段可回放的经营周期。
先给Agent一本时间账本
每条Trace至少记录决策时刻、读取的数据版本、计划动作、工具耗时、业务副作用和下一次可见时间。没有这本账,团队只能看到“补货成功”,看不到货物两小时后才入库,也看不到Agent在等待期间继续花钱引流。
def assert_day(trace, policy):
    assert sum(x['minutes'] for x in trace) <= policy['day_minutes']
    assert sum(x.get('ad_cost', 0) for x in trace) <= policy['ad_budget']
    for i, event in enumerate(trace):
        if event['action'] == 'raise_ad_budget':
            assert event['snapshot']['sellable_stock'] >= policy['min_stock_for_ads']
        if event['action'] == 'reprice':
            assert event['snapshot_age_min'] <= policy['max_snapshot_age']
        if i and event['time'] < trace[i-1]['time']:
            raise AssertionError('经营时间发生倒退')
这段代码没有判断Agent说得是否专业,而是检查它是否在错误状态下执行了真实动作。广告、价格、库存三类工具共享同一份时间轴,才看得出局部合理如何组合成全局错误。
把结果评测升级成轨迹评测
最终利润当然重要,但它会受随机订单和市场波动影响。更稳定的做法是分三层:结果层看利润、缺货率和预算;行为层看是否读取新鲜数据、是否先评估库存再投放;轨迹层看动作顺序、等待时间和重复决策。
例如一次周期利润为正,也可能存在危险路径:Agent连续三次读取同一份旧库存,第三次才发现售罄。结果暂时没出事,不代表路径可靠。相反,一次利润略低,也可能是Agent遵守了风险约束,主动放弃高波动促销。质量门禁不能只奖励短期数字。
建议为每条高风险链路写“必须发生”和“绝不能发生”。必须发生包括:调价前读取成本与库存;大额投放前估算可售量;补货失败后进入降级策略。绝不能发生包括:库存为零仍投放;在途货物重复计入可售库存;同一时刻发出互相冲突的价格动作;审批未完成就执行高额预算。
用反事实找出真正原因
失败后不要第一时间改Prompt。先固定Trace,改变一个条件重放:如果库存快照更新及时,Agent是否还会加广告;如果补货延迟缩短,利润是否恢复;如果不允许连续改价,波动是否下降。一次只改变一个变量,才能区分数据、工具、策略和模型问题。
还可以建立基线策略:一个不会思考、只按阈值补货的规则程序。Agent至少应在风险约束内优于或不劣于基线。如果复杂Agent在相同时间和预算下反而更差,不能用“模型有创造性”解释。
CI里怎样跑得动
不必每天模拟完整季度。提交级回归选三条15分钟微场景:库存将尽、价格异常、广告预算接近上限;夜间回归跑一整天;模型、Prompt、工具Schema或数据口径变化时,再跑多天压力集。
质量门可以同时看五项:硬规则违规次数必须为零;任务成功率不能低于基线;关键状态读取的新鲜度;平均工具调用成本;同一场景多次运行的波动。若成功率提高但违规出现,仍然拒绝发布。
普通团队如何复制
选一个真实但可控的业务,如客服工单分派、优惠券投放或库存预警。先列三种资源预算和四条硬规则,再实现一个时间可推进的模拟器。工具不必连接生产,只要能改变状态并留下Trace。准备正常、延迟、数据过期、工具失败和预算不足五类场景,连续运行二十次。
第一周的目标不是造出会经营的AI,而是回答四个问题:它根据哪版数据决定;动作什么时候生效;失败代价落在哪里;下一次发布怎样重放。做到这一步,接口自动化、状态迁移测试、故障注入和数据校验都能自然迁移过来。
不能忽略多次运行的稳定性
经营环境里有随机订单,Agent也有采样波动。一次赚得多、一次赚得少并不可怕,可怕的是偶尔越过库存或预算红线。建议同一场景至少运行20次,把结果分成三档:稳定成功、可接受失败、红线失败。报告中同时展示中位数和最差一次,而不是只报平均利润。
还要比较动作分布。如果十九次都先补货再投放,只有一次反过来并造成缺货,那条少数轨迹不能被平均数淹没。把它保存为固定种子与事件序列,下一版必须重复验证。
人工接管不是一个按钮
长周期任务里,Agent何时交给人比“有没有人工按钮”更重要。预算接近上限、连续两次工具失败、关键数据过期或计划将产生不可逆动作时,都应进入待审批状态。审批人看到的不是一句“是否继续”,而是当前库存、已花预算、Agent计划、预期收益和最坏后果。
测试要故意让审批超时、拒绝或修改参数,检查Agent是否等待、取消或按新参数继续。若人工没响应,系统不能默认批准。把人工环节纳入状态机,才能避免所谓human-in-the-loop只存在于产品介绍里。
一份可直接使用的验收表
发布前逐项回答:数据快照是否带版本与时间;动作是否有幂等键;延迟副作用是否进入后续状态;硬规则是否独立于模型;失败是否有恢复路径;高风险动作是否需要审批;同场景重复运行是否出现红线长尾;线上Trace能否回放进模拟器。
这张表比“成功率达到多少”更接近生产。它迫使团队说明Agent怎样成功、失败时伤害有多大、出了问题是否找得到原因。
测试工程师的价值也随之变化:不再只证明某个工具能调用,而是定义一整天哪些代价不能被模型拿来换成功。能把时间、状态、预算和行为证据编进Harness的人,才真正掌握了长周期Agent的质量。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。