摘要:
如果你刚开始接触大模型测评,AI 生成代码其实是一个很适合入门的场景。过去我们习惯看“代码能不能跑、测试能不能过”,但到了 Coding Agent 阶段,这两个标准已经不够了。真正需要验证的,还包括功能是否符合真实需求、AI 写出的测试是否可信、代码有没有超范围修改,以及最终产物是否符合项目本身的工程规范。
现在让 AI 写代码,已经不是什么新鲜事了。
以前可能只是让 ChatGPT 帮忙补一个函数、写段 SQL。
现在很多 Coding Agent 已经可以直接读整个代码库,然后自己:
修改文件、补测试、执行命令、发现失败、继续修复,最后告诉你:
Done。
对于测试工程师来说,一个很自然的问题也随之出现:
AI 都已经把测试跑完了,我们还要测什么?
比如一段 AI 生成的代码,最终显示:
20 passed
没有报错。
接口也能正常返回。
看起来是不是就可以合并了?
还真不一定。
最近 OpenAI 在评估 Coding Agent 时,已经不只关注“代码能不能解决问题”,而是开始关注一个更加工程化的标准:
这份代码到底能不能真正合进项目。
其中会涉及测试质量、改动范围、代码风格以及是否遵守现有代码库规范等问题。
这个变化对测试工程师其实非常值得关注。
因为以后面对 AI 写出来的代码,我们真正需要判断的,可能已经不只是:
有没有 Bug?
而是:
这到底是不是一份合格的软件工程产物?
第一件事:功能到底有没有做对?
这是最基础的一层。
比如需求是:
用户输入优惠券以后,重新计算订单金额。
AI 很快生成:
def apply_coupon(order, coupon):
    if coupon.valid:
        order.total *= 0.8

    return order
正常优惠券跑一下。
没报错。
金额也确实打了八折。
如果测试到这里就结束,这段代码当然看起来没什么问题。
但测试工程师真正该继续问的是:
优惠券过期怎么办?
同一张券能不能重复使用?
0 元订单怎么办?
优惠金额超过订单金额怎么办?
部分商品不参加活动怎么办?
订单已经取消以后还能不能使用优惠券?
这些问题和传统软件测试其实没有本质区别。
AI 写代码,并不会让边界条件自动消失。
甚至因为 AI 写代码速度越来越快,这件事反而更加重要。
AI 很擅长完成需求描述里明确告诉它的东西。
但需求文档里没有写清楚的那些角落,它未必真的理解了业务默认规则。
所以测 AI 代码的第一步仍然是:
不要只验证它有没有实现功能,还要验证它有没有真正理解需求。
第二件事:AI写出来的测试,也得被测试
这一点很容易被忽略。
现在的 Coding Agent 往往不是只写业务代码。
它甚至可以自己生成测试,然后自己运行。
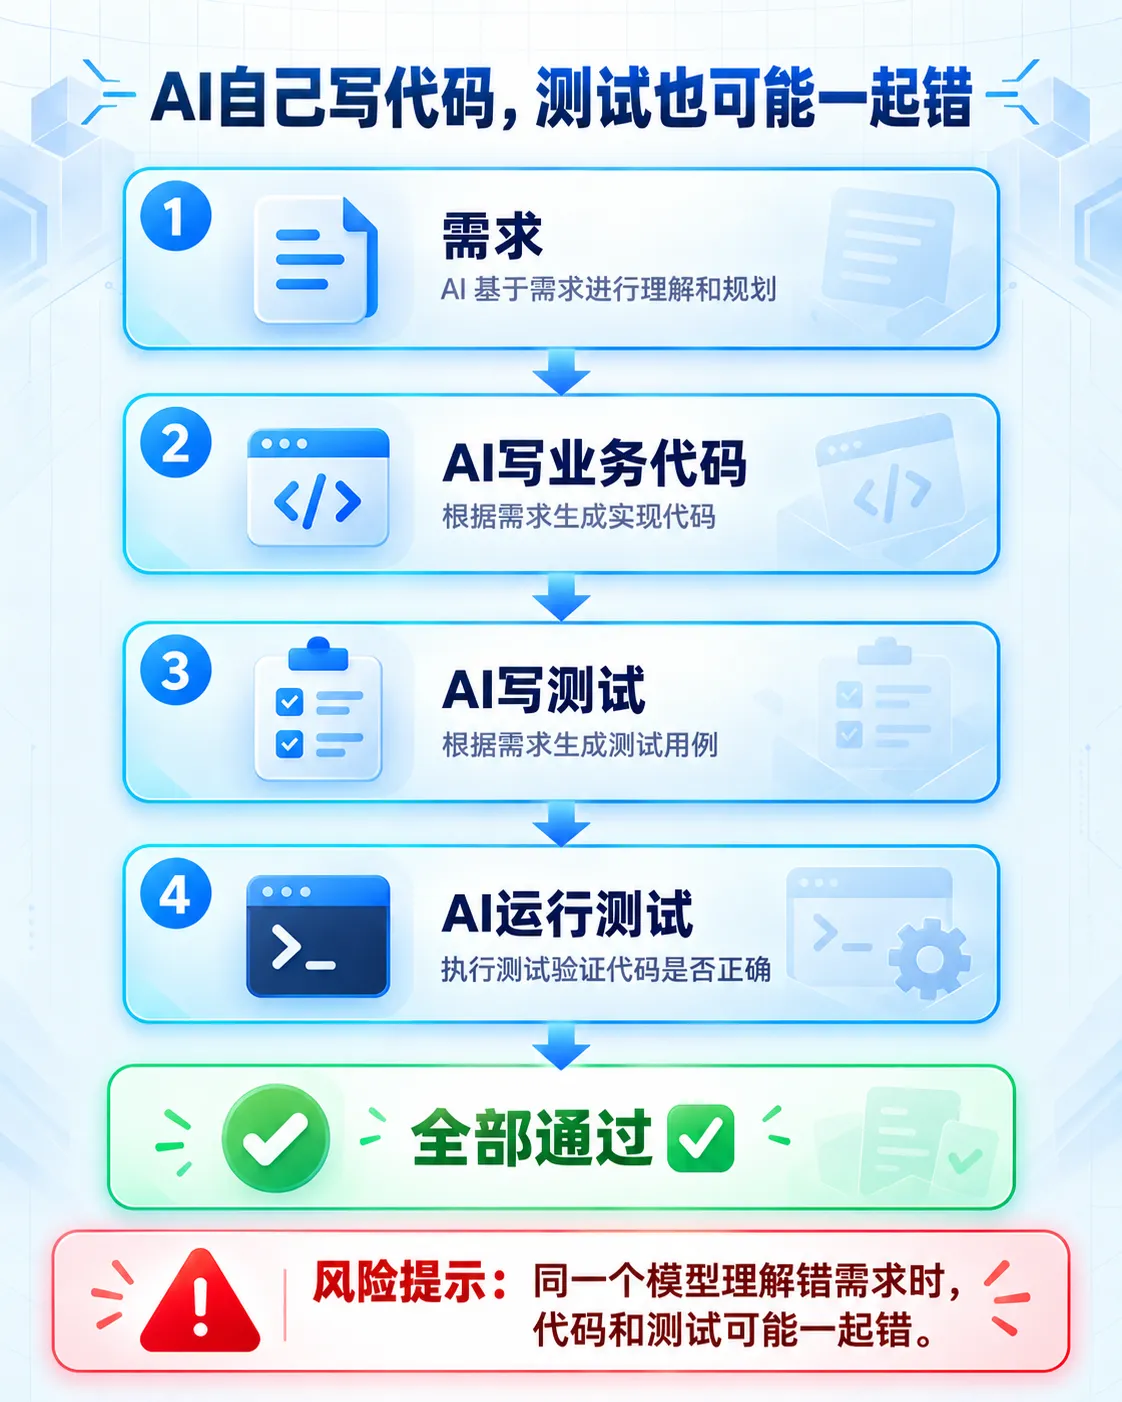
于是整个过程变成:
AI写代码
↓
AI写测试
↓
AI运行测试
↓
全部通过
看起来非常舒服。
但这里隐藏着一个问题:
代码和考试题,可能都是同一个“人”出的。
假设真实需求是:
用户连续输错密码 5 次以后锁定账户。
结果 AI 理解错了,代码写成:
if failed_count >= 6:
    lock_account()
然后它又顺手生成测试:
def test_lock_after_failed_attempts():
    for _ in range(6):
        login_with_wrong_password()

    assert account.is_locked
最后运行:
1 passed
整个流程一片绿色。
但业务逻辑还是错了。
这就是 AI Coding 里一个很典型的问题:
AI 对需求的错误理解,有可能同时进入业务代码和测试代码。
于是你会看到一种很有迷惑性的结果:
代码通过了测试,但代码和测试一起错了。
所以以后看到 AI 自动补出来的测试,至少要继续检查三个问题。
1. 测试有没有真正覆盖需求
不要只看:
Coverage 95%
而应该看:
关键业务规则到底有没有断言。
覆盖率高,不代表需求覆盖完整。
2. 测试是在验证需求,还是在验证AI自己的实现
AI 新写了:
calculate_price_v2()
然后测试里也只是验证:
calculate_price_v2()
这种测试有时候只能证明:
这个函数按照自己设计的逻辑运行正常。
但不能证明:
这个逻辑符合真实业务要求。
两件事差别很大。
3. AI有没有为了让测试通过而修改测试
这也是 Coding Agent 场景中特别值得留意的问题。
正确流程应该是:
测试失败
↓
发现代码问题
↓
修改代码
↓
重新测试
但如果 Agent 自己拥有修改测试文件的权限,就可能出现另一条路径:
测试失败
↓
认为测试条件不合理
↓
修改测试
↓
全部通过
所以未来测试 AI 写代码,一个很重要的能力可能变成:
不仅 Review 业务代码,还要 Review AI 修改过的测试。
第三件事:它有没有顺手改了太多东西?
假设你只告诉 AI:
修复一下登录接口偶发 500 的问题。
结果它最后提交了:
auth.py
user.py
database.py
config.py
middleware.py
requirements.txt
test_auth.py
一共改了 7 个文件。
最终 Bug 解决了。
原来的自动化测试也全部通过。
是不是就没问题?
这个时候,测试工程师最好多问一句:
为什么修一个登录问题,需要动这么多地方?
这也是现在 Coding Agent 评测里越来越重要的一个概念:
改动范围是否合理。
AI 和人写代码有一个很有意思的区别。
人接到一个 Bug,很多时候会想:
尽量少动,先把问题修掉。
Agent 阅读完整个项目以后,却可能觉得:
既然都改了,那我顺手帮你整理一下。
于是它可能:
顺手重构函数。
顺手换变量名。
顺手升级一个依赖。
顺手删掉它认为没用的代码。
顺手修改另外一个模块。
顺手格式化整个文件。
每一项单独看可能都没有错。
但组合起来以后,事情就变了。
原本只是一个小 Bug 修复。
最后却变成了一次小型重构。
对于测试来说,这意味着:
回归测试范围也跟着变大了。
所以以后看 AI 提交代码,可以养成一个特别简单的习惯:
先问:
需求原本要求改什么?
再问:
AI最后实际改了什么?
例如:
原始需求:
修复优惠券重复使用

实际改动:
coupon.py
order.py
payment.py
user.py
database.py
这种时候不一定意味着 AI 做错了。
但至少意味着:
不能再按照一个“小改动”的回归范围去测。
第四件事:代码能跑,不代表适合这个项目
这一点对刚开始接触 AI Coding 的同学尤其重要。
同样一段代码:
放在个人 Demo 里完全没问题。
放到公司项目里,可能就是不合格。
例如 AI 为了避免程序报错,写了一句:
except Exception:
    return None
功能跑起来了。
测试甚至也通过了。
但真实项目可能明确要求:
异常必须记录日志。
必须保留错误码。
必须区分异常类型。
严重异常必须触发监控。
不能静默吞掉异常。
再比如 AI 为了完成一个功能,自己新增:
new-package==3.2.1
本地运行完全正常。
但公司项目可能规定:
新增第三方依赖必须经过安全扫描和审批。
再比如:
SELECT * FROM users
查询结果是对的。
小数据量下性能也没问题。
但项目里的数据库开发规范可能明确禁止:
SELECT *
所以到了真实软件工程环境里,“正确”从来不只有一种标准。
代码不仅要:
能运行。
还得:
符合这个项目自己的规则。
包括:
- 日志规范
- 异常处理规范
- 数据库规范
- 安全规范
- 依赖管理
- 命名规则
- 代码风格
- 项目已有架构约束
这也是为什么现在越来越多 Coding Agent 会允许项目提前告诉 AI:
这个代码库应该怎么工作。
因为模型会写代码,并不代表它天然知道:
你们公司什么代码才算合格。
AI写的代码到底怎么测?先记住这4个问题
如果你刚开始接触大模型测评,其实完全没必要一上来就研究复杂 Benchmark。
先拿到一段 AI 生成代码以后,问下面四个问题:
① 功能真的做对了吗?
看需求、边界条件和异常场景。
② AI写的测试真的可信吗?
看断言、核心业务规则,以及测试有没有和代码一起理解错需求。
③ AI有没有超范围修改?
看修改文件、修改行数以及对上下游模块的影响。
④ 这段代码符合项目规范吗?
看日志、异常、安全、依赖以及代码库本身的工程约束。

可以把整套思路简单理解成:
AI生成代码
↓
功能正确性
↓
测试质量
↓
改动范围
↓
工程规范
↓
是否允许合并?
对于 AI Coding 场景来说,大模型测评的核心已经不只是判断“代码能不能跑”,而是判断“这份代码是不是达到了真实项目的质量标准”。
为什么以后“测试全过”也不能直接当最终结论?
这里还有一个特别值得测试工程师思考的问题。
我们经常觉得:
自动化测试是客观的。
但实际上它有一个前提:
测试标准本身必须正确。
如果测试用例就理解错了需求,那么:
100%通过
同样没有意义。
OpenAI 在研究软件工程类 Coding Benchmark 时,也公开讨论过类似问题。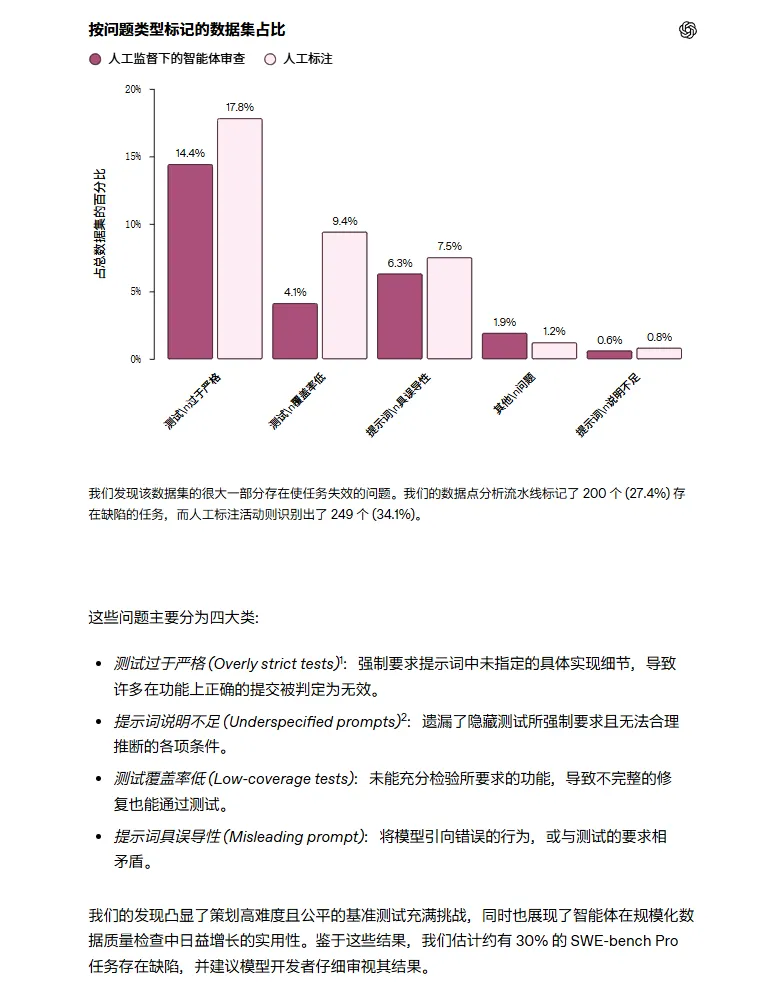
一些 Benchmark 中存在测试条件不合理、任务描述有歧义,或者测试实际上限制了某一种具体实现方式的问题。
于是就可能出现:
代码其实解决了问题,但因为没有按照测试预想的方式实现,被判失败。
反过来同样成立:
如果测试标准本身有漏洞,一份有问题的代码也可能顺利通过。
这件事放到 AI Coding 上会更加明显。
因为未来越来越可能出现:
AI写代码
+
AI写测试
+
AI修Bug
+
AI继续运行测试
+
AI继续提交
整个流程越来越自动。
如果最开始的验收标准就是错的:
系统甚至可能跑得越来越顺。
但方向越来越偏。
测试工程师以后可能需要定义:什么叫“写完”
以前开发跟测试说:
写完了,可以测了。
以后越来越多时候,可能会变成 Coding Agent 告诉你:
Done。
这个时候测试工程师真正需要确认的是:
Done 的标准到底是什么?
例如:
功能正确
+
核心边界通过
+
测试本身有效
+
没有无关修改
+
符合项目规范
+
没有引入新的明显风险
这些条件全部满足以后:
我们才能真正接近:
可以合并。
这其实并不是一个完全陌生的新工作。
过去软件测试一直就在做这件事:
把模糊的“做完了”,变成可以验证的质量标准。
只不过以前这些标准主要给人看。
以后,它们可能还要直接告诉 AI。
还有几个刚接触大模型测评的人经常会问的问题
AI自己跑过测试,还需要人工检查吗?
需要。
因为 AI 可能同时误解需求、生成错误代码,再生成与错误实现一致的测试,最后得到“全部通过”。
所以测试结果可以作为证据,但不能成为唯一判断依据。
AI生成代码以后,最先应该测什么?
第一优先级仍然是业务功能和关键边界。
确认需求方向没错以后,再检查 AI 生成测试的质量、代码修改范围以及是否符合项目规范。
AI写代码属于大模型测评吗?
属于大模型能力评测的一个重要应用场景。
只是评测对象从传统的“回答质量”,进一步扩展到了代码正确性、测试质量、工程规范以及真实软件任务完成能力。
测试工程师需要会训练大模型才能做这种测试吗?
不需要。
很多 AI Coding 测试能力,本质上仍然建立在测试工程师熟悉的东西上:
需求分析、测试设计、自动化测试、代码 Review、回归测试和质量门禁。
需要补的是:
如何把这些能力重新应用到 AI 生成的软件产物上。
最后
面对 AI 写出来的代码,很容易出现两个极端。
一种是:
AI生成代码不靠谱,所以全部重新检查。
另一种是:
AI自己都把测试跑过了,那应该没问题。
其实都没必要。
更实际的方法,是把 Coding Agent 当成一个写代码特别快的新成员。
它提交代码以后,我们还是按照工程质量标准去验:
功能有没有真正做对。
测试本身是不是可信。
有没有修改不该修改的东西。
最后是否符合整个项目的开发规范。
所以 AI 写代码以后,测试对象并没有突然变成一个完全陌生的领域。
真正变化的是:
以前测试更多在判断:
功能有没有 Bug。
以后还需要继续判断:
AI交出来的这份代码,到底是不是一份可以进入真实项目的工程代码。
代码能跑,只是起点。
测试全过,也不是终点。
真正需要回答的问题是:
这段代码,我们到底敢不敢让它进项目?
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。