大家好,我是晚安code。
假设一个场景,有个做 RAG 的活儿,给售后知识库搭问答。第一版上线就被业务怼了:用户问「退货要几天到账」,它回了一段「签收后 7 天内可申请」——条款本身没错,但答的根本不是这个问题。
第一反应是模型不够强,从便宜换到贵的,换了两轮,效果一点没动。
最后查出来的原因很朴素:切分的时候按固定字数硬切,把「退货时效」那张表切成了两半,表头在上一块、数字在下一块。检索召回的永远是半句话,模型再强也只能拿着半句话编。
这篇把 RAG 是什么、怎么工作、以及为什么效果差,一次讲透。全程配可跑的代码,建议先点个收藏。
一、先给结论:RAG 的瓶颈在检索端,不在生成端
RAG 的效果上限,是被检索质量卡住的,不是被模型能力卡住的。
先把这个词的定义钉死。
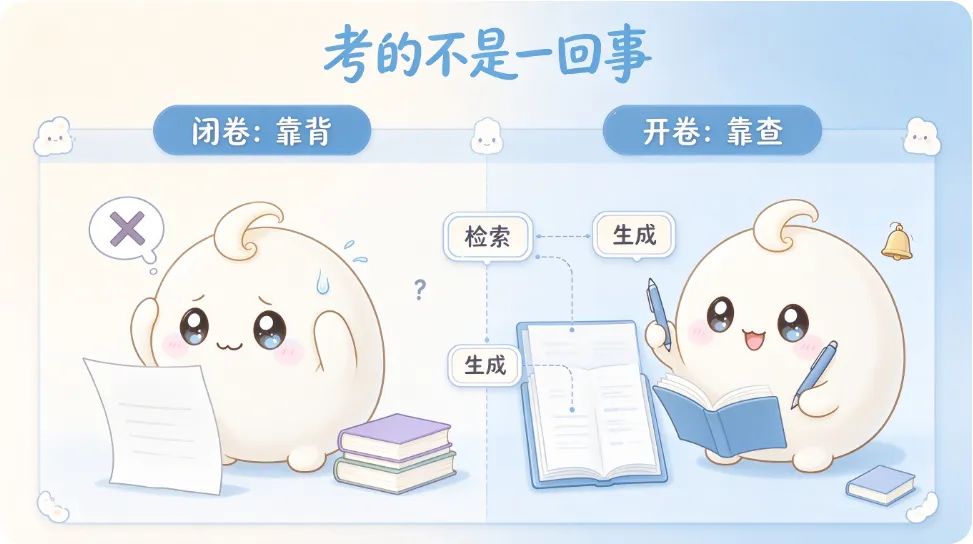
RAG(Retrieval-Augmented Generation,检索增强生成):在让大模型回答之前,先去你的知识库里捞出相关资料,把资料连同问题一起交给模型,让它照着资料答。类比一下,就是把闭卷考试改成开卷考试。
这个类比的妙处在于:闭卷考的是「背没背过」,开卷考的是「会不会查」。RAG 给模型加的是查的能力,不是背的能力。
想通这一层,排查思路就顺了。它答错了,只可能是两种情况:
- 它没查到——召回的结果里压根没有正确答案。这是检索端的问题。
- 它查到了但答错了——正确内容就在 Top-K 里,模型没用上或者用歪了。这才是生成端的问题。
所以拿到一个效果不好的 RAG,我的排查顺序固定是:先把召回结果打出来,人眼看一遍有没有正确答案,再决定往哪修。
顺序反过来会怎样?我替你试过了,就是开头那个换两轮模型的白忙活。
RAG 不是让模型变聪明,是给它的输出接一条可核验的来源线。 这条线接在哪一段,比线另一端接的是哪家模型重要得多。
二、RAG 要解决的是大模型的三道硬伤
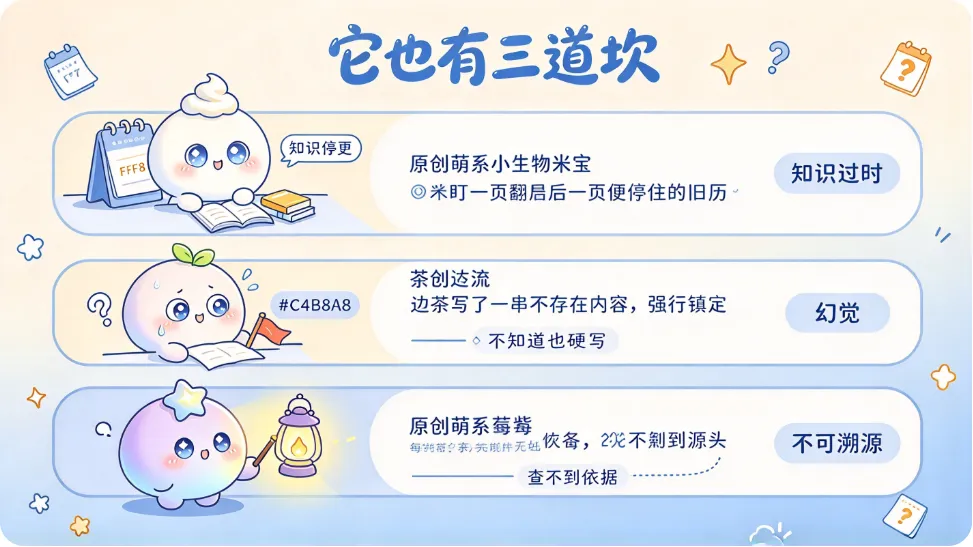
RAG 不是为了把模型变聪明,是为了绕开大模型天生的三个短板。
这三个短板不解决,任何模型都躲不掉:
- 知识停在训练截止日。 模型权重是训练那一刻冻住的知识。训练结束后的新政策、新价格、新流程,它一概不知道,而且是不知道自己不知道。
- 不知道时会硬编。 这是最要命的一条。
- 答错了你查不到依据。 它给一段通顺的答案,你没法判断这句是记住了还是编的,合规场景里这没法用。
第二条单独拎出来说:
大模型幻觉(Hallucination):模型在不知道答案的时候,仍然按语言概率生成一段通顺、具体、但事实错误的内容。类比一下,它不是撒谎,是「太想把话说圆」——为了让句子完整,它把空缺的部分填上了。
到 2026 年,对付这三个短板主要有三条路,分工大致是这样:
| 方案 | 解决什么 | 知识更新 | 主要成本 | 适合场景 |
|---|---|---|---|---|
| 微调 | 让模型学会某种表达风格或输出格式 | 要重新训练 | 训练算力 + 标注数据 | 格式固定、风格要求高 |
| RAG | 让模型答出训练集里没有的事实 | 改知识库即可 | 检索链路的搭建与维护 | 知识频繁变、要溯源 |
| 长上下文 | 一次塞更多原文进去 | 不用更新(每次现塞) | 每轮 token 费用 | 单次材料少、临时分析 |
三条路不互斥。格式靠微调、事实靠 RAG、临时材料靠长上下文,完全可以一起上。
三、RAG 工作流程拆解:一次提问背后发生了什么
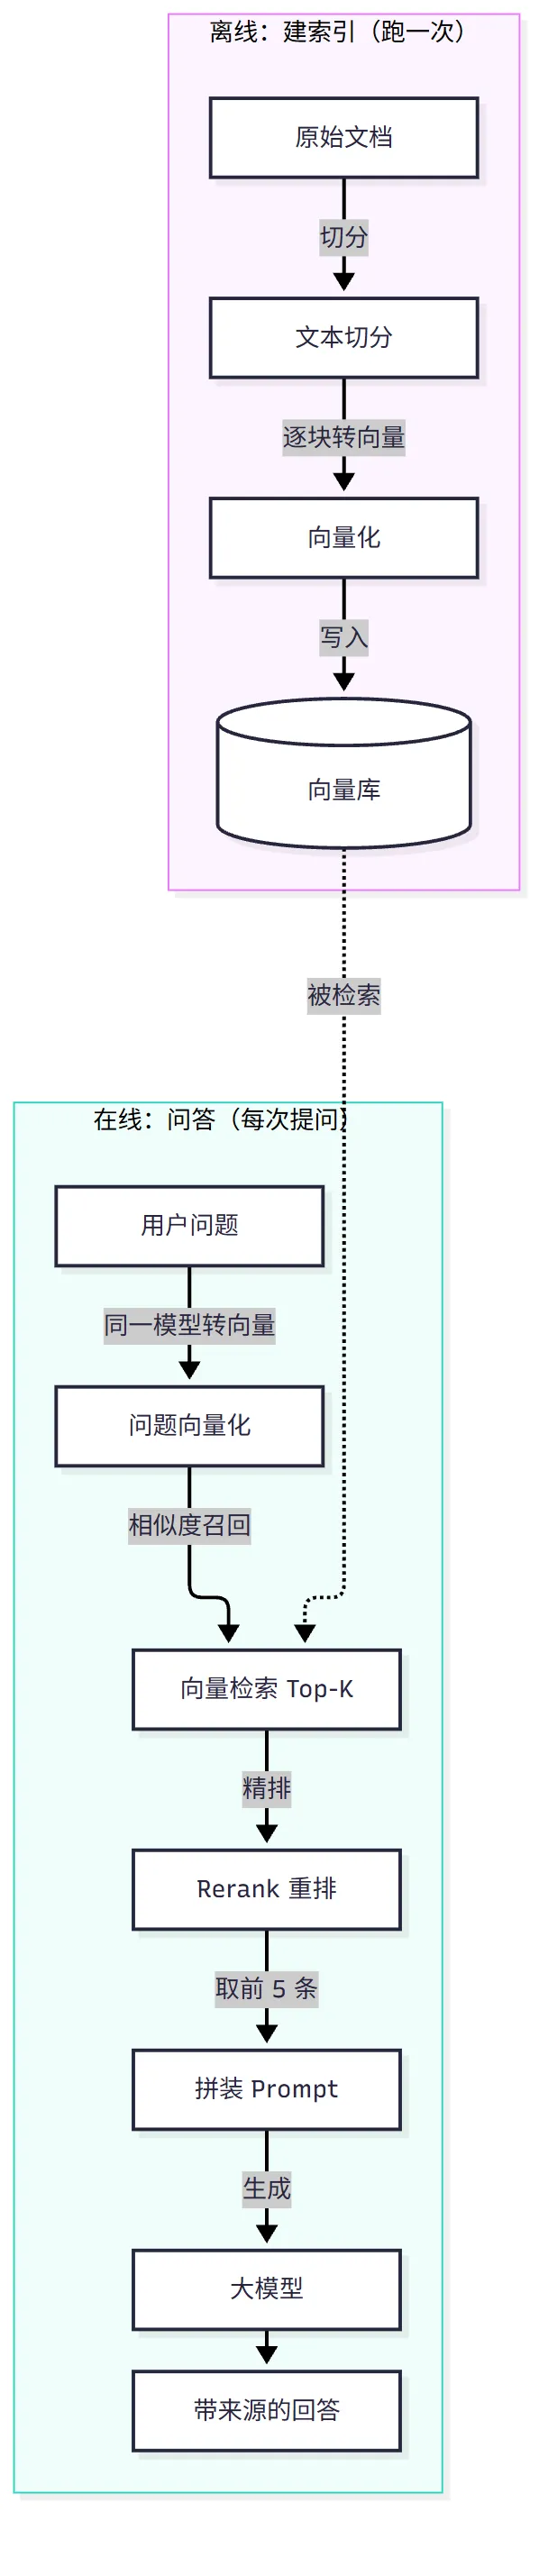
RAG 的链路分两段:离线建索引决定「你能查到什么」,在线检索决定「这次查到了什么」。
大多数人对 RAG 的模糊印象只停留在后半段,所以出了问题也只往后半段找。
完整链路长这样:
拆开说。
离线那一段(建索引,跑一次):把原始文档切分成块,逐块转向量,存进向量库。这段决定了你的知识库里「有什么是可被查到的」。切分切坏了,后面全白搭。
在线那一段(每次提问都跑):把用户问题也转向量,去向量库里按相似度捞回最接近的 Top-K 块,重排一次,拼进 Prompt,最后交给模型生成。
有个细节容易忽略:问题和文档必须用同一个 embedding 模型转向量。两个模型各自转出来的向量不在一个空间里,算相似度等于拿尺子量温度。换了 embedding 模型,整个库都要重转一遍。
下面是三段核心代码。用哪个向量库、哪个 embedding 模型,各家的接口写法差别不小,这里只保留逻辑骨架,具体调用以官方文档为准。
问的是「分块怎么切」,代码长这样:
import re

def split_by_structure(text, max_chars=800):
    """先按标题层级切,保住「条款 → 子条款」的从属关系;超长块再按段落拆"""
    blocks = re.split(r"\n(?=#{1,3}\s)", text)
    chunks = []
    for block in blocks:
        block = block.strip()
        if not block:
            continue
        if len(block) <= max_chars:
            chunks.append(block)
            continue
        # 标题行带进每一块,避免子块脱离上下文后语义丢失
        head, _, rest = block.partition("\n")
        for para in rest.split("\n\n"):
            if para.strip():
                chunks.append(f"{head}\n{para.strip()}")
    return [c for c in chunks if len(c) > 30]
关键在那句 re.split(r"\n(?=#{1,3}\s)")——按标题切,而不是按字数切。标题天然是语义边界,字数不是。
检索那一步,本质就是算余弦相似度取前几名:
import numpy as np

def top_k(query_vec, doc_matrix, k=5):
    """doc_matrix 每一行是一个文档块的向量"""
    q = query_vec / np.linalg.norm(query_vec)
    docs = doc_matrix / np.linalg.norm(doc_matrix, axis=1, keepdims=True)
    scores = docs @ q                      # 余弦相似度
    idx = np.argsort(-scores)[:k]
    return [(int(i), float(scores[i])) for i in idx]
最后是拼 Prompt。这一段是全文性价比最高的地方,多加两行规则,效果能差出一截:
PROMPT = """你是售后政策助手,只能依据下面的资料回答。

资料:
{context}

问题:{question}

规则:
1. 资料里没有提到的内容,直接回答"资料中未提及",不要推测。
2. 每个结论后面用 [编号] 标注它出自哪一段资料。"""

def build_prompt(contexts, question):
    ctx = "\n\n".join(f"[{i + 1}] {c}" for i, c in enumerate(contexts))
    return PROMPT.format(context=ctx, question=question)
第 1 条规则给模型留了「可以拒答」的出口,第 2 条让答案天然带引用。少写这两行的 RAG,就是模型硬编的主要来源。
四、四个最容易翻车的地方(以及怎么修)
RAG 效果差的时候,先怀疑切分,再怀疑检索,最后才怀疑模型——这个顺序能省掉大半无效排查。
下面四条按「出现频率 × 排查成本」排的,从最容易查的开始。
1)切分把语义切碎了
固定字数切分看着整齐,实际上会把表格、代码块、带编号的条款从中间劈开。开头那个例子里,「退货时效」的表头和数字就是这样被拆散的。

改法有三个,都不复杂:
- 按结构切(标题、段落、列表项),别按字数切
- 相邻块之间留 10%~20% 的重叠,防止边界上的语义被切断
- 表格、代码块这类结构敏感的内容整块保留,宁可超长也不切开
2)向量检索「看着像」不等于「答得上」
向量检索比的是语义相似度,本质是模糊匹配。碰到型号、「第 12 条」这类精确标识,它就明显不灵了——「KB-2200」和「KB-2201」在向量空间里挨得极近,但一个是你要的,一个不是。
混合检索(Hybrid Search):同时跑两路召回,一路是向量检索负责语义,一路是关键词检索负责精确匹配,两路结果合并后再统一排序。类比一下,就是既让懂行的人凭印象找,也让机器按条码逐一核对,两边对不上的再人工看一眼。
多数向量库和检索框架都内置了这能力,难点不在实现,在于你有没有意识到需要它。
3)少了重排,Top-K 里混着一堆干扰
Rerank(重排序):先用向量检索快速召回一批候选(比如 50 条),再用一个更慢但更准的模型对这 50 条精排,只取最相关的 5 条送进 Prompt。类比一下,先海选再面试。
它的位置在检索链路里是这样,重点看「宽召回」和「精排」的分工:
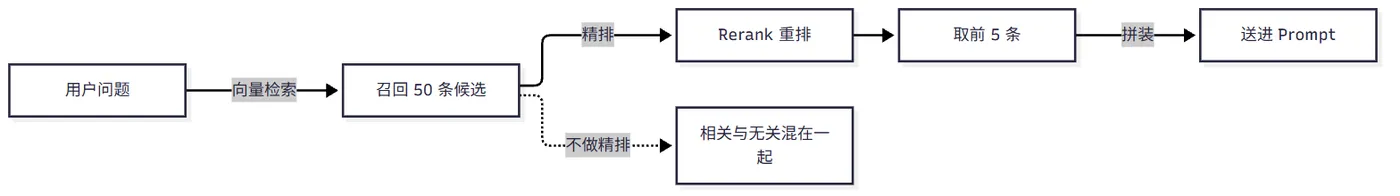
向量检索要在毫秒级扫过全库,所以模型必须做得轻,精度天然有限;重排只处理 50 条,可以放心用重模型。这一轻一重搭配,比单纯把 Top-K 调大有效得多——把 K 从 5 调到 50,多出来的 45 条里大半是噪声,反而把真正有用的那条淹没了。
4)没给模型留「可以拒答」的出口
不写拒答规则,模型遇到资料里没有的问题时会倾向于硬答,因为它的训练目标就是「把话说完整」,而不是「说不知道」。上一节那段 Prompt 的第 1 条规则就是在堵这个口子。
四个问题对照着看更清楚:
| 症状 | 多半是 | 先改哪 |
|---|---|---|
| 答非所问,但条款内容本身没错 | 切分把语义切碎了 | 改按结构切 + 加 10%~20% 重叠 |
| 问型号、编号类问题答不准 | 纯向量检索对精确匹配不敏感 | 加一路关键词检索做混合召回 |
| Top-K 里混着一堆无关内容 | 没做重排 | 加 Rerank,候选先放大到 50 再精排 |
| 资料里没有它也硬编 | Prompt 没给拒答出口 | 明确写「资料未提及时回答不知道」 |
五、RAG 会不会被长上下文干掉
长上下文解决的是「一次能塞多少」,RAG 解决的是「该塞哪一些」,这是两个问题。
可能有人会问:现在模型上下文动辄几十万 token,把文档全塞进去不就行了,还要 RAG 干什么?
三个原因。一是成本,全量塞进去,每一轮对话都要为整份材料付 token 费用,而 RAG 只送进去几条相关片段,量级差得很远。二是数据规模,企业知识库通常是几十万到上百万份文档,任何上下文窗口都装不下,这不是容量问题,是量级问题。三是模型对长上下文并不均匀地好用。
第三点有实测支撑。Liu 等人在 2023 年的论文 Lost in the Middle(arXiv:2307.03172)里做过一个实验:把答案放在输入上下文的不同位置,看模型还能不能找出来。结果是条 U 型曲线——答案在开头或结尾时模型找得到,放到中间就明显掉分,而且长上下文模型也不例外。
所以「塞得进去」和「用得起来」是两件事。这也解释了一个常见现象:你把 Top-K 从 5 调到 20,效果没变好反而变差——多出来的文档把正确答案推到了上下文中间。
长上下文没有干掉 RAG,它干掉的是「切一切、塞一塞就上线」那一版 RAG。
真正在变的是检索这一端:从单轮向量检索,变成会判断该查哪个库、查不到就换个问法再查一轮的智能体式检索;从纯向量,变成向量加关键词的混合召回。模型换了一代又一代,这段链路的位置反而越来越重要了。
我是晚安code,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:你做 RAG 的时候,卡在切分、检索还是生成哪一环?