同一个模型,为什么要保留多次调用记录
这是一次个人使用中的日志习惯总结。即使模型、提示词和渠道看起来都一样,我也不会只保存一次“成功样本”,因为单次请求无法反映输出长度、缓存状态和偶发失败的变化。
多次记录才能看到变化
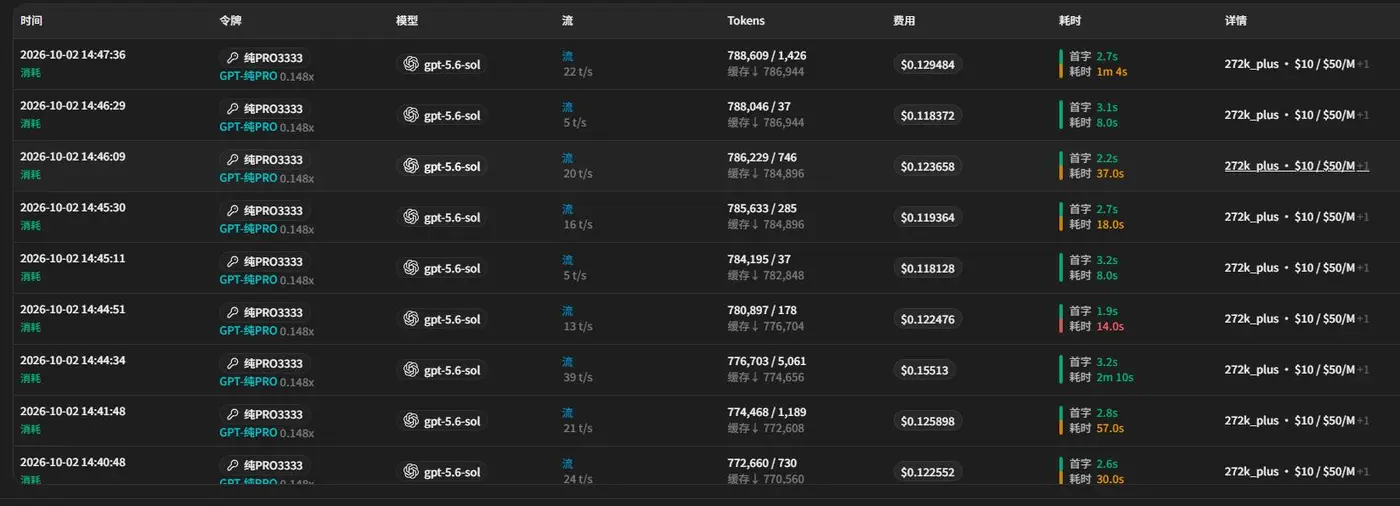
我会连续保存几次相似请求,比较:
- 输入总量是否稳定;
- 缓存输入是否变化;
- 输出 Token 是否突然变长;
- 首字时间和总耗时是否出现长尾;
- 费用是否与 Token 变化一致。
例如,输入总量接近的请求,可能因为输出长度不同而有完全不同的总耗时。一次快、一次慢,不一定是模型本身变了,也可能是任务结果长度不同。
统计页帮助我发现异常方向
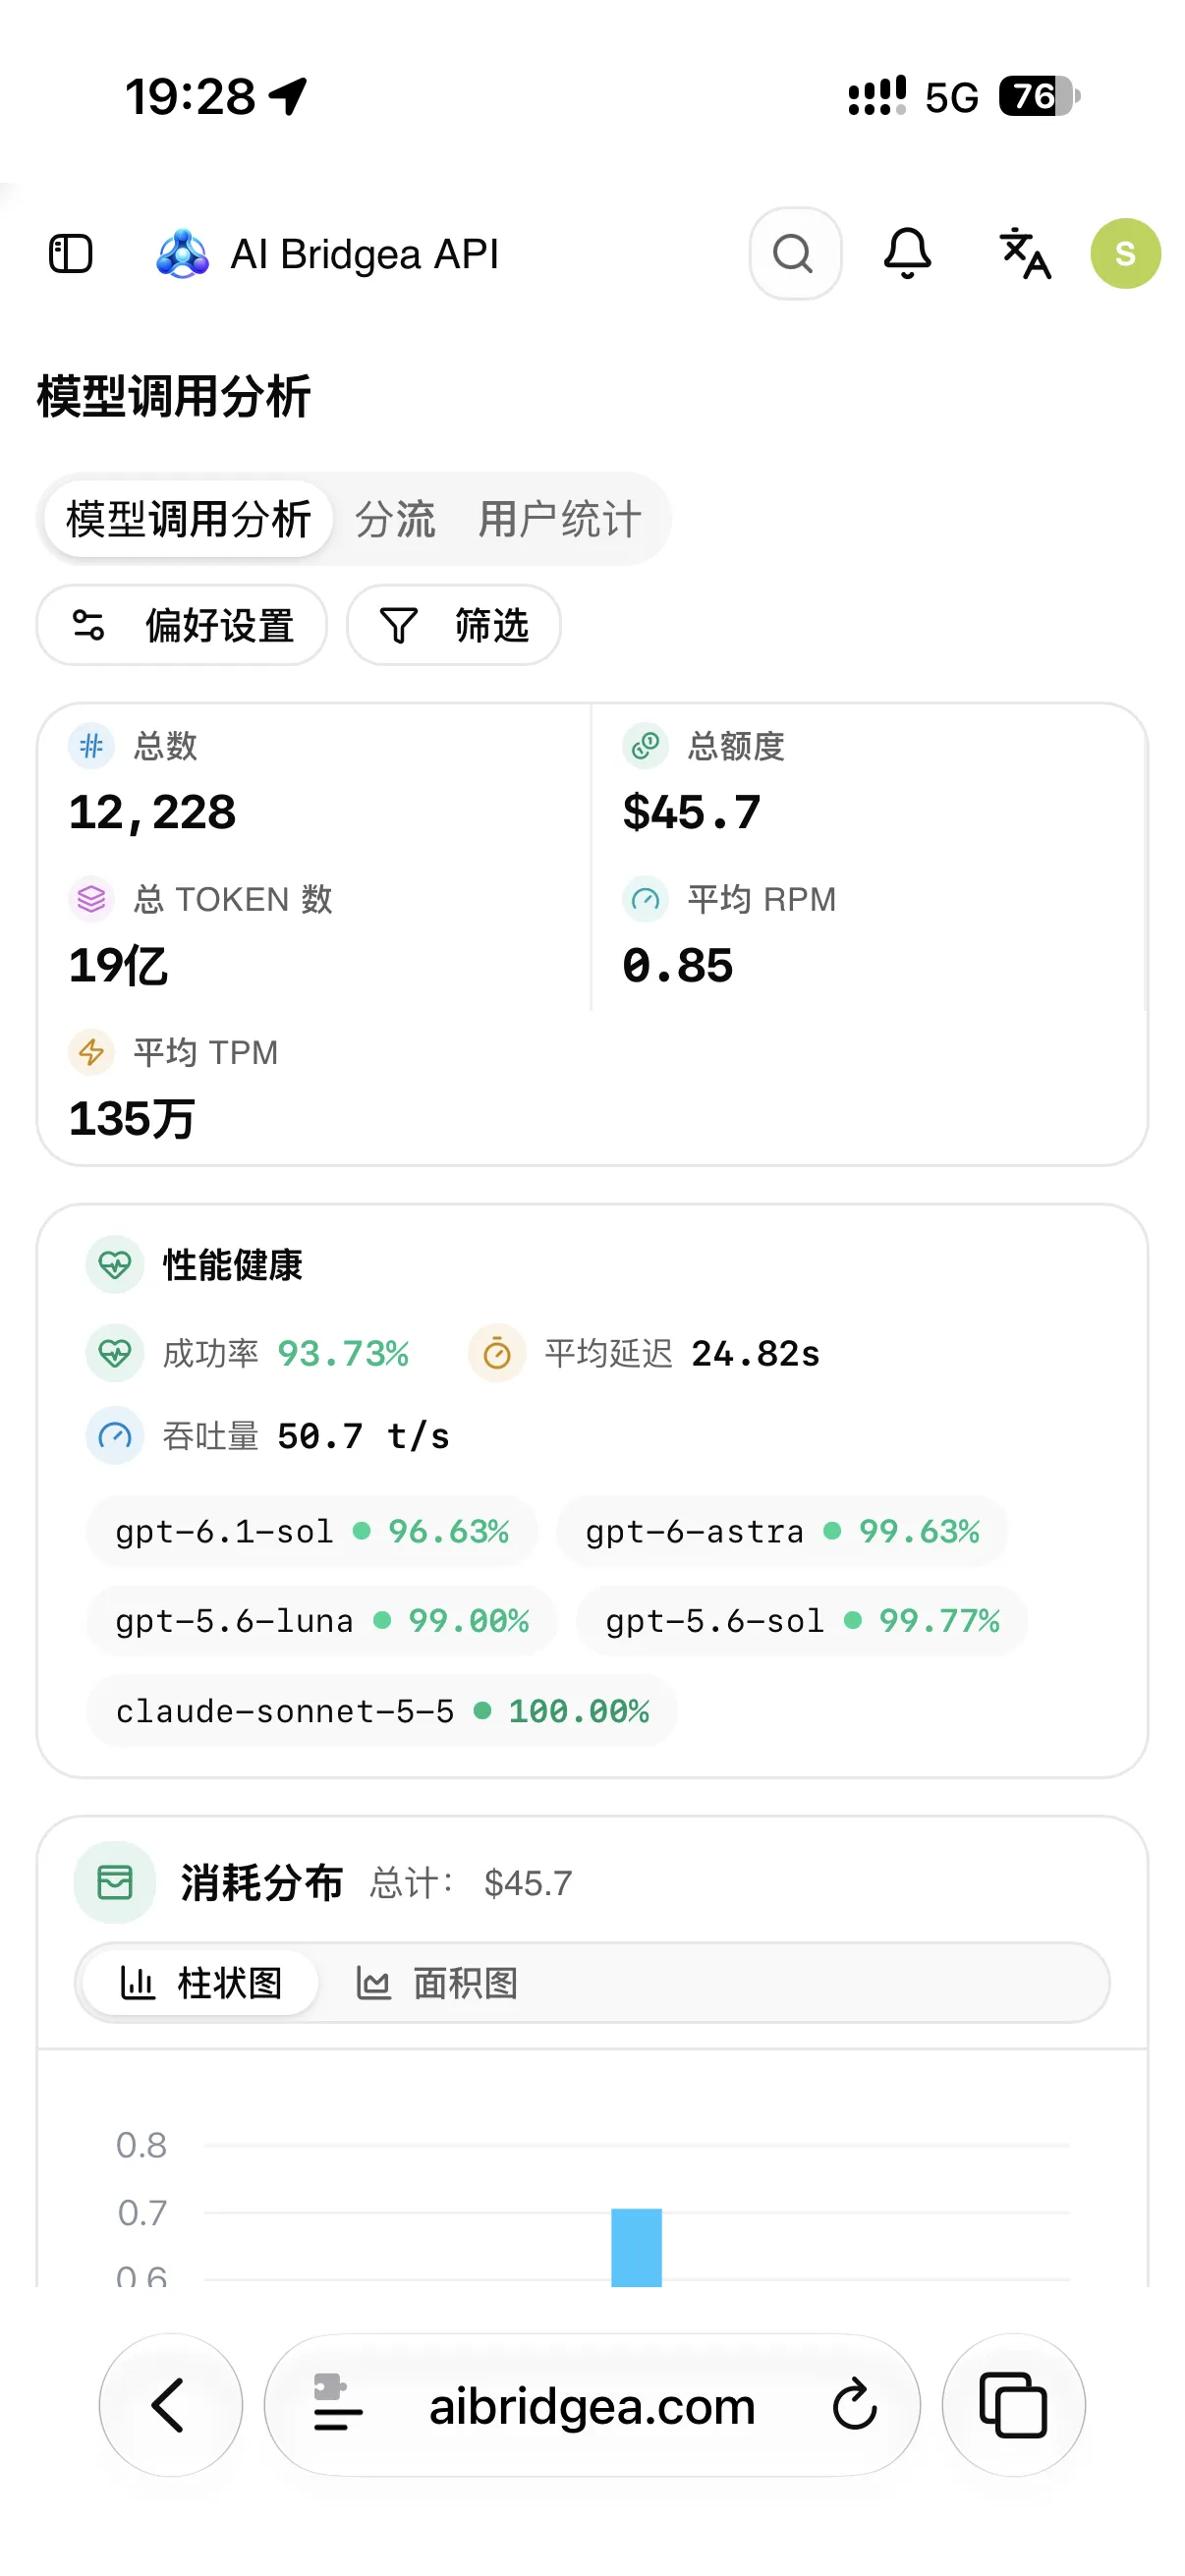
当累计调用数、Token 或额度出现异常增长时,我会先从统计页发现趋势,再回到具体请求检查是哪一类任务贡献了变化。统计汇总不能代替日志,但能节省定位范围的时间。
不把一次好结果写成长期保证
多次记录的价值,还在于让我对结论保持克制。一次低费用、一次较快首字或一次成功率很高的截图,都只能说明样本发生过什么。只有持续、同条件的记录,才适合用于自己的项目决策。
本文是个人日志和调用统计的使用方法整理,截图数据属于 2026 年 10 月 2 日的样本,实际表现需要按自己的任务持续验证。