我会把 AI 接口的成本拆成三层看
这是一次个人项目中的成本管理方法。现在我不会只看一次调用的最终金额,而是把成本拆成三层:请求本身的 Token 成本、失败与重试成本、业务返工成本。
第一层:Token 和计费规则
我先记录输入总量、缓存输入、未缓存输入、输出 Token、模型、渠道和倍率。长上下文任务尤其要把缓存输入单独列出来,否则很容易高估或低估实际费用。
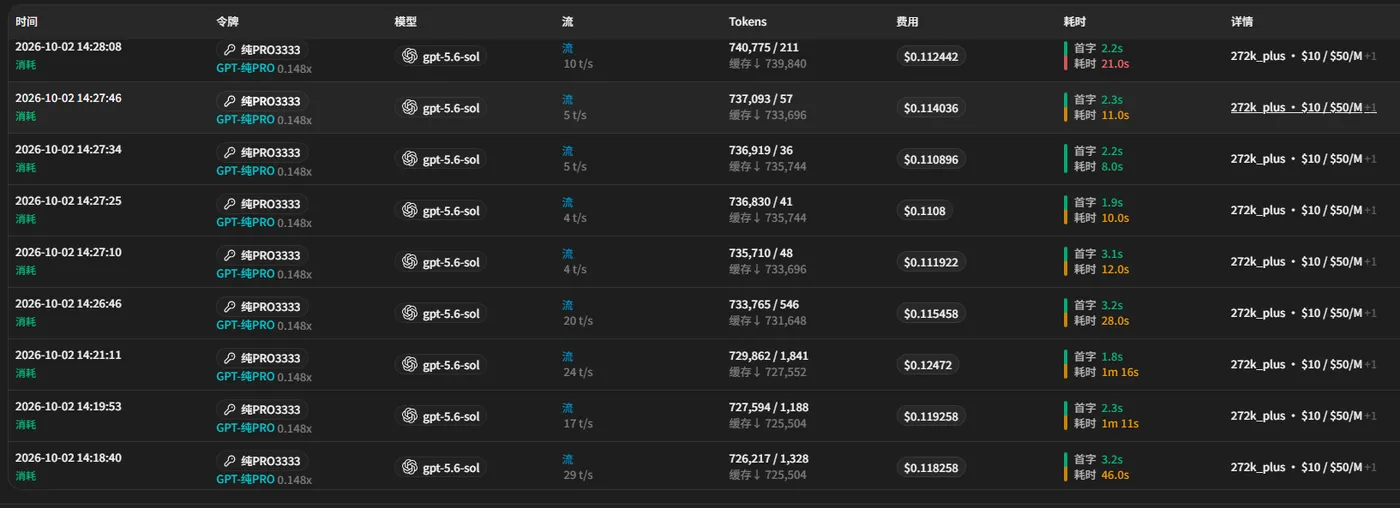
这条记录的输入总量为 740,775 Token,缓存输入为 739,840 Token,输出为 211 Token。它适合用来提醒自己:输入、缓存和输出是不同的计费组成部分。
第二层:失败和重试
如果请求超时、工具调用失败或响应格式不符合要求,系统可能会重试。重试会增加 Token 和等待时间,因此我会记录原始请求数、重试次数、最终状态和累计费用。
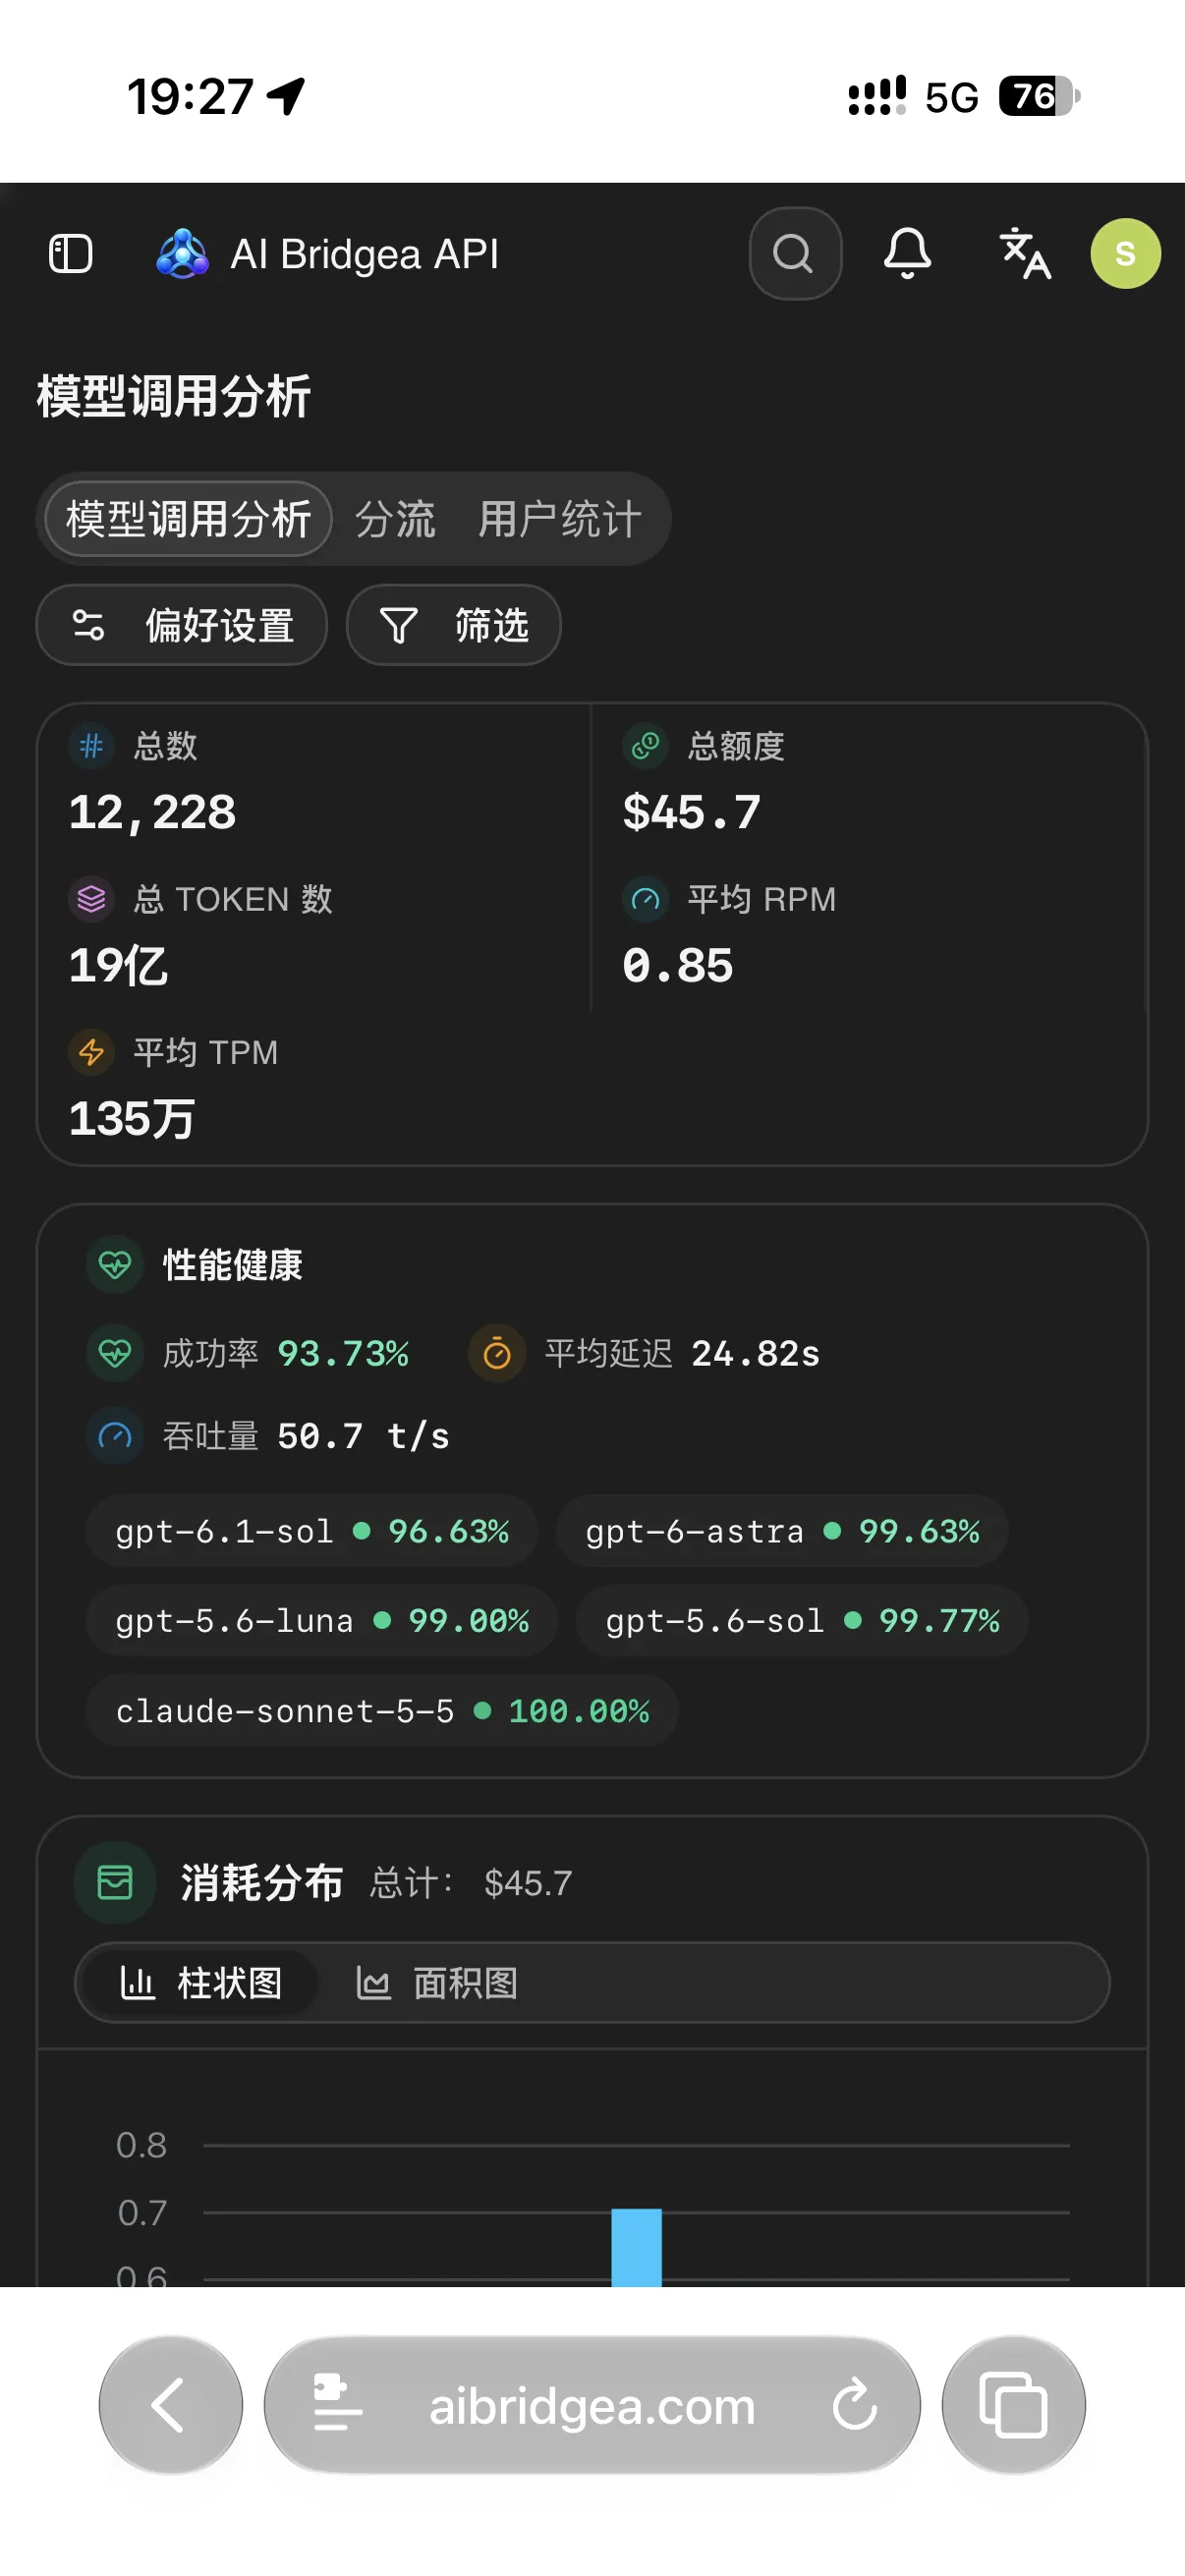
统计页能帮助我观察成功率和平均延迟的变化,但异常请求还要回到明细中确认。只看最终成功结果,可能会漏掉中间已经发生的失败成本。
第三层:人工返工和业务时间
一个回答即使价格不高,如果需要大量人工修正,也不一定真的便宜。代码任务要看补丁可用性,结构化任务要看格式合规,批处理要看失败后的恢复成本。
所以我会按实际业务评估“每个可用结果的成本”,而不是只看 API 返回一次的价格。本文是个人使用经验整理,所有图片和数据仅代表 2026 年 10 月 2 日的样本,具体费用和性能需要以实际任务复核。