看到价格页后我会做的三步核验

简介: 本文分享接入多模型API时的三步价格核验法:①统一比较前提(模型/提示词/上下文等);②拆解账单明细,定位费用变动根源;③结合业务场景权衡成本与体验(如首字延迟、缓存命中率、输出质量)。避免仅看倍率做决策。

看到价格页后,我会做的三步核验

这是一次个人使用后的经验整理。第一次看多模型 API 的价格页时,最容易做的事情是挑一个倍率最低的渠道;但实际接入后,我更关心这条价格能不能在自己的任务里复现。

下面这张截图展示了多个渠道或分组的倍率。它很适合帮我缩小候选范围,但我不会把其中任何一个数字直接写成“长期最低价”或“固定成本”。页面、模型、渠道、缓存规则和活动都可能变化,截图只能说明对应时点展示过什么。
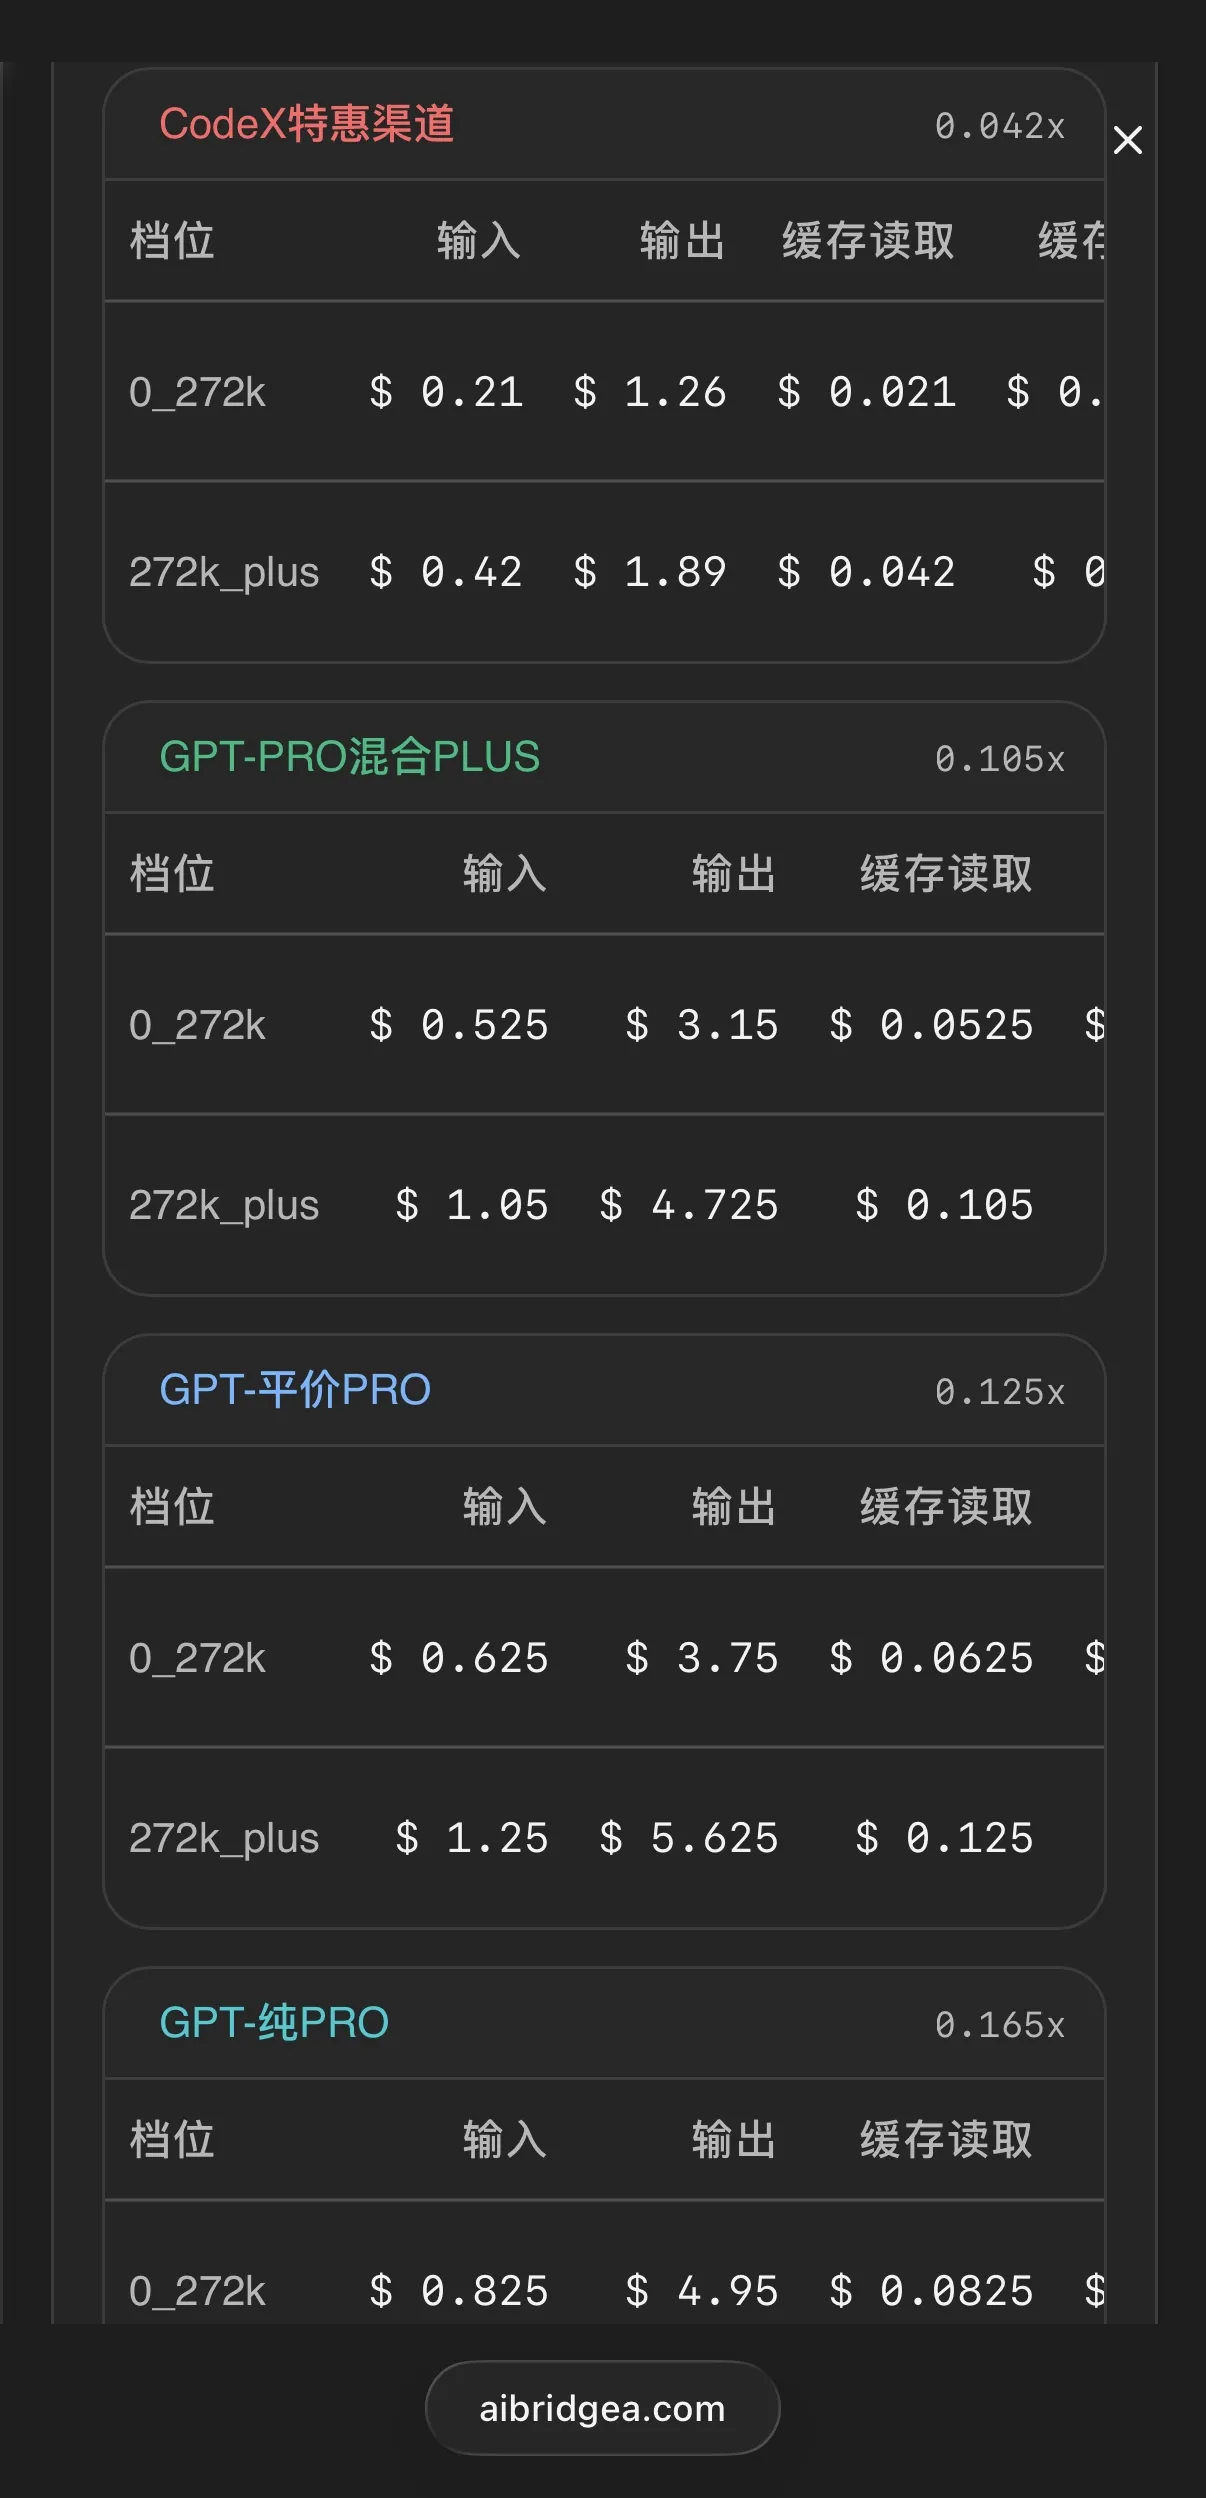
价格页面截图,展示多个分组倍率

第一步:确认比较前提一致

比较两个渠道前,我会先固定模型、提示词、最大输出、工具定义和网络环境。否则一个渠道多输出了几百 Token,或者另一个渠道换了模型,最终费用再低也没有可比性。

长上下文场景还要固定前置上下文。缓存输入是费用的一部分,冷缓存和热缓存如果混在一起,结论很容易失真。

第二步:把最终账单拆开

我会记录输入总量、缓存输入、未缓存输入、输出 Token、实际倍率和最终费用。这样可以区分费用变化是由哪里造成的:

  • 提示词或上下文变长;
  • 缓存没有命中;
  • 输出没有限制;
  • 渠道或分组发生变化;
  • 重试让一次业务动作产生多次调用。

只看“每百万 Token 单价”或“倍率”时,这些差异都很难暴露出来。

第三步:把成本和体验一起看

一个渠道即使费用更低,也可能不适合需要即时反馈的交互任务;反过来,更快的首字时间也不一定值得为所有批处理任务付出更多成本。

所以我会按业务分开决定:

场景 优先验证
在线聊天与代码补全 首字时间、错误率、输出质量
长文档分析 缓存输入、完整耗时、最终费用
离线批处理 成功率、吞吐、重试后成本

用一组真实任务跑完这三步,才能知道一个价格页上的数字是否适合自己的项目。本文是个人测试和截图阅读的整理,不构成价格或性能承诺;具体以实际调用时的页面和账单为准。

目录
相关文章
|
2月前
|
人工智能 自然语言处理 搜索推荐
如何使用Codex和Craftsman Agent Skills构建AI珠宝设计工作站-AI珠宝手串项链个性化定制
Craftsman Agent Jewelry Designer 是一款AI珠宝设计工作站并且提供Skills,支持Codex/Claude等Agent。通过自然语言或图片,一键生成手绘草图、交互式3D模型,并直连工坊报价生产。支持戒指、手链等7类模板,参数化调节宝石、金属、尺寸等,实现“Prompt→设计→3D→报价→制造”全链路定制。(239字)
|
22天前
|
人工智能 安全 测试技术
夯爆了!又一款开源企业级一站式AI智能测试平台!(附平台架构、技术选型)
国庆前AI进化社调研显示:95%企业已启动AI转型,但80%落地集中于知识库、开发提效等浅层场景,深度业务应用不足40%。症结在于“上要结果、下缺能力”。为此推出2026年重磅实战项目——**AI智能测试平台**,覆盖自动化、性能、安全、RAG、Agent等全场景,以分层插件架构+自研AI网关,实现可私有化、可度量、可沉淀的企业级AI测试基础设施。
239 2
夯爆了!又一款开源企业级一站式AI智能测试平台!(附平台架构、技术选型)
|
2月前
|
人工智能 测试技术 API
最近全网爆火的 Jev 到底是什么?适合干什么、怎么用,一篇讲透!
Jev是TypeSafe AI推出的“系统一模型”,不生成文本,专做毫秒级结构化决策:Choice(多选)、Score(打分)、Noul(是非概率)。响应快193倍、成本低444倍,适合工单路由、内容审核、测试定级等高频判断场景。
3559 4
最近全网爆火的 Jev 到底是什么?适合干什么、怎么用,一篇讲透!
|
1月前
|
人工智能 运维 前端开发
接入多家模型供应商之后,我总结的 7 条铁律
AI 应用接了第二家模型供应商之后,事情就不再是"多加一个接口"那么简单——不是调不通,是钱会算错。这篇讲我们定下来的 7 条规则:幂等键、任务落库时机、备用线路的切换边界、退款、凭据隔离、付款来源固化、密钥不进浏览器。
|
1月前
|
并行计算 API 异构计算
类Jev项目Kev从入门到实战(4):安装使用:十分钟跑起来
Kev 是轻量级结构化推理模型,支持 Python/CLI/API 多种接入方式。10分钟即可本地部署,兼容 CUDA/ROCm/Metal,提供零安装在线试用、Modal 一键云端部署及完整 SDK,专为工单分类、情绪识别等场景优化。
325 3
|
2月前
|
安全 API Python
JEV 玩贪吃蛇:每秒 3 步,模型到底判断了什么?
本文展示用JEV框架让模型玩贪吃蛇:每秒3步,将局面转为四向选择题,输出方向概率。本地Laya实现,不调远程API;程序预计算安全与路径特征,模型仅对标签化选项做判断。附JEV教学Skill供延伸实践。(239字)
|
1月前
|
SQL 缓存 API
别再把整个数据库Schema塞给AI了:5个Token优化策略,帮你省下80%的API账单
文章从一次浪费3000美元的教训切入,指出将全量数据库Schema塞给AI会导致token成本线性增长、SQL准确率下降。提出五个优化策略:RAG动态Schema选择、渐进式披露、Schema压缩与序列化优化、前缀缓存、自适应路由与语义压缩。组合使用后,240表数据库的token消耗可降低92%以上,SQL准确率从72%提升至85%。文章强调RAG需结合外键图扩展以避免JOIN路径断裂,推荐从RAG和前缀缓存入手,并提醒避开用LLM压缩Schema、忽略缓存失效、不做索引版本控制等坑。
236 1
|
1月前
|
数据采集 物联网 API
类Jev项目Kev从入门到实战(5):如何训练:从数据构造到评测的完整管线
本节详解Kev模型微调全流程:以JSONL统一数据格式,强调`--init_from`续训、四条数据构造铁律及分段LoRA训练;涵盖评测指标、显存优化与实战避坑经验。
298 2
|
2月前
|
缓存 人工智能 测试技术
Codex 子 Agent 配置:config.toml 字段、并行判据与上下文管理
本文详解Codex子Agent配置要点:厘清`config.toml`作用域、`[agents]`字段语义(尤其`max_concurrent_threads_per_session`不含主Agent)、`max_depth=1`的必要性、官方并行判据、轮询开销、主线程模型选择策略、`reasoning.effort`五档含义及上下文管理开关等关键细节,助你规避常见配置陷阱。(239字)

热门文章

最新文章