我会用冷缓存和热缓存做两次测试

简介: 本文分享个人缓存测试方法:通过冷/热缓存对照,量化分析长上下文场景中缓存对Token消耗、首字延迟及费用的影响。强调不盲信“缓存折扣”,需控制变量(模型、提示词、上下文等)并记录完整指标,确保结论可复现、可验证。(239字)

我会用冷缓存和热缓存做两次测试

这是一次个人使用后的测试记录。遇到“缓存能省多少”这类问题时,我不会只跑一次请求就下结论,因为第一次和后续请求的输入构成可能完全不同。

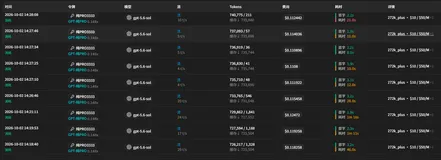
下面这条调用记录中,输入总量为 771,144 Token,缓存输入为 770,560 Token,输出为 37 Token。按记录计算,未缓存输入只有 584 Token。这个样本说明了高缓存输入可以存在,但不能证明所有提示词、所有模型或所有时间段都会得到同样结果。

长上下文调用记录,展示高缓存输入样本

冷缓存和热缓存要分开记

我会用相同的模型、提示词、工具定义和上下文,至少测试两类请求:

测试类型 我会观察什么
冷缓存请求 初次请求的输入、输出、首字时间和最终费用
热缓存请求 缓存输入是否出现,费用结构和首字时间是否变化

如果两次请求的上下文内容、模型或渠道不同,那么即使费用有差异,也很难确定差异来自缓存。

不把“缓存”当作黑盒宣传词

对我来说,缓存是可通过数据验证的变量。它可能受提示词前缀、上下文改动、模型设置和平台规则影响。高缓存样本意味着应该继续测试,而不是可以直接写成“固定折扣”。

为了让测试更容易复盘,我会把模型、请求时间、输入总量、缓存输入、输出、首字、总耗时和最终费用放在一起记录。这样下次缓存没命中时,至少能定位是哪一项条件发生了变化。

统一入口的作用是便于重复比较

当我需要重复切换模型或渠道测试时,更在意能否连续查看调用记录、价格和用量,而不是只看一次返回结果。页面上的模型入口、价格信息和使用数据能让我少做一些来回确认,但结论仍然要建立在自己的真实请求上。

多模型 API 统一入口页面截图

如果你的任务是长文档分析、代码 Agent 或固定系统提示词,这种冷缓存与热缓存的对照测试很值得做。本文是个人测试方法整理,图片和数字仅反映 2026 年 10 月 2 日的样本,实际缓存规则、模型能力、价格和账单以使用时页面为准。

目录
相关文章
|
20天前
|
人工智能 缓存 测试技术
我会怎样给一个 AI 接口做小规模压测
本文分享AI接口小规模压测的实操方法:分短/中/长三类输入,区分冷热缓存;固定模型、提示词、网络等变量;统计首字延迟、总耗时、Token、费用与失败率;最后用小流量验证迁移风险。重实践、可复现。(239字)
71 2
我会怎样给一个 AI 接口做小规模压测
|
20天前
|
缓存
长上下文调用便宜不便宜先看这两个Token
本文复盘长上下文调用成本误区:关键不在总输入Token(78.8万),而在未缓存输入(仅1665)。须拆解“总输入-缓存输入”,再结合三部分计价(未缓存/缓存/输出)分析费用。附实操检查五步法,助精准归因成本波动。(239字)
87 1
|
1月前
|
机器学习/深度学习 前端开发
发动机故障诊断智能体(三):特征可分性优化与加权对比投影层
在基础时序编码网络完成对正常工况的压缩表征后,尽管模型具备了提取稳态规律的能力,但在面对多种不同类型的微量气路故障时,潜在空间中的特征分布仍可能存在相互交叠的现象。该组件致力于通过引入度量对比学习机制,在特定的低维投影空间内重塑特征拓扑结构,系统性优化不同故障模式之间的几何可分性。
|
25天前
|
人工智能 安全 搜索推荐
人气爆棚!2026 云栖大会“AI Agent 原生操作系统”分论坛精彩回顾来啦
线下展区人潮涌动,超千人参与互动,分论坛现场座无虚席。
|
5天前
|
人工智能 缓存 测试技术
阿里云Qwen3.8-Omni-Flash大模型介绍:模型能力、功能、适用场景、收费标准与便宜购买技巧
能听会看、还能说话?qwen3-omni-flash 是阿里云百炼的多模态选手:采用 Thinker-Talker MoE 架构,支持文本、图像、音频、视频输入及文本、语音输出,覆盖 119 种语言文本、20 种语音交互,最大上下文 65,536 Tokens(输入 49,152/输出 16,384)。支持 Function Calling,结构化输出、联网搜索、缓存与批量推理均不支持,输入限文本加单一模态,音视频≤150 秒。价格上,文本输入 1.8 元/百万 Tokens,纯文本输出 6.9 元,语音回复 62.6 元,以控制台为准。
|
8天前
|
存储 人工智能 安全
阿里云 2026 DeepSeek Harness 技术详解:开源 Agent 运行框架,Cordis 插件内核与本地部署实操指南
在AI智能体快速落地的阶段,很多开发者会陷入一个困境:市面上现有的Agent工具大多是封装完整的成品应用,模型调用逻辑、工具执行循环、存储会话机制全部写死在底层,开发者只能调整表层参数,一旦业务需要自定义任务调度规则、替换沙箱执行环境、改造模型接入适配器,修改成本极高,很难适配项目的个性化需求。DeepSeek Harness,简称dsh,是开源的生产级AI智能体执行脚手架,遵循“Agent = 模型 + Harness”的工程范式,大模型负责推理思考,而Harness作为控制中枢,承担环境交互、工具契约管理、安全沙箱、持久化记忆、任务循环调度的全部工作。
351 1
|
10天前
|
人工智能 监控 API
阿里云千问大模型免费使用攻略:网页端体验 + API 调用完整实操教程
千问大模型的免费体验分为网页端和API新人额度两条路径。普通用户通过网页端零配置即可完成文档解析、问答创作;开发者领取API免费Token,通过curl、Python脚本实现模型调用,完成原型开发。使用过程中,开启额度用尽自动停止是重中之重,可以规避意外扣费风险。整套方案可以帮助零基础用户低成本熟悉大模型能力,完成学习、创意创作、AI原型验证等各类需求。
479 1
|
13天前
|
缓存 BI 测试技术
2026通义千问Qwen3.7-Max全解:Agent智能体底座,架构拆解与API实操教程
随着智能体应用快速落地,面向长周期自主任务的大模型成为开发选型的重点,新版通义千问Qwen3.7‑Max作为旗舰文本大模型,主打Agent智能体底座能力,在复杂推理、工程代码开发、超长文档处理、多轮工具调用等方面进行大规模优化,能够支撑长时间连续自动化任务。很多开发者在初次接触该模型时,容易混淆它与同系列其他版本的能力差异,不清楚MoE混合专家架构的运行逻辑,在API接入、工具调用编排时遇到参数配置、返回格式异常等问题。本文将从核心功能、底层技术架构、实操使用方法三个维度完整解析Qwen3.7‑Max,附带可直接运行的API调用代码,讲解参数配置方法,梳理开发过程中的限制条件与避坑要点,帮助开
360 2
|
12天前
|
存储 缓存 安全
阿里云服务器2核8G/4核16G/8核32G价格指南:实例规格、带宽、云盘收费标准与活动价格
本文将围绕2026年阿里云服务器2核8G、4核16G、8核32G的最新标准收费、活动价格、实例规格选择、带宽与云盘成本、优惠购买方式及注意事项展开系统说明,为采购决策者提供更具参考价值的购买依据。
|
14天前
|
存储 人工智能 弹性计算
阿里云服务器新购、续费、升级活动:38元轻量,新购续费同价+优惠券补贴等热门活动介绍
2026年阿里云云服务器优惠政策趋于多元化、精准化与长期化:以38元轻量服务器、99元e实例、199元u1实例构成入门锚点,以"新购续费同价"消除长期成本不确定性,并以1至5年阶梯折扣(最低2.4折)鼓励深度承诺,叠加优惠券、达量返券、学生券等工具。成本优化关键不在抢最低价,而在读懂优惠边界与互斥规则,找到匹配自身节奏的最优组合。

热门文章

最新文章