长上下文调用便宜不便宜,先看这两个 Token
这是一次个人项目中的调用复盘。处理长文档、代码仓库或大量工具定义时,我最早只会看“总输入 Token 有多少”。后来发现,这个数字对判断成本不够用,真正需要先拆开的,是缓存输入和未缓存输入。
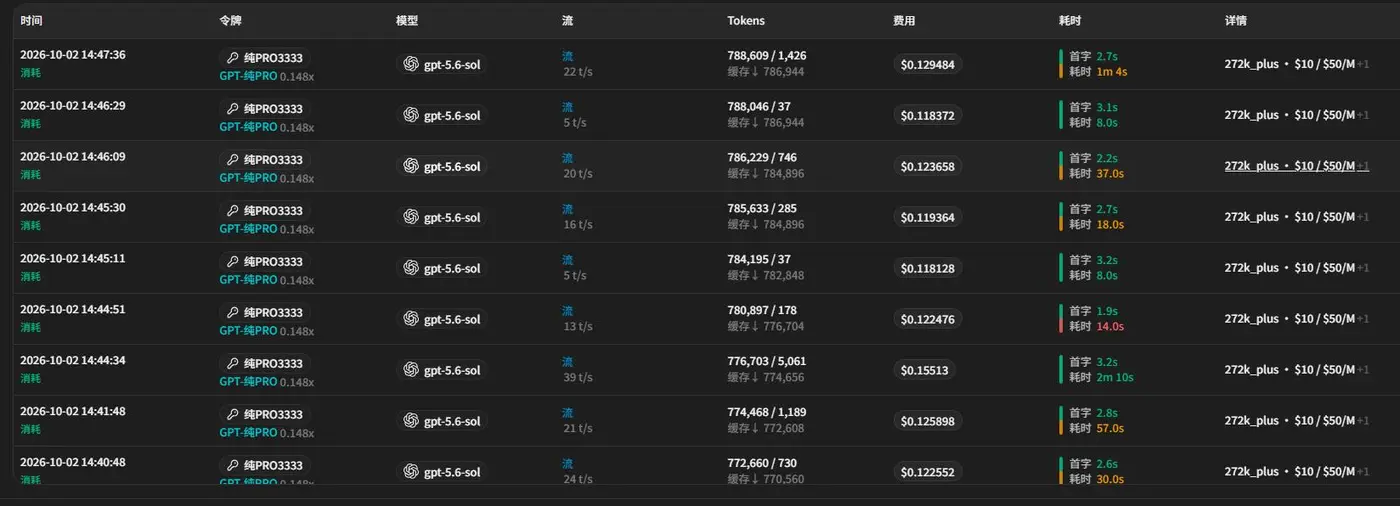
下面是一条长上下文调用记录:输入总量为 788,609 Token,缓存输入为 786,944 Token,输出为 1,426 Token。输入看起来接近 79 万 Token,但未缓存输入只有 1,665 Token。只要不先做这一步相减,后续对费用的理解就很容易跑偏。
先分清总输入和未缓存输入
我现在会固定使用这个公式:
未缓存输入 = 输入总量 - 缓存输入
它能避免一个常见误解:把缓存输入当作额外 Token,或者把输入总量全部按常规输入价格估算。
长上下文任务里,缓存输入可能占绝大多数。费用是否合理,要继续结合三个部分看:
- 未缓存输入的数量与单价;
- 缓存输入的计价规则;
- 输出 Token 的数量与单价。
这也是为什么两次输入总量接近的请求,最终账单仍然可能不同。
再把价格信息和账单放到一起
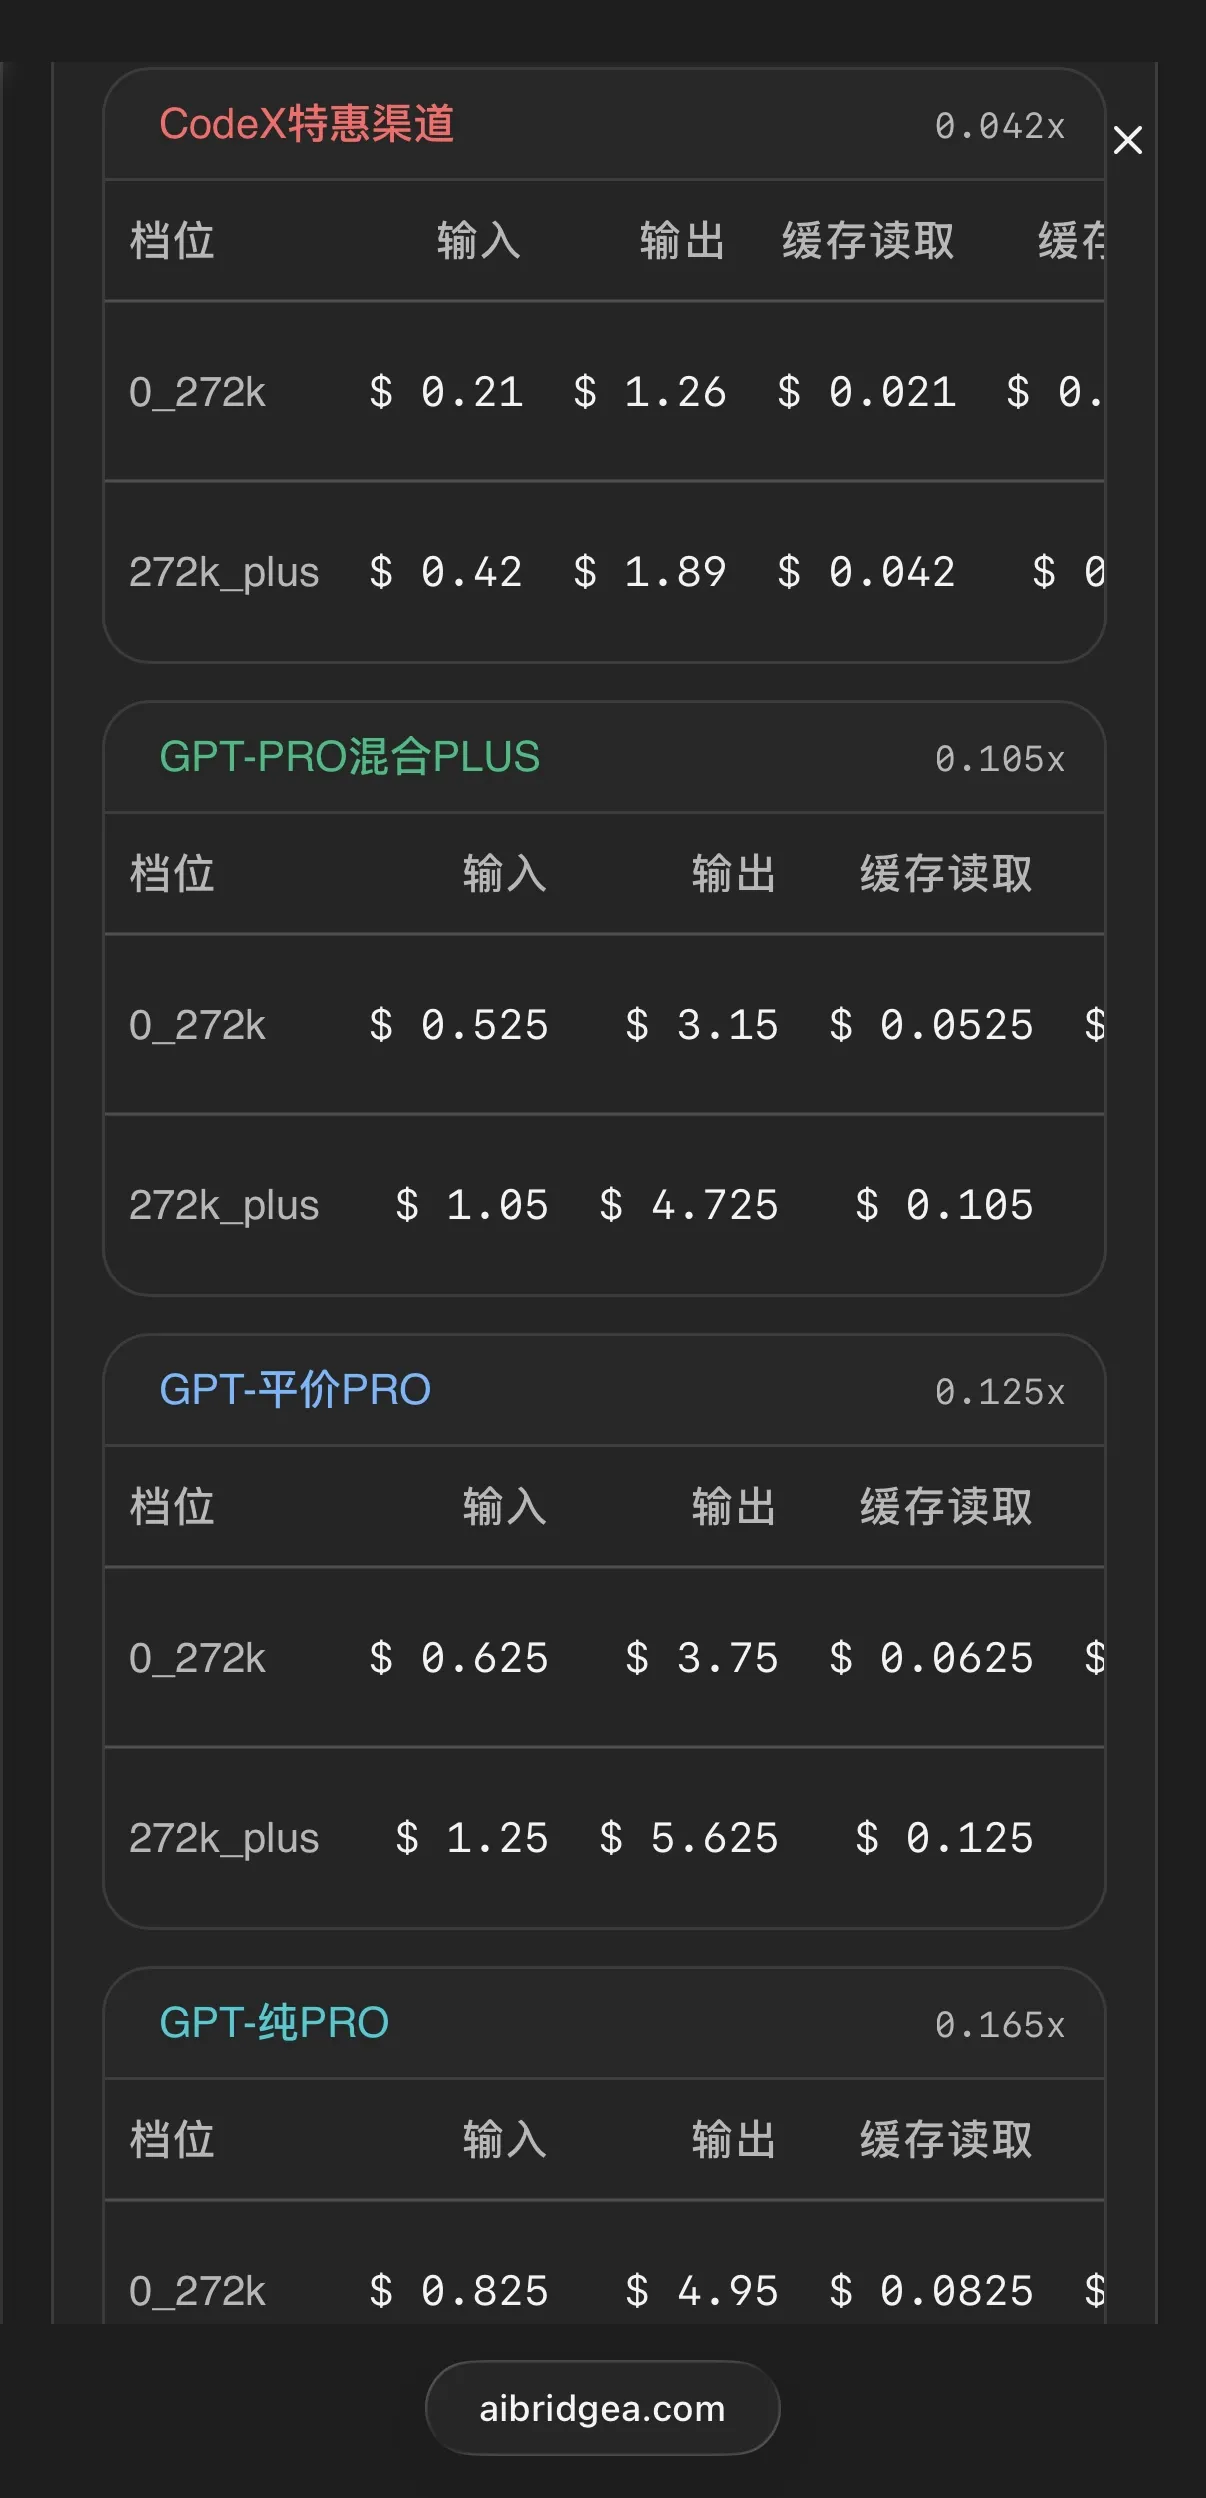
截图中的价格或倍率信息只适合告诉我“某个时间点可以怎么计算”,不能替代最终账单。模型、渠道、缓存计价、活动与倍率都可能变化。我会先看当前页面提供的候选项,再回到每次调用的输入、缓存、输出和最终费用做复算。
我的实际检查顺序
对于一条长上下文请求,我会按这个顺序判断:
- 输入总量是否符合任务预期。
- 缓存输入占比是否符合预期。
- 未缓存输入与输出是否有异常增长。
- 当时模型、渠道和倍率是否与测试条件一致。
- 最终费用能否用当时的规则大致复算。
这样做并不能保证未来每次请求都有相同成本,但能很快发现是提示词变长、缓存没命中、输出失控,还是价格配置发生了改变。
本文依据个人调用记录和页面截图整理。图中数据仅对应 2026 年 10 月 2 日的样本;模型、渠道、价格和实际账单应以使用时信息为准。