
前面的文章,我们已经分别介绍了 Context Engineering、Function Calling、Structured Output、RAG、Agent Loop、状态机和 Memory。这些能力单独使用时并不复杂。真正进入企业应用以后,问题变成:怎样把这些能力组合成一个真正可以被员工使用的知识助手?
早期企业知识助手通常可以概括为:上传文档 → 建知识库 → 用户提问 → RAG → 大模型回答。但到了 2026 年,这已经只能算知识库问答系统。一个真正完整的企业知识助手,还应该知道:
- 当前用户是谁,可以访问哪些知识;
- 简单问题应该直接检索,复杂问题是否需要多轮 Agentic RAG;
- 答案依据了哪些原文;
- 什么时候应该查询数据库或业务系统,而不是继续搜索文档;
- 用户过去确认过哪些偏好和决策;
- 工具调用是否需要审批;
- 出错发生在检索、Tool、模型还是权限环节;
- 模型升级以后效果是否真的变好。
因此,企业知识助手真正需要建设的不是一个“聊天框”,而是一套:Knowledge + Agent + Tool + Memory + Governance组成的 AI 应用运行体系。
一、先明确:我们要开发的不是“企业版 ChatGPT”
一个常见误区,是把企业知识助手理解成:给通用大模型增加一个企业知识库。这种产品当然有价值,但能力边界仍然比较窄。例如员工问:“上海地区销售人员出差住宿标准是多少”?普通 RAG 可以很好地回答。但如果继续问:“我下周要去上海参加客户交流,根据公司制度帮我确认预算,并查询当前项目还有多少差旅预算,如果足够就生成一份出差申请”。任务已经发生变化。系统至少需要:
| 需求 | 需要的能力 |
|---|---|
| 查询差旅制度 | RAG |
| 查找适用地区和人员标准 | Metadata / Permission Filter |
| 查询项目剩余预算 | Tool / Business API |
| 理解用户和当前项目 | Context / Memory |
| 生成出差申请 | Structured Output |
| 提交申请 | Tool Calling |
| 高风险提交前确认 | Human-in-the-Loop |
| 记录整个执行过程 | Trace |
所以企业知识助手真正的演进是:Knowledge Assistant → Enterprise Agent知识仍然是核心,但已经不是全部。
二、一个完整企业知识助手应该具备哪些能力
可以把系统能力分成五层。
| 层次 | 核心能力 |
|---|---|
| 交互层 | 对话、多轮、流式输出、文件上传 |
| Agent 层 | 意图判断、路由、规划、Tool Calling |
| Knowledge 层 | RAG、Agentic RAG、Citation、Metadata |
| Context 层 | Session、State、Memory、Workspace |
| Governance 层 | Permission、Audit、Trace、Evaluation |
这五层有一个非常重要的分工:Knowledge 层负责“知道什么”;Agent 层负责“下一步做什么”;Governance 层负责“允许做到什么”。因此,一个比较完整的架构可以设计为:
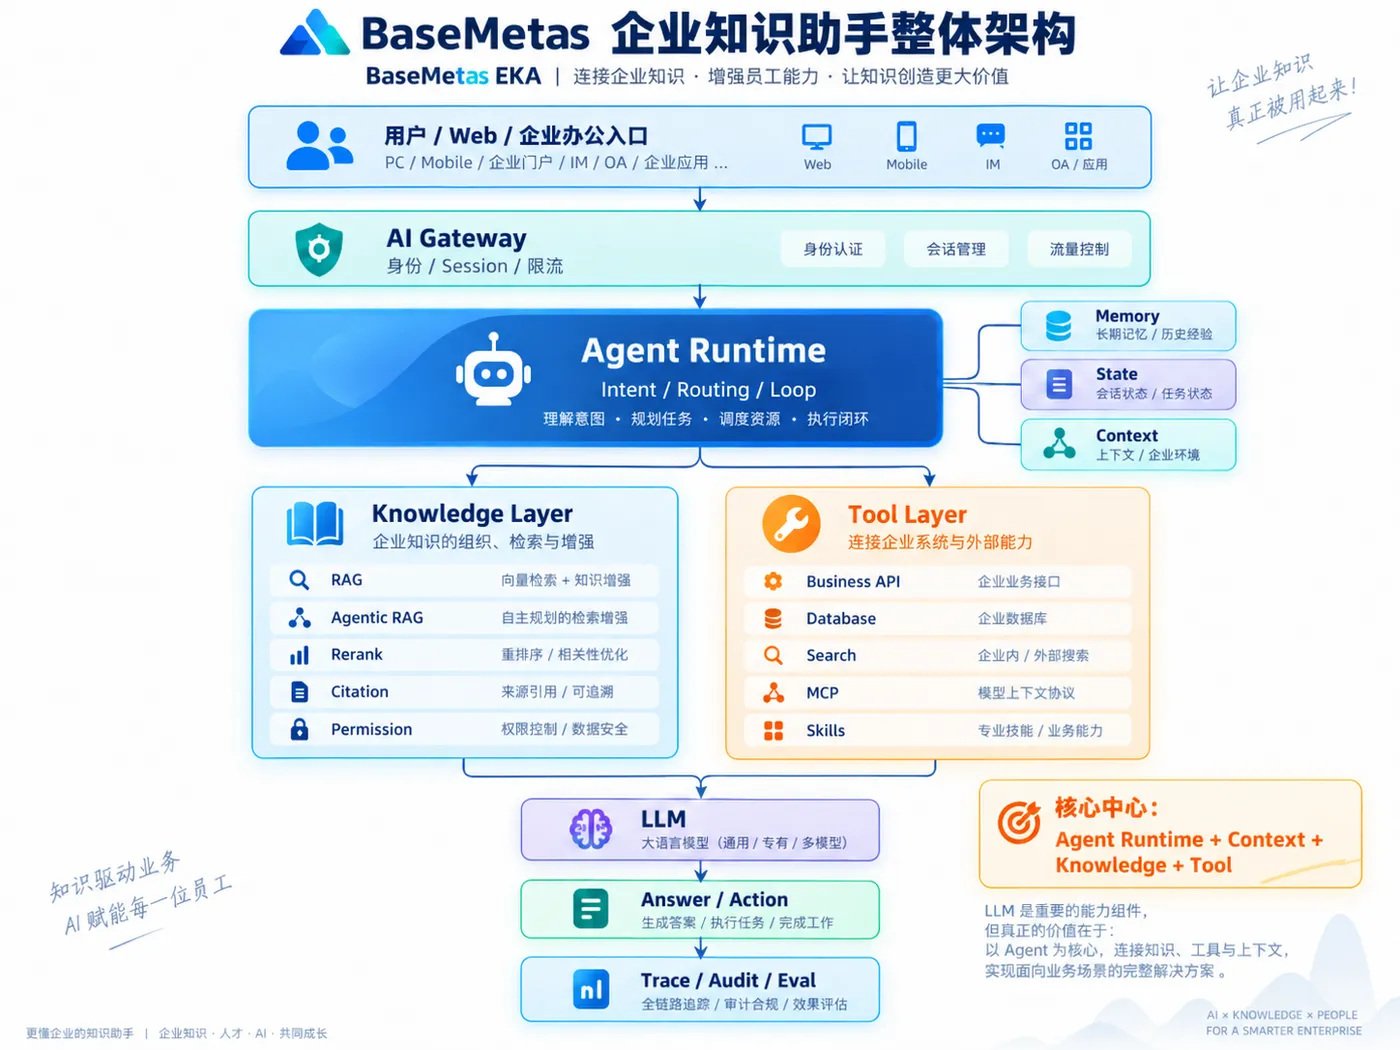
三、知识层:从“每次都 RAG”升级为按复杂度选择策略
前面的 RAG 文章已经介绍过 Hybrid Search、Rerank、Query Rewrite 和 Agentic RAG,这里不再重复原理。完整企业知识助手真正需要解决的是:什么时候用哪一种检索方式?一个简单策略可以是:
| 问题类型 | 推荐方式 |
|---|---|
| 简单制度查询 | Traditional RAG |
| 精确编号 / 产品编码 | Keyword + Metadata |
| 多文档综合 | Agentic RAG |
| 多条件筛选 | Agentic RAG |
| 数据计算 | RAG + Tool / SQL |
| 实时信息 | Tool / Search |
| 企业系统数据 | Connector / API |
也就是说,不应该设计成:
所有问题
→ Vector Search
→ LLM
而应该先进行 Routing。例如:
if query.type == "simple_knowledge":
    return rag.search(query)

if query.type == "complex_knowledge":
    return agentic_rag.run(query)

if query.type == "business_data":
    return tool_agent.run(query)
2026 年 Agentic RAG 已经开始成为正式产品能力。腾讯云 ADP 当前的 Agentic RAG 可以自主规划检索策略、反思首次结果并进行多轮检索;其知识库检索 Agent 还能组合知识检索、SQL 和计算工具处理跨文档以及数据分析问题。这意味着现代企业知识助手正在从:Retrieval Pipeline升级到:Retrieval Decision System
四、知识库本身也在发生变化:Metadata 正在变得越来越重要
传统知识库主要保存:Chunk、Embedding、DocumentId。但企业数据通常具有非常明确的业务属性:产品、部门、地区、版本、生效时间、文档类型、密级、作者、租户。这些数据应该成为 Metadata。例如:
{

  "department": "销售部",
  "region": "上海",
  "effectiveDate": "2026-01-01",
  "documentType": "差旅制度"
}
用户询问:“上海销售人员当前住宿标准”。系统首先就可以过滤:
department = 销售部
region = 上海
effectiveDate <= today
然后再执行语义搜索。这样往往比单纯依赖 Embedding 更准确。2026 年 9 月腾讯云 ADP 已经进一步把 Metadata 引入知识库召回,同时增加知识源定时更新能力,这也说明企业 RAG 正从单纯“向量相似度”继续走向结构化过滤 + 内容检索 + 知识生命周期管理。
五、权限过滤必须发生在检索之前
企业知识助手和公共知识问答最大的区别之一,就是:同一个问题,不同用户可能看到不同答案。例如:员工→ 可以查询普通制度;部门经理→ 可以查询部门经营资料;财务人员→ 可以查询财务制度和预算;高管→ 可以访问经营分析材料。因此不能设计成:检索整个知识库→把内容交给 LLM→最后再判断能不能展示。因为敏感内容已经进入模型 Context。正确方式应该是:User Identity+Tenant / Department / Role→Permission Filter→Allowed Knowledge Scope→Retrieval。也就是说:Permission 是 Retrieval 的前置条件,而不是答案生成后的过滤器。对于多租户系统,还必须保证:Tenant A的 Chunk 在任何情况下都不会进入:Tenant B 用户的 Candidate Recall。这是企业知识助手必须坚持的安全边界。
六、引用不是 UI 装饰,而是答案的数据结构
一个企业知识助手回答:“上海住宿标准为 600 元 / 晚” 还不够。真正可靠的答案应该包含:答案+Evidence+Citation。例如:
上海地区普通员工住宿标准:
600 元 / 晚。

依据:
《2026 年差旅管理办法》
第三章第 12 条
第 8 页
因此 Retriever 返回的不能只是:content 还应该保留:documentId、documentName、version、page、section、chunkId、score。最终 Answer 可以设计为:
record KnowledgeAnswer(
    String answer,
    List<Citation> citations,
    double confidence
) {
   }
这实际上把前面 Structured Output 的思想重新带回来了:企业知识助手的最终输出不是一段字符串,而是“答案 + 证据”的结构化结果。
七、Tool:当知识库不能回答时,不要继续搜索知识库
这是知识助手升级为 Agent 最重要的一步。例如用户问:“我的报销申请现在审批到哪里了”?这个答案根本不应该来自 RAG。它来自:审批系统 API。再例如:“项目还剩多少预算”?应该查询:Project / Finance System。因此 Knowledge Assistant 至少需要:Knowledge Tool、Business Tool
、Search Tool、Calculation Tool,模型根据问题选择能力。例如:
查询差旅制度
→ search_knowledge

查询剩余预算
→ get_project_budget

提交出差申请
→ create_travel_request
OpenAI 当前 Responses API 已经把 file_search、Function Calling、Web Search、远程 MCP 等工具统一到同一工具体系中;其中 file_search 本身支持语义和关键词检索,并由平台托管执行。DeepSeek 当前同样支持 Tool Calls,并提供 strict 模式来约束模型严格按照 Function JSON Schema 生成参数。这说明 Tool Calling 已经逐渐成为现代 Agent 的基础设施,而不再是某个特定框架的附加能力。
八、MCP 正在成为企业知识助手连接外部能力的重要接口层
如果每接一个系统都自己设计:CRM Adapter、OA Adapter、ERP Adapter、Git Adapter、Database Adapter,企业 Agent 很快会进入大量重复集成工作。MCP 的价值,就是逐渐把:Agent ↔ Tool / Data之间的连接方式标准化。
当前 OpenAI 的工具体系已经支持 Remote MCP,并且可以对 MCP Tool 设置自动执行或显式审批;私有网络中的 MCP Server 也可以通过 Secure MCP Tunnel 接入,而不必把内部服务直接暴露在公网。
2026 年 7 月发布的 MCP 2026-07-28 规范又进一步增加了:
- Stateless Protocol Core;
- Multi Round-Trip Requests;
- Cacheable List Result;
- Extensions;
- Authorization Hardening。
这使 MCP 更接近真正适合企业网关、负载均衡和权限体系的 Agent 基础协议。因此企业知识助手中的 Tool Layer 可以逐渐演进为:
Agent Runtime
      │
      ▼
MCP / Tool Gateway
      │
 ┌────┼────────┐
 ▼    ▼        ▼
OA   CRM      ERP
而不是在 Prompt 中硬编码几十个业务接口。
九、Memory:让助手认识用户,但不要污染企业知识
上一篇已经专门讨论过 Memory,这里只关注它在企业知识助手中的位置。企业知识助手通常至少会使用两种 Memory:
Session Memory
解决:“我们刚才聊到哪里了?”
User Long-term Memory
解决:“这个用户长期有什么稳定偏好?”
例如:用户习惯中文回答、用户是研发人员、常用项目为 Project-A。但需要特别注意:用户 Memory 与企业 Knowledge 必须分开。用户说:“我记得公司报销标准是 800”。不能因为这句话被长期记忆,就污染正式企业知识库。正确优先级应该是:Authoritative Knowledge>Business System Data>User Memory。Memory 可以帮助 Agent:理解用户,但不能替代企业事实来源。
十、把这些能力组合起来:一次完整请求到底怎样执行
来看一个完整例子。用户说:“我下周要去上海参加客户交流,根据公司制度看看我的住宿预算,再查一下 Project-A 还有多少差旅预算,如果够的话帮我生成出差申请”。系统首先识别:用户身份
、项目 = Project-A、目标 = 出差申请。接下来并不是简单执行一次 RAG。
第一步:查询制度
通过 Permission-aware RAG:差旅制度+地区 = 上海+用户职级获得住宿标准,并保存 Citation。
第二步:查询业务数据
发现“剩余项目预算”不属于知识库,于是调用:get_project_budget("Project-A")获得实时预算。
第三步:进行计算与判断
Agent 综合住宿标准+出差天数+剩余预算计算预算是否满足要求。
第四步:生成结构化申请
利用 Structured Output 生成:
{

  "project": "Project-A",
  "city": "上海",
  "hotelBudget": 1800,
  "reason": "客户交流"
}
第五步:人工确认
因为:create_travel_request会改变真实业务状态,因此进入 Human-in-the-Loop:是否提交?用户确认后,再真正调用业务系统。这一个场景已经把前面几篇内容全部连接起来:
| 能力 | 在本场景中的作用 |
|---|---|
| Context | 当前用户和目标 |
| RAG | 查询制度 |
| Citation | 给出制度依据 |
| Memory | 用户和项目偏好 |
| Tool Calling | 查询预算 |
| Structured Output | 生成申请数据 |
| State | 保存当前执行进度 |
| Human Approval | 提交前确认 |
这才是“完整企业知识助手”的真正含义。
十一、代码层不需要写一个巨大的 KnowledgeAssistant
从工程实现看,不建议把所有逻辑都塞进一个KnowledgeAssistantService。更合理的是拆成稳定能力。例如:
interface KnowledgeRetriever {

    RetrievalResult search(
        Query query,
        UserContext user
    );
}

interface MemoryService {

    List<Memory> recall(
        UserContext user,
        String query
    );
}

interface ToolExecutor {

    ToolResult execute(
        ToolCall call,
        UserContext user
    );
}
Agent Runtime 只负责编排:
var context =
    contextAssembler.build(
        user,
        session,
        memoryService,
        currentTask
    );

var result =
    agent.run(
        context,
        knowledgeRetriever,
        toolExecutor
    );
关键不是这几行 API,而是避免形成:
Controller
→ Prompt
→ LLM
→ String
这种难以扩展的结构。企业知识助手应该拥有独立的:Knowledge、Memory、Tool、Session、Permission、Trace服务边界。
十二、流式输出不仅要流 Token,还要流“执行状态”
普通 Chatbot 的 Streaming:
Token
Token
Token
就够了。
Agent 型知识助手则更适合向前端传递:
正在理解问题
正在检索知识库
找到 12 条候选资料
正在重新排序
正在查询业务系统
等待人工确认
正在生成最终答案
也就是说 Streaming 的对象正在从:文本流扩展成:Agent Event Stream。例如前端可以接收:
{

  "type": "retrieval_started"
}
或者:
{

  "type": "tool_completed",
  "tool": "get_project_budget"
}
这样用户看到的不是一个长时间旋转的 Loading,而是 Agent 当前实际在做什么。
十三、可观测性:企业知识助手必须能够回答“为什么这样回答”
普通日志只记录:
Question
Answer
远远不够。
完整 Trace 至少应该包含:
Original Query
Rewritten Query

Retrieved Documents
Retrieval Score
Rerank Result

Memory Recall

Model Calls

Tool Calls
Tool Result

Permission Decision

Citation

Token
Latency
Cost

Final Answer
OpenAI 当前 Agents SDK 的 Trace 可以记录模型调用、Tool Call、Handoff 和 Guardrail;官方也建议先通过 Trace 调试 Agent 行为,再进入系统化 Eval。
当用户说:“这个答案为什么错了”?系统才能判断到底是:
知识没有入库?
权限过滤错了?
Query Rewrite 错了?
Retriever 没召回?
Rerank 排错?
Tool 返回错误?
还是模型推理错了?
这也是 Agent 可观测性与普通 API 日志最大的区别。
十四、Evaluation:知识助手上线以后不能只看“用户觉得还行”
传统软件测试往往强调:Input → Expected Output,但 Agent 具有不确定性,不能只靠几个人工 Demo 验证。至少应该建立一套企业 Golden Dataset:
问题
期望答案
允许访问的知识
必须引用的来源
不允许访问的内容
需要调用的 Tool
期望行为
评估维度可以包括:
| 维度 | 示例 |
|---|---|
| Retrieval Recall | 正确文档是否召回 |
| Citation Accuracy | 引用是否真的支持答案 |
| Answer Correctness | 最终回答是否正确 |
| Permission | 是否发生越权检索 |
| Tool Selection | 是否选择正确 Tool |
| Task Completion | 是否真正完成用户目标 |
| Cost / Latency | 代价是否可接受 |
现代 Agent Eval 也正在从只评价最终答案,转向评价完整执行轨迹。OpenAI 当前的 Agent Evaluation 就支持基于 Trace 对模型调用、Tool Call、Guardrail 和 Handoff 等流程行为进行评分。因此:企业知识助手的质量不是一个 Prompt 的质量,而是一整条执行链的质量。
十五、安全治理:越强的知识助手,越需要确定性的边界
当知识助手只回答文档问题时,风险主要是:答错。当它开始拥有 Tool 后,风险会变成:做错。
因此 Tool 应该分级。
| Tool | 风险 |
|---|---|
| search_knowledge | 低 |
| query_database | 中 |
| create_document | 中 |
| send_email | 高 |
| submit_approval | 高 |
| delete_data | 极高 |
可以建立:Read Tool→ 自动执行;Write Tool→ 权限校验;High-risk Tool→ 权限 + Human Approval。同时必须防止:Prompt Injection;越权检索;Tool 参数注入;Memory Pollution;敏感数据进入 Trace;MCP Server 获得过宽权限。
最新 MCP 规范也持续强化 Authorization,2026-07-28 版本进一步加入了授权硬化和正式扩展体系;Enterprise-Managed Authorization 也已经稳定,用于集中管理企业 MCP 授权。因此企业知识助手真正需要的是:Agent 自主决策 + 最小权限 + 确定性安全边界。
十六、2026 年的企业知识助手正在发生哪些变化
把最近的发展放在一起,可以看到几个非常清晰的趋势。
第一,RAG 正在 Agentic 化
简单问题继续使用传统 RAG;复杂问题开始让 Agent 自主规划、多轮检索和交叉验证。
第二,知识库正在结构化
Metadata、权限、版本和知识更新时间越来越重要,不再只关注 Embedding。腾讯云 ADP 在 2026 年 9 月已经新增知识库 Metadata 与知识源定时更新。
第三,Tool 连接正在标准化
Function Calling 仍然重要,但 MCP 正逐渐成为连接企业数据与业务系统的重要标准接口;2026 年 MCP 又继续强化了可扩展性、无状态部署和授权能力。
第四,Memory 开始成为独立服务
Memory 不再等于 History,而是拥有 Capture、Recall、Update、Forget 和 Scope。
第五,质量治理从 Answer 转向 Trace
不只评价模型最后说了什么,还需要评价:它为什么检索这些知识、为什么调用这个 Tool,以及整个任务是否正确完成。
这些变化共同说明:企业知识助手正在从“知识库前面的聊天界面”,演变成企业 Agent 的统一知识与任务入口。
十七、不要一开始就把所有能力全部打开
即使拥有这些技术,也不意味着第一个版本就应该同时实现:Agentic RAG、GraphRAG、Memory、Multi-Agent、MCP、Workflow、几十个 Tool。更加合理的演进路径是:
第一阶段:可靠知识问答
重点完成:Permission-aware RAG + Citation + Trace
第二阶段:加入实时业务能力
增加:Tool Calling + Business API + Human Approval
第三阶段:提升连续性
增加:Session + Memory + State
第四阶段:处理复杂知识任务
增加:Agentic RAG + 多轮检索 + 数据计算
第五阶段:平台化治理
再建设:MCP Gateway + Eval + Cost + Audit + Tool Governance
这仍然符合本系列一直强调的原则:不要为了使用 Agent 而过度设计。先让系统可靠解决真实问题,再逐步增加自主性。
十八、小结
到这一篇,我们终于把前面介绍的能力真正组合在一起。一个完整的企业知识助手已经不再是:Knowledge Base+LLM而更接近:Enterprise Knowledge Agent = Knowledge + Context + Memory + Tool + State + Permission + Evaluation。其中:
- RAG 提供企业知识;
- Agentic RAG 解决复杂知识检索;
- Tool / MCP 连接真实业务系统;
- Memory 提供跨任务连续性;
- State 保存任务执行状态;
- Structured Output 让结果进入程序;
- Permission 限定可以看到和操作什么;
- Citation 让答案有据可查;
- Trace / Eval 让系统能够持续改进。
这也是为什么真正的企业知识助手不能只关注“回答是否像人”。更加重要的是:答案是否有证据、数据是否有权限、工具是否调用正确、操作是否可审计,以及整个任务是否真正完成。如果把第 6~14 篇连起来看,会得到一条非常清晰的技术路线:Context → Tool → Structured Output → RAG → Agent Loop → Framework → State → Memory → Enterprise Knowledge Agent。到这里,第三部分“第一个 Agent 应用”也基本完成了从基础组件到完整应用的闭环。
上一篇回顾:
https://developer.aliyun.com/article/1764067?spm=a2c6h.13148508.setting.16.30714f0eo4sTzc
下一篇将进入第四部分Agentic 智能体设计模式:
为什么 Agent 也需要设计模式
因为当一个 Agent 已经能够检索知识、调用工具、维护状态并完成真实任务以后,接下来的问题就不再是能不能做出来?而是:面对越来越复杂的任务,应该怎样组织 Agent 的推理、路由、并行、反思、规划和协作?这也将从“Agent 应用开发”正式进入“Agentic 智能体设计模式”。

