
@TOC
一次真实的 Linux 主机巡检脚本开发:5 条命令,从手工日志到可批量下发。
项目地址:https://qingxun.online
场景
需求:看这台主机磁盘是否快满、满了被什么占、docker 里的服务是否正常。手工敲的是:
df -h
du -sh /* 2>/dev/null
du -sh /var/lib/* 2>/dev/null
docker ps
docker logs --tail 20 qingxun
这 5 条是一条递进证据链:df 看满不满 → du 逐层定位到目录 → docker ps/logs 看服务有没有被影响。只自动化前三条,拿到的还是"磁盘 21%",没法直接行动。
1. 从手工日志生成主线描述
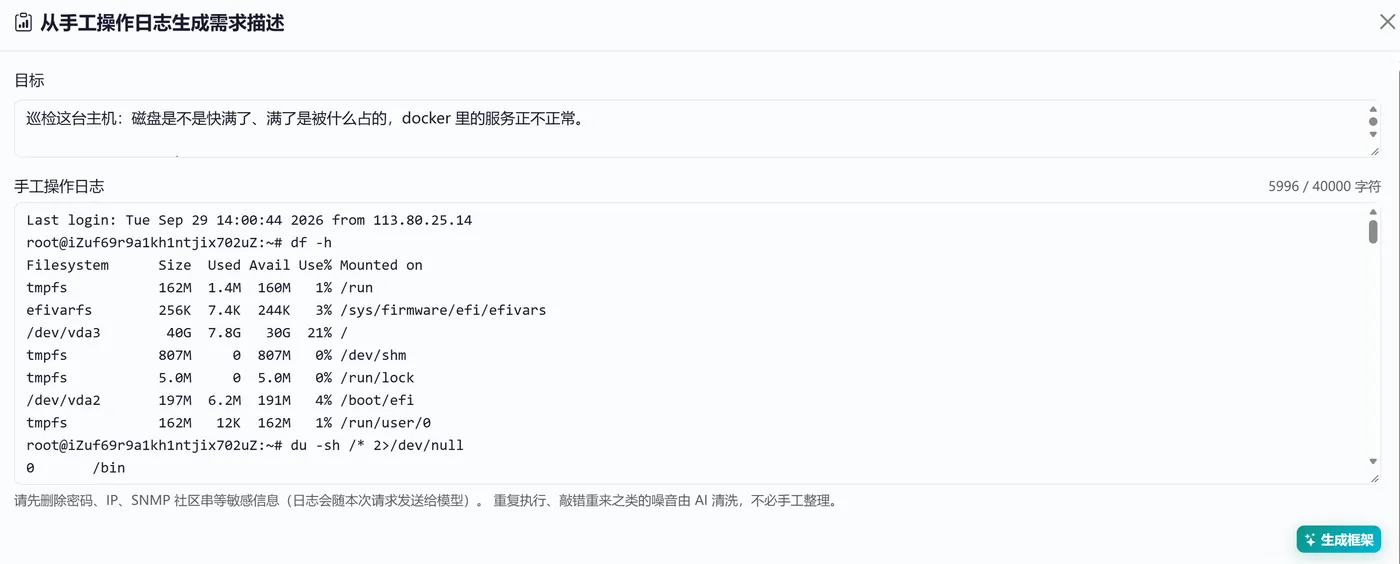
上面填一句目标,下面原样粘贴刚手工执行的会话(本次 5996 字符)。提示符、Last login 这类噪音不用清,AI 生成框架时会剥掉。注意日志会随请求发给模型,粘之前先删密码/IP。
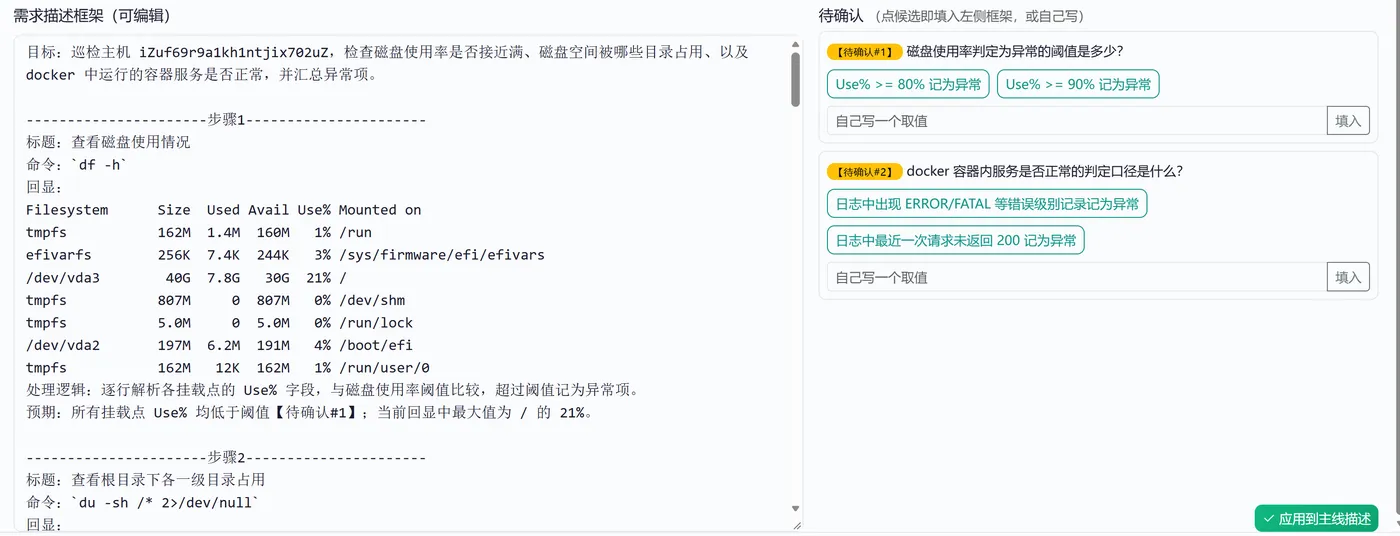
生成的框架按步骤整理成「命令 + 回显 + 处理逻辑 + 预期」。日志里只有事实、没有判据,所以 AI 把推不出的口径丢进右侧「待确认」:阈值取 80% 还是 90%、docker 日志出现 ERROR 算不算异常。点候选就地填进框架,再点「应用到主线描述」。本次阈值取 90%。
2. 自动化生成 → AI 测试 → AI 评估
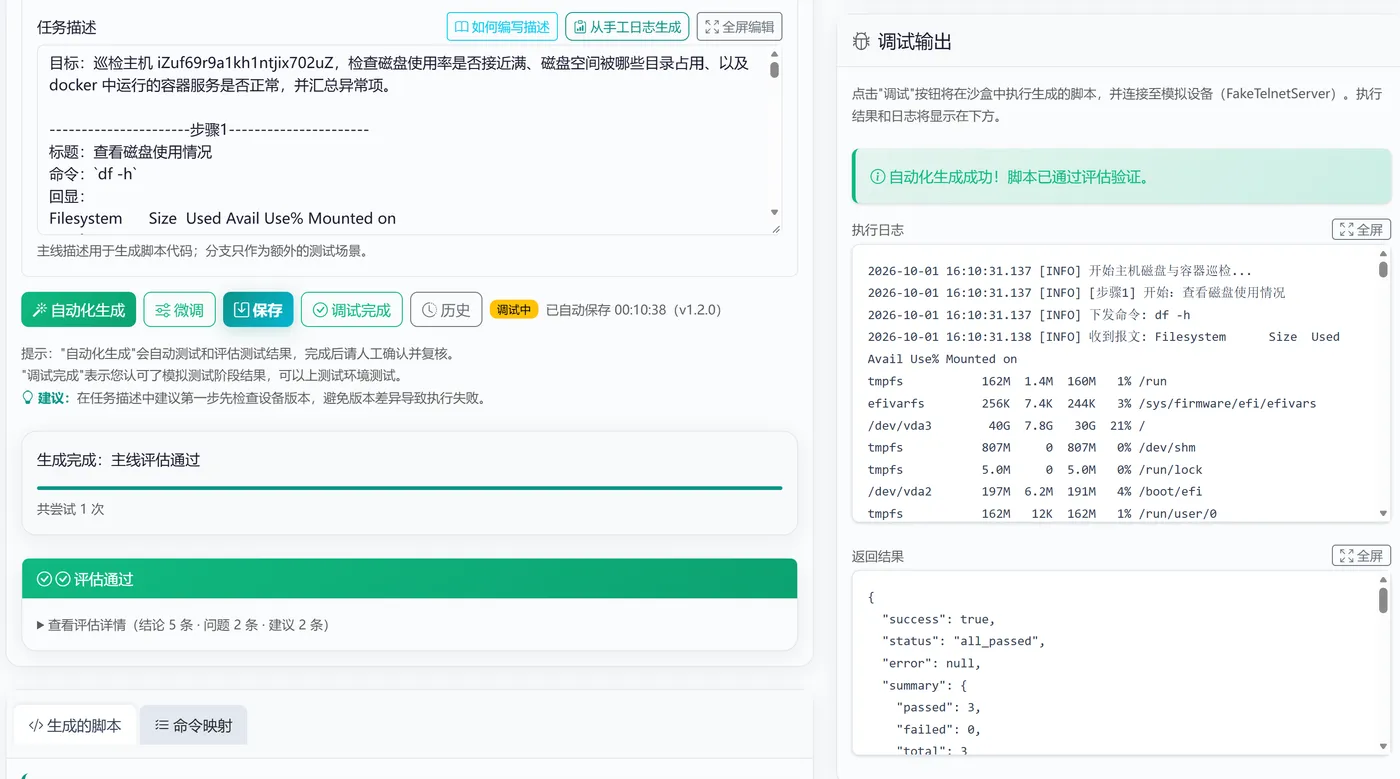
一个按钮跑完三步:
- 生成:按主线描述产出 Ruby 脚本和命令映射。
- 测试:沙箱加载脚本,连模拟设备,按命令映射回放报文——脚本下发
df -h,就返回需求里那段真实回显。映射里没有的命令会直接回not recognized。 - 评估:按需求拆出的条目逐条核对,不通过就带原因重新生成,最多 3 次。
本次首轮通过:评估通过(结论 5 条 · 问题 2 条 · 建议 2 条),3 个检查点全部通过,共尝试 1 次。状态是「调试中」。人工审核主要看日志,以及脚本结果
3. 输出脚本以及命令映射
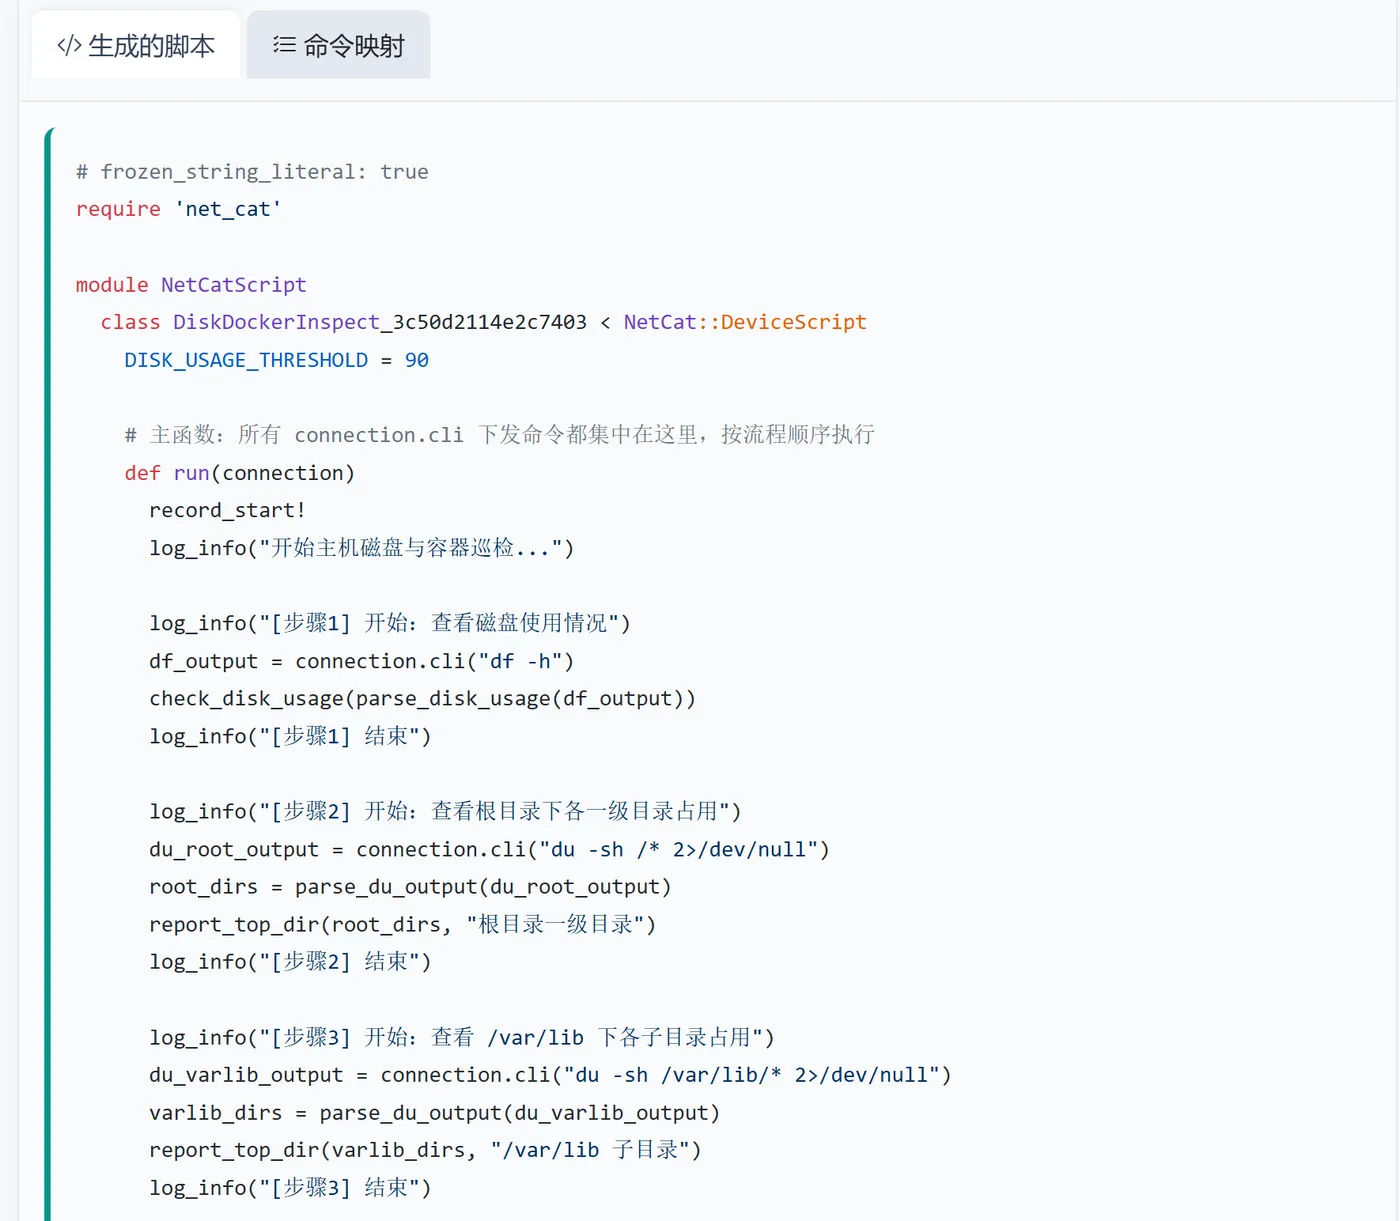
脚本:所有命令下发集中在 run 里,解析拆成独立函数。
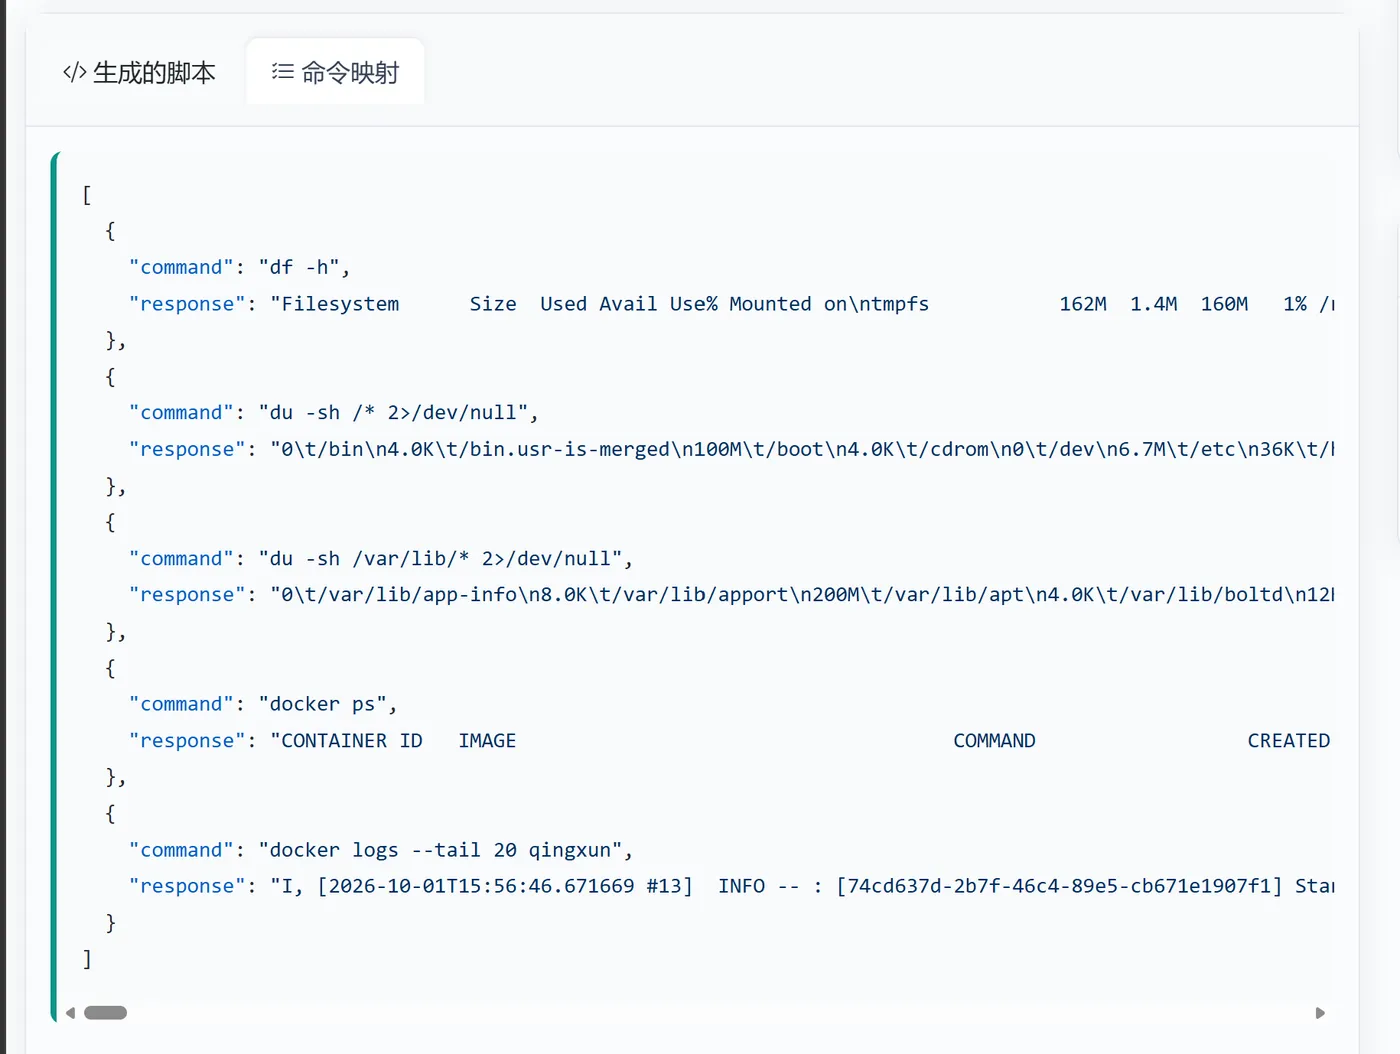
命令映射:脚本执行期间进行的交互报文
4. 客户端下载脚本,上机联调

客户端「我的脚本」→「同步脚本」。设备密码和回显都留在本地,不上云。
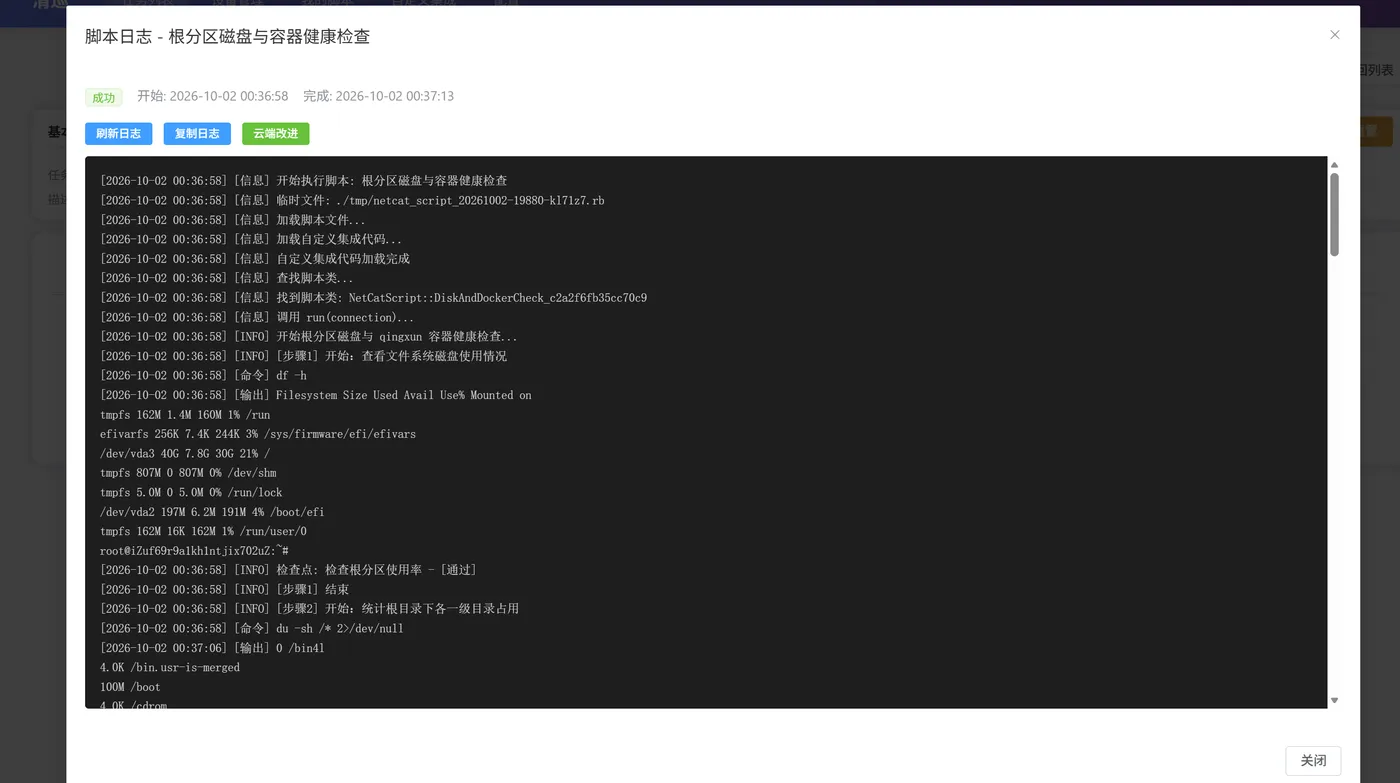
执行后看日志:检查点逐个落结论(检查点:检查根分区使用率 - [通过]),真机回显与模拟环境基本一致——这就是前面"回显原文照抄 + 命令映射"两步的回报。本次真机根分区 21%,远低于 90% 阈值,判定通过。
5. AI 改进
图 7 右上角的「云端改进」:如果脚本联机调试有问题,或者需要改进,把真机日志连同改进要求回传云端,AI 反推需求描述该怎么改,确认后再应用。于是形成闭环:
手工日志 → 需求描述 → 脚本 → 真机日志 → 改进描述 → 重新生成
设备回显默认不出本机,只有你点这个按钮时才送云端。
6. 标记脚本调试完成
回云端生成页点按钮条上的「调试完成」(见图 3):状态 调试中 → 调试完成,需要填写适配设备型号,版本可回滚。到此脚本才成为团队资产——客户端同步一次,就能批量下发给同型号的多台机器。
几个真正省事的点:
- 痛点不是生成代码,而是把需求说清楚。 所以重心在需求描述上,评估也按条目逐条核对。
- 待确认项是刻意留的。 阈值 80 还是 90、ERROR 算不算故障,日志里没有这些判据,只能由人定——比让模型猜一个数字、你再去代码里找要安全。
- 命令映射是调试环境的契约。 缺一条命令测试就回
not recognized,回显有出入测出来就和真机两回事。 - AI 通过 ≠ 免审核,真机跑通 ≠ 结束。 「评估通过」和「调试完成」是两个显式动作,中间夹着人工审核。
截图来自一次真实开发过程,涉及的 5 条命令见开头。
本轮脚本生成大概用时10分钟

