大家好,我是晚安code。
一、为什么说它是"普通话"
OpenAI 接口协议不是某家厂商写进标准文档的规范,它是被生态"投"出来的事实标准。
OpenAI 接口协议(OpenAI API Protocol):以 POST /v1/chat/completions 为核心的一组请求/响应约定。请求体按它的字段名发,服务端就按它的结构回。你可以理解成"跟模型说话用的普通话"——不是官方钦定的,是大家都这么说,说的人多了就成了标准。
最有意思的地方在于,国内几乎每家都开了"兼容模式"。
| 厂商 | 兼容端点 base_url | 认证方式 |
|---|---|---|
| OpenAI | https://api.openai.com/v1 |
Authorization: Bearer |
| DeepSeek | https://api.deepseek.com/v1 |
同上 |
| 智谱 GLM | https://open.bigmodel.cn/api/paas/v4 |
同上 |
| Kimi | https://api.moonshot.cn/v1 |
同上 |
| 通义千问 | https://dashscope.aliyuncs.com/compatible-mode/v1 |
同上 |
(2026 年 10 月核对,各家地址可能调整,用之前建议再扫一眼官方文档。)
注意通义千问那行的路径里带着 compatible-mode 四个字——这就是明牌告诉你:我们说的是方言,但给你配了个翻译。
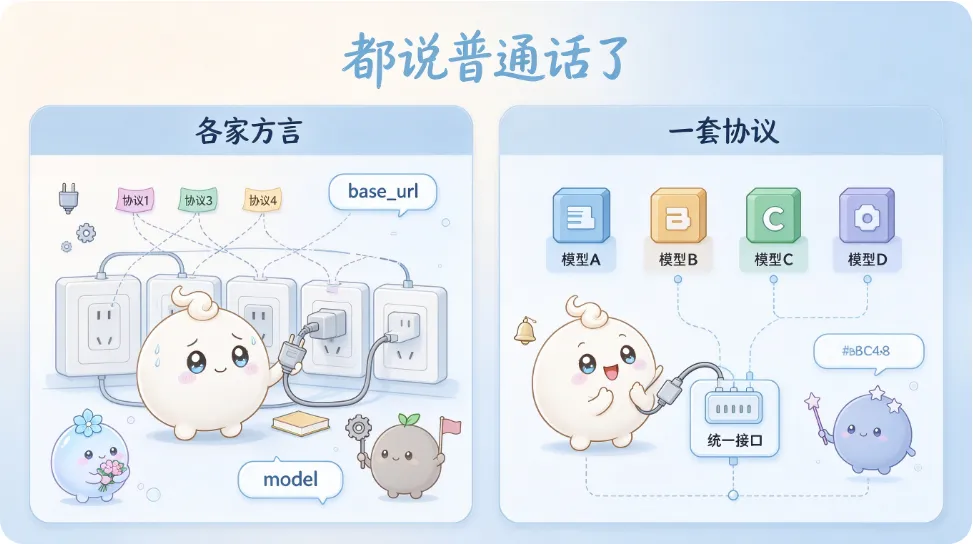
对 Java 开发者来说,这件事的现实收益很直接:你不用为每家模型写一套 SDK。一个 OpenAI 风格的客户端,改 base_url 和 model 就能横着走。
二、一条请求里到底装了什么
真正需要背下来的字段不超过八个,剩下的都是调优。
先看最小可用的一条请求,别看文档,看这个就够了:
{

  "model": "deepseek-chat",
  "messages": [
    {
   "role": "system", "content": "你是严谨的 Java 助手"},
    {
   "role": "user", "content": "HashMap 扩容为什么是 2 倍"}
  ],
  "temperature": 0.3,
  "stream": false
}
Java 侧用 OpenAI 官方出的 openai-java,写法是把这些字段装进一个 builder:
// 非流式:一次拿全量
ChatCompletionCreateParams params = ChatCompletionCreateParams.builder()
        .model("deepseek-chat")
        .addSystemMessage("你是严谨的 Java 助手")
        .addUserMessage("HashMap 扩容为什么是 2 倍")
        .temperature(0.3)
        .build();

ChatCompletion res = client.chat().completions().create(params);
String text = res.choices().get(0).message().content().orElse("");
params 那个对象,就是你跟协议打交道的地方。字段看着几十个,日常真正常用的就这几个:
| 字段 | 作用 | 我的建议 |
|---|---|---|
model |
指定用哪个模型 | 必填,别名写错直接 404 |
messages |
对话历史 | 必填,接口无状态,每次带全 |
temperature |
0~2 的随机性 | 写代码给 0.2~0.3,别用默认 |
max_tokens |
输出长度上限 | 别抠,给够;不够会被截断 |
stream |
流式开关 | 见下一节,这是重点 |
tools |
工具/函数定义 | Agent 场景必用 |
response_format |
强制 JSON 输出 | 要解析结构化结果时开 |
seed |
复现种子 | 只是"尽力",别指望完全一致 |
往下再挖一层,messages 里每条消息都带一个 role,四种:
system:人设和规则,放数组第一条;user:用户说的话;assistant:模型上一轮的回答,多轮对话时回填;tool:工具执行的结果,配合tools用。
有个坑要先说:这个接口是无状态的。它不记得你上一句说了啥,所谓"多轮对话"是你自己把历史消息一条条塞回 messages 数组。上下文越长,token 越贵——这不是模型贵,是你每次都在重发。
可能有人会问:
max_tokens到底填多少才合适?看你要它输出多长。写一段代码注释,512 够用;让它生成一个完整类,给 4096;做长文总结,直接拉满。填小了最典型的症状是回答说到一半硬生生断掉,
finish_reason会告诉你是length而不是stop——看到这个值就该调大了。
三、流式和非流式,Java 里差在哪
流式调用不是让总耗时变短,而是让用户更早看到第一个字。
SSE(Server-Sent Events,服务端事件推送):一种基于 HTTP 的单向流式传输格式,服务端可以持续往同一个响应里"推"文本行。大模型的逐字输出用的就是它。
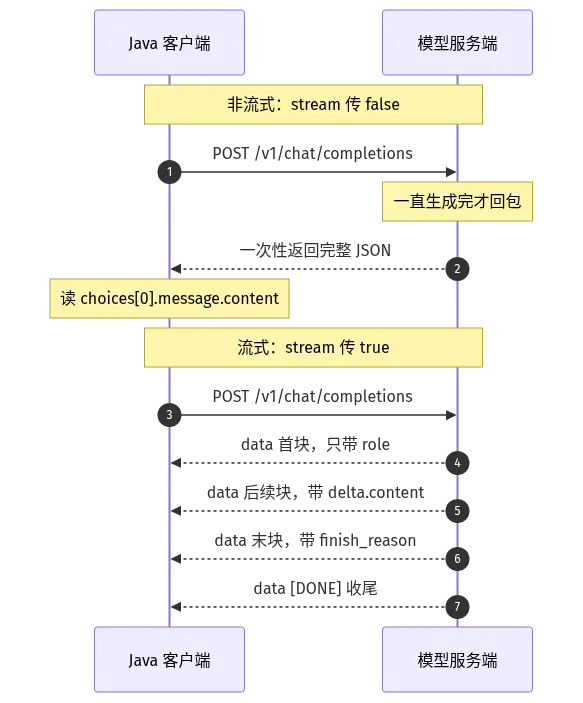
非流式的逻辑特别简单:请求发出去,服务端在那边憋着,把整段话生成完,一次性把 JSON 甩给你。中间那几秒到几十秒,你的 Java 线程就是在等。
流式就热闹了。stream: true 之后,服务端回的不是一个大 JSON,而是一串以 data: 开头的行:
data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{"role":"assistant"},"finish_reason":null}]}

data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{"content":"因为"},"finish_reason":null}]}

data: {"object":"chat.completion.chunk","choices":[{"index":0,"delta":{},"finish_reason":"stop"}]}

data: [DONE]
关键差别只有一个:非流式读 choices[0].message,流式读 choices[0].delta。最后收到一个带 finish_reason 的块,再收到 data: [DONE],流就结束了。
Java 侧接流式,官方 SDK 已经把 SSE 解析包好了:
// 流式:逐块吐字
StreamResponse<ChatCompletionChunk> stream =
        client.chat().completions().createStreaming(params);

stream.stream()
      .flatMap(chunk -> chunk.choices().stream())
      .map(choice -> choice.delta().content())
      .flatMap(Optional::stream)
      .forEach(System.out::print);
如果你还想在流结束之后拿到那个"完整的" ChatCompletion 对象(比如要读最终的 usage),SDK 提供累加器:
ChatCompletionAccumulator acc = ChatCompletionAccumulator.create();
stream.stream().forEach(acc::accumulate);
ChatCompletion full = acc.chatCompletion();
顺手提一句:流式模式下 usage 字段默认可能不返回。要统计 token 消耗,请求里得显式加 stream_options: {"include_usage": true},服务端会在 [DONE] 之前额外补一个只带用量的块。这个细节我第一次踩的时候排查了挺久。
下面这张图把两种模式的往返过程放在一起看:
那到底该选哪个?我的判断标准是"用户能不能等"。
| 场景 | 选哪个 | 理由 |
|---|---|---|
| 后台批处理、定时任务 | 非流式 | 代码简单,异常处理干净 |
| 网页/App 对话 | 流式 | 首字 1 秒内出现,体感完全不同 |
| 长文生成、报告 | 流式 | 顺便规避 HTTP 超时 |
| 要严格 JSON 结构 | 非流式 | 整段好校验,增量拼 JSON 很痛苦 |
说真的,第 2 行的差别大到什么程度:同一个模型、同样的回复,非流式转 8 秒圈圈用户会以为卡了,流式一秒开始吐字用户觉得"挺快"。总耗时可能一样,甚至流式更长一点点,但没人会去掐表。
四、方言登场:Anthropic Messages API
所谓兼容,大多数只兼容到你的 demo 跑通为止。
Anthropic Messages API:Claude 的原生接口协议,端点是 POST /v1/messages。它和 OpenAI 的字段语义高度接近,但位置、必填性、读取路径都不一样,可以理解成"同一门语言的另一套方言"——能听懂,但你不能按普通话的语法说。
一条最简请求长这样:
{

  "model": "claude-sonnet-5",
  "max_tokens": 1024,
  "system": "你是严谨的 Java 助手",
  "messages": [{
   "role": "user", "content": "HashMap 扩容为什么是 2 倍"}],
  "stream": true
}
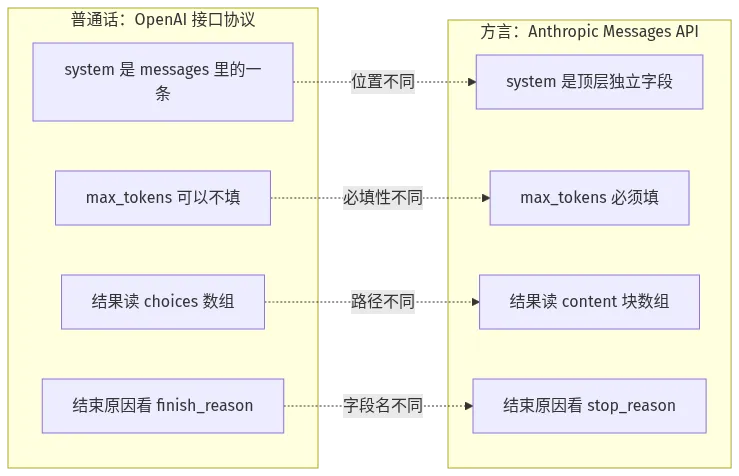
看出来了吗?system 不在 messages 里,它是顶层一个独立字段。这是最容易踩的一个差异。
其余的差异我列成一张表,接 Claude 之前扫一眼:
| 维度 | OpenAI 接口协议 | Anthropic Messages API |
|---|---|---|
| 端点 | /v1/chat/completions |
/v1/messages |
| 认证 | Authorization: Bearer |
x-api-key + anthropic-version |
| system 提示 | messages 里的一条 |
顶层独立 system 字段 |
max_tokens |
可选 | 必填 |
| 读取结果 | choices[0].message.content |
content[] 数组,按 type 挑块 |
| 结束原因 | finish_reason |
stop_reason |
| 用量字段 | usage.prompt_tokens / completion_tokens |
usage.input_tokens / output_tokens |
头部的两个差异得单独拎出来说。第一,认证头不叫 Authorization,叫 x-api-key;第二,它有个必须带的 anthropic-version 头(当前值是 2023-06-01),少一个直接 400。写过 HTTP 客户端的人可能觉得这没什么,但你如果用的是"OpenAI 兼容"的通用客户端,它压根不会帮你加这个头。
流式返回的结构也完全不同。它不是统一的 delta.content,而是一串有名字的事件,顺序大致是:
message_start → 若干组(content_block_start → content_block_delta → content_block_stop)→ message_delta → message_stop。
中间那个 content_block_delta 里还有细分:文本是 text_delta,工具参数是 input_json_delta,思考过程是 thinking_delta。你不能粗暴地按"第 0 个块就是文本"来取值,得先看 type。
下面这张图把两套协议里最容易混淆的四组字段一一对上,接新模型前扫一眼能少查半天文档:
可能有人会问:既然都说"兼容 OpenAI",为什么换个模型还是报错?
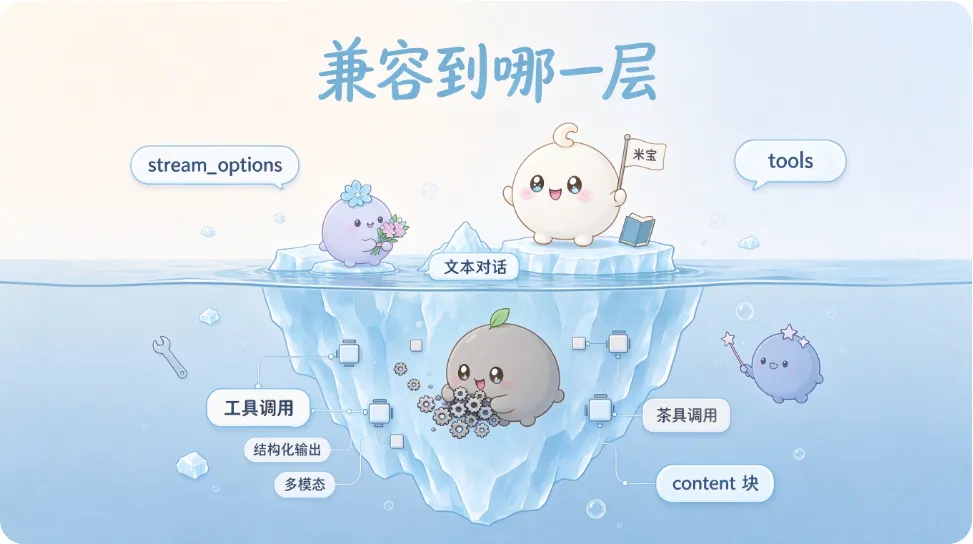
因为兼容的通常只是最基础的文本对话部分。一旦用到工具调用、结构化输出、多模态、
stream_options这些进阶字段,各家实现就开始分叉了。典型的一个:DeepSeek、Qwen 在流式工具调用里每块都会重发完整的工具调用 ID,而 LangChain4j 默认是按块累积 ID 的——这时候得把accumulateToolCallId显式设成false,不设的话你会拿到一串被拼起来的、根本对不上的 ID。
五、Java 落地时的三个真坑
Java 侧对接大模型,九成的报错不是模型的问题,是 base_url 的问题。
第一,/v1 到底加不加。 有些客户端要求你填的 base_url 以 /v1 结尾,有些会自动帮你拼 /chat/completions。如果你填了完整路径又碰上会自动拼的客户端,最后发出去的就是 .../v1/chat/completions/chat/completions,返回 404 还不告诉你为什么。我的习惯是:只填到版本号那一层,https://api.deepseek.com/v1,后面交给客户端。
第二,max_tokens 和 max_completion_tokens。 新版 OpenAI 模型在推 max_completion_tokens,老参数在部分模型上已经不认了;而国内兼容端大多还在用 max_tokens。这两个不是完全等价——切模型的时候如果报"未知参数",先想想是不是这里。
第三,流式接口在 Spring 里要单独配。 如果你用 Spring AI 的 ChatClient,返回类型得是 Flux,而且响应体的 content type 要声明成事件流,不然前端接不到:
@GetMapping(value = "/chat", produces = MediaType.TEXT_EVENT_STREAM_VALUE)
public Flux<String> chat(@RequestParam String q) {

    return chatClient.prompt().user(q).stream().content();
}
少写 produces 那行,浏览器侧就是一直 pending 到超时,日志里干干净净什么都不报。
六、收个尾
学一套协议对付十家模型,这是 OpenAI 接口协议带来的最大红利;但它给你的只是"能通",不是"全通"。
以 2026 年 10 月这个时间点看,我的实际做法是:主链路统一走 OpenAI 风格的接口,用 base_url + model 两个变量切换;只有确实需要 Claude 那些原生能力——比如思考块、服务端工具——才单独走 Messages API,并且老老实实按它的规矩写一套客户端。
别指望"兼容"两个字能替你做所有事。真正的兼容层是你自己写的那层适配代码,不是厂商文档里的一句承诺。
参考链接
- OpenAI Chat Completions API 参考(搜:OpenAI Chat Completions API reference)
- Anthropic Messages API 文档(搜:Claude Messages API docs)
- Anthropic 流式事件说明(搜:Claude streaming messages)
- openai-java 官方仓库(搜:openai-java GitHub)
- LangChain4j OpenAI 兼容模型文档(搜:LangChain4j OpenAI compatible)
我是晚安code,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:你项目里是直接照着 OpenAI 接口协议写,还是被哪家方言坑过?