
大家好,我是晚安code。
线上服务每隔几分钟卡一下,GC 日志刷出一屏看不懂的缩写——这是我最怕看到的画面。有一次我把 -XX:+UseG1GC 抄进启动参数,卡顿反而更频繁了。后来才搞明白,G1 的默认节奏跟我那台 2 核 4G 的容器根本不搭。
这篇把 JVM 垃圾回收从「回收哪块内存」一路讲到「内存泄漏怎么查」,拆成七块。看完你至少能回答两个问题:我现在这个服务该用哪个收集器,以及 GC 日志里那行 Full GC 到底是谁逼出来的。
本文基于 JDK 21 LTS 与 JDK 24 的现状梳理,涉及版本的地方都标了 JEP 编号,你可以自己去 openjdk.org 核对。
一、GC 到底管哪块内存:堆是主战场
JVM 里需要 GC 操心的地方其实只有两处,而 95% 的工夫都花在堆上。
先把名字摆正。
JVM 垃圾回收(Garbage Collection,GC):JVM 自动识别并释放「不再被任何存活对象引用」的内存,让程序员不用手写 free。你可以理解成一个不下班的保洁,按自己的节奏扫,不按你的节奏扫。
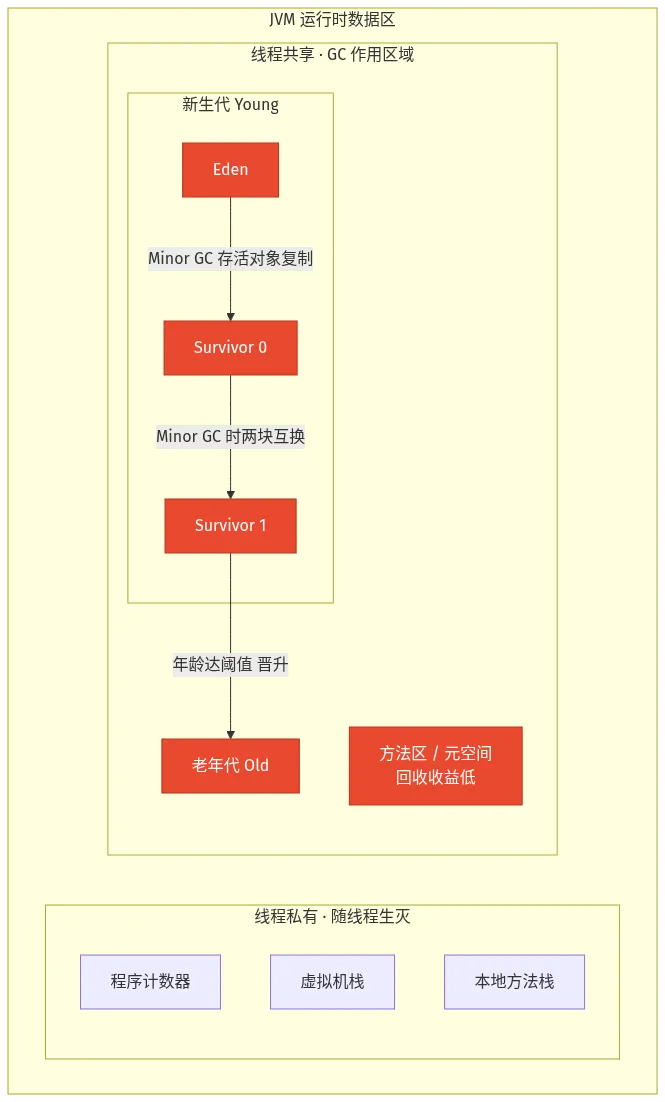
那这位保洁负责几个房间?看 JVM 的运行时数据区划分就清楚了:
| 区域 | 线程 | 生命周期 | GC 管不管 |
|---|---|---|---|
| 程序计数器 | 私有 | 随线程生灭 | 不管 |
| 虚拟机栈 | 私有 | 随线程生灭 | 不管 |
| 本地方法栈 | 私有 | 随线程生灭 | 不管 |
| 堆 | 共享 | 随 JVM 进程 | 主战场 |
| 方法区 / 元空间 | 共享 | 随 JVM 进程 | 管,但收益低 |
前三个是线程私有的,线程一结束内存自然回收,压根不需要 GC 出手。栈帧里那些局部变量引用,本质上是指向堆的指针——栈自己是干净的,脏的是它指过去的地方。
真正的主战场是堆。堆内部又分了代:
- 新生代(Young):Eden + 两块 Survivor(S0、S1),对象的出生地。绝大多数对象在这里活不过一轮,这个区域回收频繁但每次很快。
- 老年代(Old):熬过若干轮 Minor GC 还活着的对象,会被晋升到这里。回收频率低,但每次代价大。
方法区(JDK 8 之后是元空间)也归 GC 管,主要回收废弃的常量和不再使用的类。但条件很苛刻——一个类要被回收,得保证它的所有实例都没了、加载它的类加载器也没了、对应的 Class 对象没被引用、还不能被反射访问到。实践中这个区域通常不怎么需要你操心,内存溢出更多是元空间本身不够用(-XX:MaxMetaspaceSize 设小了),而不是回收不及时。
把这张图存下来。后面讲到的每一个收集器,本质上都是在图里某一块上做文章。
一句话记住:栈帧自己会走,堆里的对象得有人点名。
二、对象怎么被判「死刑」:可达性分析与四种引用
引用计数看起来很直觉,但主流 JVM 一个都没用它——因为循环引用它解决不了。
圈一下知识点。
可达性分析算法(Reachability Analysis):从一组称为 GC Roots 的根对象出发,沿着引用链往下遍历,能走到的对象标记为存活,走不到的就是可回收的。你可以想象几个灯塔同时打开,光束扫过的区域是安全的,光束之外的黑暗就是垃圾场。
为什么不是引用计数?因为两个对象互相引用、但外部谁也够不着它们时,引用计数永远不会归零。写个双向链表或者父子互指的结构就复现了:
class Node {

    Node next;
}
Node a = new Node();
Node b = new Node();
a.next = b;
b.next = a;   // 循环引用
a = null;
b = null;     // 现在 a、b 谁都够不着了
引用计数会说这两个对象还「有人引用」,可达性分析从 GC Roots 出发一搜,根本走不到它们——照收不误。
那 GC Roots 具体是谁?常见的几类:
- 虚拟机栈中局部变量表里引用的对象(也就是你方法里那些活着的局部变量)
- 方法区中静态属性引用的对象(
static字段指向的东西) - 方法区中常量引用的对象
- 本地方法栈里 JNI 引用的对象
- 所有被同步锁(
synchronized)持有的对象
排查看内存为什么降不下来的时候,第一个要问的就是:是谁在 GC Roots 上挂着这条引用链。
不过「可达」和「回收」之间还隔着一层,就是引用类型。Java 把引用分成四档,决定了一个对象有多容易被放过:
| 引用类型 | 回收时机 | 典型用途 |
|---|---|---|
| 强引用 Strong | 只要引用链还在,永不回收 | 日常 new 出来的对象 |
| 软引用 Soft | 内存不够时才回收 | 本地缓存(图片、查询结果) |
| 弱引用 Weak | 下次 GC 必回收 | ThreadLocal、WeakHashMap |
| 虚引用 Phantom | 随时可能被回收,只用于感知回收事件 | 堆外内存的清理(Cleaner) |
实际写代码时,软引用和弱引用是两个极端:软引用赌的是「内存还够,别删我的缓存」;弱引用赌的是「对象在别处还有强引用,你删掉这个副本无所谓」。ThreadLocal 之所以会泄漏,就是因为它内部的 ThreadLocalMap 用 ThreadLocal 对象做弱引用 key,但 value 是强引用——key 被回收了,value 还挂在那个 Entry 上,得靠 remove() 手动清。
关于「对象被判死刑就一定会死」,还有一层兜底:finalize()。对象第一次被判定不可达时只是进 F-Queue 排队,如果它在 finalize() 里把自己重新挂回 GC Roots,就能逃过一劫。但这个方法在 JDK 9 已经标记废弃(JEP 421 在 JDK 18 正式遗弃),别指望它,也别用它做清理逻辑。
三、四种垃圾收集算法:没有一种能通吃
四种算法里没有一个能通吃,分代收集才是真正的答案。
把「怎么回收」拆开看,其实只有四条路。
1)标记-清除(Mark-Sweep)
先走一遍可达性分析标出活着的对象,然后把没标记的直接清掉。最直觉,也最省事。
问题是两个:效率不稳定——对象越多标记越慢;内存碎片——清完之后堆里全是大小不一的空洞,最后可能总空闲 500MB 却要不出连续的 50MB,只能提前触发一次 GC。
2)标记-复制(Mark-Copy)
把内存劈成两块,每次只用一块。回收时把存活对象整块复制到另一块,然后把这半块全清掉。
没有碎片问题,分配也快(撞指针就行),代价是可用内存直接砍半。所以它不适合老年代——老年代存活率高,要复制的东西太多,得不偿失。新生代用这个正好,因为那边 98% 的对象活不过第一轮。
商业 JVM 里真正的做法是改良版:Eden 和两块 Survivor 按 8:1:1 分,每次只用 Eden + 一块 Survivor(共 90%),回收时把存活对象复制到另一块 Survivor 上。这样只浪费 10% 的空间。
3)标记-整理(Mark-Compact)
标记之后不直接清,而是把所有存活对象往一端推,然后清掉边界之外的全部内存。
没有碎片,也不用砍半内存。代价是移动对象要改引用,而且移动过程中用户线程必须停下来(STW),停顿比前两种都长。老年代常用这个。
4)分代收集(Generational Collection)
前面三种都是「怎么扫」,分代收集解决的是「扫哪块」,所以它不算同一维度的对手,而是把前三种组合起来的策略。
背后的假设叫弱分代假说:绝大多数对象朝生夕死。既然新生代里大部分是垃圾,那就用高频率、低成本的复制算法快速清理;老年代对象活得久,就用低频的标记-清除或标记-整理,容忍更长的单次停顿。
主流收集器基本都是这个思路,唯一的例外是 ZGC 早期的不分代版本——它直接用更短的停顿硬扛全堆扫描,不靠分代省事。
四、五种收集器怎么选:选你最不能忍受的牺牲
选收集器不是选最强的,是选你最不能忍受的那个牺牲。
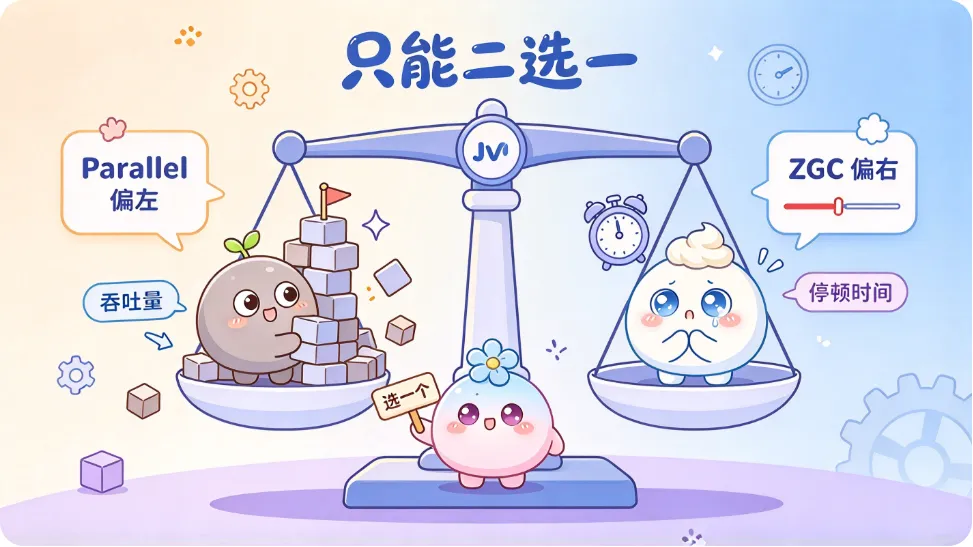
所有收集器的参数对比都在权衡同一件事:吞吐量(Throughput)和停顿时间(Pause Time),两者在物理上就是矛盾的——想少停,就得多花 CPU 做并发工作,总吞吐必然掉。
吞吐量(Throughput):用户代码运行时间 ÷(用户代码时间 + GC 时间)。停顿时间(Pause Time):一次 GC 让用户线程停下来的时长。你可以把它想成收银台——多开几个通道增派人手(并发收集),顾客排队时间短了,但多了人力成本(吞吐下降)。
先看全景:
| 收集器 | 停顿特征 | 吞吐表现 | 适用场景 | 启用方式 |
|---|---|---|---|---|
| Serial | 单线程 STW,停顿明显 | 小堆下尚可 | 单核 / 小内存客户端、容器 | -XX:+UseSerialGC |
| Parallel | 多线程 STW,停顿较长 | 最高 | 批处理、离线计算 | -XX:+UseParallelGC |
| CMS | 大部分并发,停顿短 | 中等(有 CPU 抢占) | JDK 14 已移除,仅存历史系统 | 不支持 |
| G1 | 可设定目标停顿 | 中等偏上 | 大堆(4GB 以上)通用服务 | -XX:+UseG1GC(JDK 9 起默认) |
| ZGC | 亚毫秒级,与堆大小基本无关 | 低于 G1 | 延迟敏感、超大堆(TB 级) | -XX:+UseZGC |
Serial 收集器(串行收集器):最早的一代,单线程做完整套回收,回收时必须停掉所有用户线程。听起来很落后,但在单核 CPU 或者 1~2 核的小容器里它经常打赢 Parallel——因为多线程 GC 会互相争抢 CPU,单核上切来切去的开销反而更大。
Parallel 收集器(并行收集器):Serial 的多线程版,新生代用复制、老年代用标记-整理,全流程 STW 但用上了多核。它是吞吐量的天花板,代价是单次停顿可能到几百毫秒甚至更长。适合那种「跑完就行、中途卡一下无所谓」的批处理任务。
CMS / G1 / ZGC 是三代追求低停顿的收集器,后面两节专门讲。
可能有人会问:ZGC 停顿不到 1ms,是不是所有服务都该换 ZGC?
不是。ZGC 是用吞吐量换停顿时长的。它有染色指针和读屏障的开销,同样硬件下吞吐通常低于 G1。如果你的服务是「延迟敏感但吞吐不敏感」(网关、行情推送),ZGC 值得换;如果是吞吐吃紧的计算任务,换成 ZGC 只会更慢。另外 ZGC 从 JDK 15 才转正(JEP 377),JDK 15 之前的版本别在生产用。
一个常被忽略的点:生产环境必须上 G1 是不成立的。如果容器只给了 1~2 核、堆不到 2GB,SerialGC 或 ParallelGC 往往是更好的选择——G1 需要额外的内存和 CPU 来维护 Region 记账和并发标记线程,在小堆上这些开销换不来收益。JDK 官方文档里也明确写过,小内存场景 SerialGC 是合理选项。
我手上几个 2 核 4G 的边车服务就是把 G1 换回 SerialGC 的,P99 卡顿反而消停了。所以我的建议是:先用 jstat 把实际堆大小和 GC 频率看清楚,再谈换哪个收集器,别一上来就抄网上那套「G1 起步」的参数模板。
五、CMS 的四步工作流,和它绕不过去的三个硬伤
CMS 不是被 G1「打败」的,是被自己的两个毛病熬死的。
CMS 收集器(Concurrent Mark Sweep):以最短回收停顿为目标的收集器,标记和清除的大部分工作与用户线程并发执行。它是第一款真正让 GC 停顿降到几十毫秒级的收集器,你可以理解为「趁顾客不多的时候分批扫地,而不是关门大扫除」。
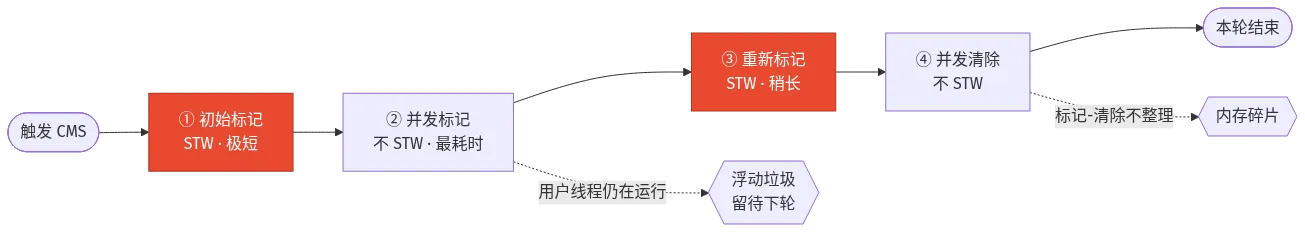
它的完整流程分四步,其中两步必须 STW:
- 初始标记(Initial Mark):只标记 GC Roots 能直接关联到的对象。因为只扫一层,速度极快,但必须 STW。
- 并发标记(Concurrent Mark):从直接关联对象开始做完整遍历,这一步最耗时,但它与用户线程并发执行,不产生停顿。
- 重新标记(Remark):修正并发标记期间因为用户线程继续运行而产生变动的那部分记录。这一步比初始标记长、比并发标记短,同样 STW。CMS 用增量更新(Incremental Update)配合写屏障来记录这些变动,把重新标记的时间压到可控范围。
- 并发清除(Concurrent Sweep):清除掉标记为不可达的对象,同样与用户线程并发。
CMS 的问题就藏在这套设计里,主要有三个:
硬伤一:浮动垃圾。并发清除阶段用户线程还在跑、还在产生新垃圾,这些垃圾这一轮没法处理,只能留到下一次。更要命的是,并发阶段用户线程也需要内存——所以 CMS 不能等老年代满了才启动,默认在老年代使用 68% 时就得开始(-XX:CMSInitiatingOccupancyFraction)。这个值调高了,就会撞上第二个硬伤。
硬伤二:Concurrent Mode Failure。万一在并发清理还没结束时老年代就撑不住、要不到内存了,CMS 只能被迫放弃并发、退化成一次单线程的 Serial Old 全堆回收——这次停顿可能长达数秒。这个场景在线上日志里长这样:
[GC (CMS Initial Mark) ...]
[Full GC (Allocation Failure) ...]   ← CMS 退化成 Serial Old,长停顿
硬伤三:内存碎片。CMS 用的是标记-清除,不整理,运行久了老年代就是一块瑞士奶酪。如果没有连续空间分配大对象,即使总空间够,也只能提前触发 Full GC。可以开 -XX:+UseCMSCompactAtFullCollection 在 Full GC 时整理,但整理本身是 STW 的,等于用停顿换碎片。

CMS 在 JDK 9 被标记废弃(JEP 291),JDK 14 被彻底移除(JEP 363)。如果你的团队还在 JDK 8 上跑 CMS,最该注意的不是调参,而是那行 Concurrent Mode Failure 出现的频率——它出现一次,就是用户能感知到的一次卡顿。
六、G1 凭什么接棒:Region 化、Mixed GC、可预测停顿
G1 相比 CMS 最大的进步不在算法,而在把「不可控的停顿」变成了「可预算的开销」。
G1 收集器(Garbage-First):把堆划分成若干个大小相等的 Region,以「回收收益最高」为优先级进行回收的收集器。你可以把它理解成不再整个城市大扫除,而是把城市划成街区,每次只打扫最脏的那几个。
自 JDK 9 起 G1 就是 HotSpot 的默认收集器(JEP 248),取代了 Parallel 的位置。
1)区域化分代:物理上不分代,逻辑上仍然分代
G1 把堆切成大约 2048 个等大的 Region,每个 Region 大小在 1MB~32MB 之间(必须是 2 的幂),具体值由堆大小自动决定,也可以用 -XX:G1HeapRegionSize 手动指定。
这些 Region 在物理上是连续的格子,但在逻辑上可以随时扮演 Eden、Survivor、老年代或者 Humongous(巨型对象)区。也就是说,「新生代」在 G1 里不是一个固定的地址区间,而是一个动态的角色集合——今年是 Eden,明年可能就变成老年代了。
这个设计带来的直接好处是:G1 不需要像 CMS 那样预留一整块连续的老年代空间,碎片问题从根上缓解了。
2)可预测停顿:把停顿当成预算来花
G1 允许你通过 -XX:MaxGCPauseMillis 指定一个目标停顿时间(默认 200ms)。G1 会在每次回收前,根据历史数据估算出「回收 N 个 Region 大概要停多久」,然后挑出收益最高、且总耗时不超过预算的那批 Region 来回收。
这就叫 Garbage-First——优先回收垃圾占比最高的 Region,性价比最高。
要注意的是,这只是一个目标值,不是保证值。G1 会尽力逼近,但堆特别大、对象存活率特别高的情况下依然会超。把它设成 5ms 这种不现实的值,只会让 G1 频繁触发回收,反而拖垮吞吐。
3)Mixed GC:一次同时回收新生代和部分老年代
G1 的回收模式有两种:
- Young GC:只回收 Eden 和 Survivor Region。触发条件是新 Eden 区装满。
- Mixed GC:回收全部新生代 Region 加上一部分老年代 Region(由并发标记算出的回收收益排序决定)。它不会一次性清空整个老年代,所以单次停顿可控。
Mixed GC 的触发依赖于一次并发标记周期:当老年代占用达到阈值(默认 45%,-XX:InitiatingHeapOccupancyPercent)时,G1 启动并发标记,算出哪些老年代 Region 垃圾最多、最值得回收,然后进入 Mixed GC 阶段。
这就是 G1 和 CMS 最本质的区别:CMS 的并发标记只是为了「知道谁死了」,G1 的并发标记还顺便算出了「先收谁最划算」。
想自己截一张,用这条命令跑一遍压测就有(JDK 9+ 统一日志框架,输出详细 GC 信息到 gc.log):
java -Xlog:gc*:file=gc.log:time,uptime,level,tags \
     -XX:+UseG1GC \
     -XX:MaxGCPauseMillis=200 \
     -Xmx4g \
     -jar your-app.jar
顺手看老年代增长趋势,jstat 一行就够。下面这条每 1 秒采样一次、共 20 次,重点看 O(老年代使用率)和 FGC 两列:
jstat -gcutil <pid> 1000 20
O 这一列如果长期单向上涨、Full GC 之后也降不下来,别急着调 GC 参数——先去看第七节。
七、内存泄漏:GC 管不了的那部分
Java 里的内存泄漏不是忘了 free,是对象被一个不该活着的东西抱着。
内存泄漏(Memory Leak):对象在业务上已经不会再被使用,却仍然被一条可达的引用链持有,导致 GC 判定它「还活着」而无法回收。你可以想象成一个背包——东西早就不用了,但你一直没松手,背包就只能越来越沉。
这是 Java 内存泄漏和 C 语言内存泄漏最大的区别:C 是丢掉了指针找不到内存,Java 是内存在引用链上被扣着不放。GC 完全无能为力,因为从它的视角看,这些对象确实可达。

线上最常见的几类场景:
1)静态集合只增不减。static Map<String, Object> CACHE 这种写法,如果只 put 不清理,业务跑上几个月,这个 Map 就成了老年代的钉子户。它不是不能有,而是必须有淘汰策略——要么换成 Caffeine/Guava Cache 这类带容量上限和过期时间的实现,要么至少加个定时清理。
2)ThreadLocal 用完不 remove()。线程池里的线程是复用的,ThreadLocalMap 挂在 Thread 对象上,线程活多久它就活多久。key 是弱引用会被回收,value 是强引用不会——remove() 那行代码看着多余,其实是必需的。
3)监听器和回调没注销。往 EventBus、ApplicationListener 注册了监听器,对象销毁时忘了反注册,事件总线就一直持有它。这个坑在 Spring 容器里尤其常见,因为 bean 的生命周期由容器管,你自己感觉「它应该没了」,实际上容器还攥着。
4)连接、流、ExecutorService 没关闭。JDBC 连接、InputStream、线程池对象本身都是重量级资源,忘记 close() 或者 shutdown(),泄漏的不只是堆内存,还有文件句柄和线程。
5)缓存没有边界。自定义的 ConcurrentHashMap 缓存,key 会跟着用户 ID、订单号一起涨,跑一周就能把堆撑爆。这一类最容易被忽视,因为开发环境根本复现不出来。
排查的路子其实很固定,三步:
- 确认是不是泄漏——用
jstat -gcutil <pid> 1000盯着看,如果 Full GC 之后老年代占用率依然居高不下并且持续上涨,基本可以确定。 - 拿现场——
jmap -dump:live,format=b,file=heap.hprof <pid>,注意加live只 dump 存活对象,文件小很多;线上大堆 dump 会 STW,挑低峰期做。 - 找支配树——用 Eclipse MAT 或 JProfiler 打开,直接看 Dominator Tree,按 retained size 排序,找到那个「不正常的最大单点」。再看它的 GC Roots 路径,就知道是谁抱着它不放了。
可能有人会问:老年代满了就调大
-Xmx,不行吗?这是把泄漏当成了容量问题。泄漏的曲线是线性上涨的,你把堆从 4G 调到 16G,只是把 OOM 的时间从第 3 天推到第 12 天——治不了。堆调大适合的是「对象确实都该活着、只是峰值高」的场景,而泄漏的场景里,那些对象本来一秒都不该活。
回过头看这七节,JVM 垃圾回收的整套机制其实只在回答一个问题:怎么在「跑得快」和「不卡顿」之间找一个你能接受的平衡点。可达性分析决定了谁该走,引用类型决定了谁可以留,收集算法决定了怎么搬,收集器决定了谁来干——而选谁,取决于你这个服务最怕的是延迟还是吞吐。
参考链接
- JEP 248: Make G1 the Default Garbage Collector(JDK 9 起 G1 成为默认,搜:JEP 248 G1 default)
- JEP 291: Deprecate the Concurrent Mark Sweep (CMS) Garbage Collector(JDK 9 弃用 CMS)
- JEP 363: Remove the Concurrent Mark Sweep (CMS) Garbage Collector(JDK 14 移除 CMS)
- JEP 377: ZGC: A Scalable Low-Latency Garbage Collector (Production)(JDK 15 ZGC 转正,搜:JEP 377 ZGC production)
- JEP 439: Generational ZGC(JDK 21 分代 ZGC)
- JEP 490: ZGC: Remove the Non-Generational Mode(JDK 24 移除 ZGC 不分代模式)
- Oracle: HotSpot Virtual Machine Garbage Collection Tuning Guide(各收集器参数与调优,搜:Java GC Tuning Guide)
我是晚安code,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:你现在生产环境用的是哪个收集器,有没有被 Concurrent Mode Failure 或内存泄漏坑过?

