一、前言
随着我们接触的深入,大模型早已不局限于单轮问答、文本生成这类基础场景。大家应该也慢慢发现,单个大模型能力存在天然短板:上下文长度有限、无法自主拆解复杂任务、难以持续完成多步骤目标,也很难和其他智能体分工配合。
于是基于大模型的智能体技术也快速迭代,时不时也会出现各种新型概念。一个Agent可以自主规划、调用工具、持续迭代完成目标。但新的难题随之而来,当我们想要搭建多个智能体协同工作的系统时,开发成本会急剧上升。如果从零开发多智能体项目,我们需要自行实现智能体生命周期管理、消息通信机制、对话持久化、多模型兼容、任务调度、异常处理、可视化调试等一系列底层能力。不同团队实现方案五花八门,代码无法复用,调试困难,极大的增加了应用实践门槛。
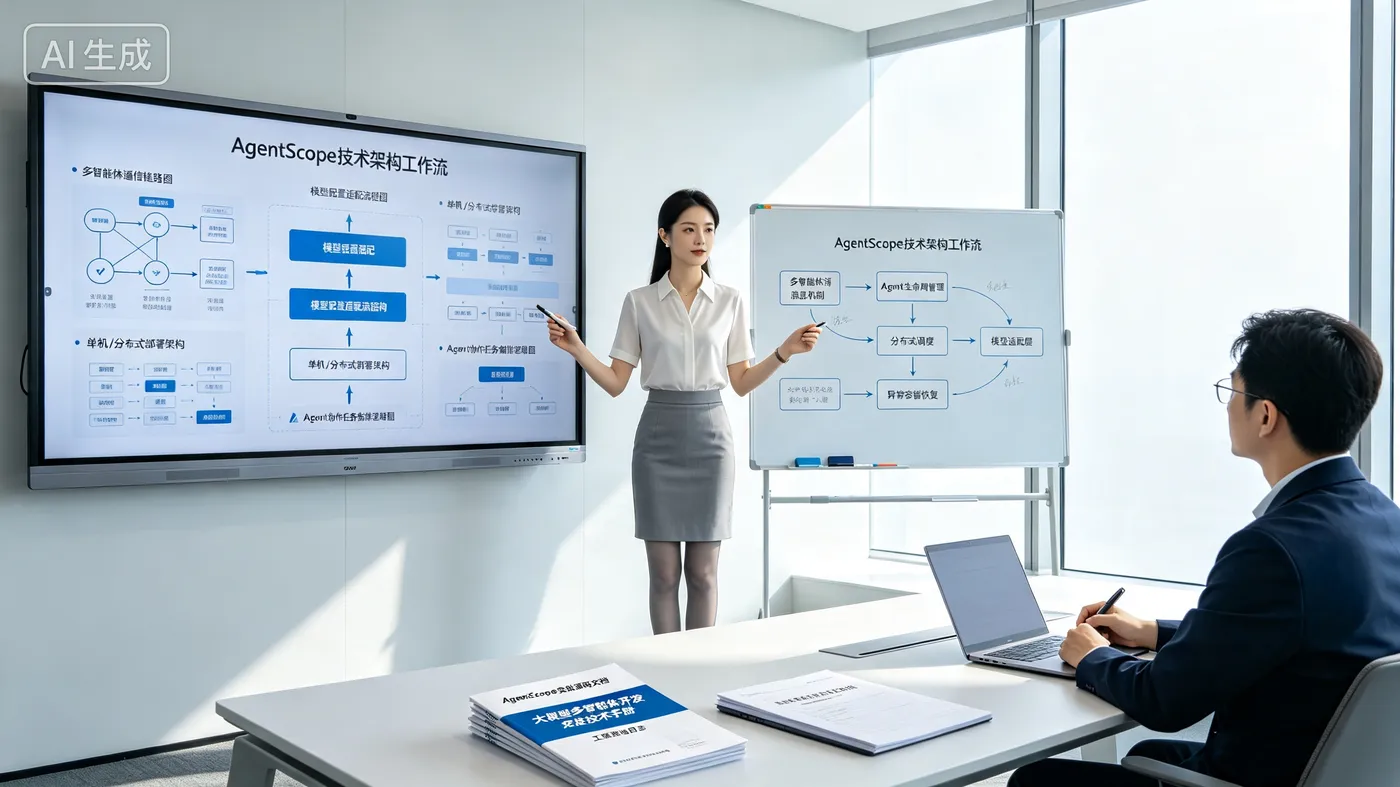
在慢慢的探索中,发现了一个AgentScope的框架,它是一款专为大模型多智能体场景打造的开发框架,核心目标就是把多Agent系统底层基础设施封装标准化,让开发者把精力聚焦在智能体逻辑与业务需求上,不用重复造轮子。往期我们也探索了各种框架,初始AgentScope,容易把它和LangChain、AutoGen、CrewAI等框架混淆。它们虽然都支持构建大模型智能体,但定位、架构设计、适用场景存在明显区别,今天我们一探究竟。
二、AgentScope基础知识
1. 多智能体基础概念
要理解AgentScope,首先理清两个核心概念:LLM智能体、多智能体系统。
LLM 智能体(Agent):
- 以大语言模型作为大脑,具备感知信息、思考规划、调用工具、输出动作、接收反馈、持续迭代执行任务的独立程序单元。
- 简单来说,Agent 不再被动等待用户提问,能够主动思考 “下一步需要做什么”。
- 典型组成包含记忆模块、规划模块、工具调用模块、大模型推理模块。
多智能体系统(Multi-Agent System):由两个及以上独立Agent组成,智能体之间通过消息交互、分工协作,共同完成单一 Agent 无法胜任的复杂任务。 举几个现实场景:
- 软件开发场景:产品Agent、架构Agent、编码Agent、测试Agent分工协作完成项目开发;
- 科研场景:文献检索Agent、数据分析Agent、论文撰写Agent协同完成课题研究;
- 客服场景:意图识别Agent、知识库查询Agent、工单处理Agent相互配合处理用户诉求。
原生大模型没有内置多智能体通信能力。想要实现多个Agent对话,我们必须手动设计消息格式、消息路由、对话隔离机制。这就是各类多智能体开发框架想要解决的核心工程痛点。
2. AgentScope框架定位
AgentScope是一套轻量级多智能体开发框架,主打简单易用、高可扩展性、原生支持分布式部署,专门面向基于大模型构建多 Agent 应用。它的核心定位可以总结三点:
聚焦多智能体交互,而非单Agent工具链:
- 像LangChain更加侧重单个智能体的提示词编排、工具封装、RAG流水线;
- AgentScope 重心放在多个Agent之间通信、调度、生命周期管理。
- 我们可以搭配LangChain使用,也可以独立搭建智能体。
降低分布式多Agent开发难度:
- 很多框架仅支持单机内智能体运行,当智能体数量增多、业务压力上涨时难以横向扩展。AgentScope原生支持单机模式与分布式模式无缝切换,代码改动极小。
统一标准化抽象,兼容各类大模型
- 框架不绑定任何一款大模型,支持各种开源、闭源模型,我们只需要统一接口调用,切换模型无需大规模重构代码。
3. AgentScope设计思想
AgentScope整体遵循三大设计理念:
- 1. 一切交互皆消息:
- 所有智能体、用户、工具之间的数据交互统一抽象为消息(Message)。
- 框架提供统一消息结构,统一序列化、传输、存储方案,开发者不需要自定义通信协议。
- 2. 智能体独立自治
- 每个Agent拥有独立内存、独立执行上下文,相互之间不共享状态。
- 通信唯一途径就是发送消息,做到低耦合,便于调试、替换、扩容。
- 3. 环境解耦设计
- 框架将智能体与运行环境(Environment)分离。
- Environment负责管理全局信息、消息广播、全局规则。
- 例如聊天室场景、博弈场景、模拟沙盘场景,都可以通过自定义环境快速实现。
4. 双Agent对话演示示例
先看一段最小可运行示例,直观感受 AgentScope的开发方式,注意要先进行依赖安装:pip install agentscope
# 前置依赖安装:pip install agentscope
import agentscope
from agentscope.agents import DialogAgent
from agentscope.message import Msg
# 初始化框架,配置大模型
agentscope.init(
    model_configs={
        "config_name": "qwen",
        "model_type": "dashscope_chat",
        "model_name": "qwen-turbo",
        "api_key": "你的api-key"
    }
)
# 创建两个对话智能体
agent_a = DialogAgent(
    name="分析师",
    sys_prompt="你是一名数据分析分析师,简洁回答问题。",
    model_config_name="qwen"
)
agent_b = DialogAgent(
    name="产品经理",
    sys_prompt="你是产品经理,善于提出业务疑问。",
    model_config_name="qwen"
)
# 启动对话循环
msg = Msg(name="用户", content="聊聊AI智能体落地难点")
for _ in range(3):
    msg = agent_a(msg)
    print(f"\n{msg.name}: {msg.content}")
    msg = agent_b(msg)
    print(f"\n{msg.name}: {msg.content}")

这段代码完成两个智能体连续对话。我们没有手动处理消息传递、上下文管理,所有底层逻辑由 AgentScope接管。通过这个例子能直观体会:框架屏蔽大量底层工程代码,我们只需要定义智能体角色与交互流程。
三、AgentScope整体架构
1. 架构分层总览
AgentScope 采用分层模块化架构,自上而下分为五层,层级职责清晰,依赖单向向下:

- 1. 应用层:开发者业务代码,自定义智能体、交互流程、业务规则;
- 2. 核心抽象层:框架核心组件,Agent、Message、Environment、Pipeline;
- 3. 运行调度层:消息总线、智能体调度器、生命周期管理器;
- 4. 模型接入层:统一大模型调用接口,封装各类LLM适配器;
- 5. 基础设施层:日志、持久化、存储、分布式通信、监控工具。
分层设计最大优势是模块化解耦,我们可以只替换其中任意一层实现,不需要改动整套代码。例如想要更换消息存储方案,仅需要实现新的持久化适配器,上层业务代码完全不用修改。
2. 核心组件详解
2.1 Message消息模型
消息是整个框架的数据基石。所有信息流转都依托Message对象。标准消息内置字段:
- name:消息发送方名称;
- content:消息正文;
- role:角色(user/assistant/system);
- metadata:自定义扩展字典,存放标签、时间、任务 ID 等附加信息。
消息支持序列化保存,天然支持对话回放、调试、日志溯源。同时框架支持消息广播、定向单发两种传输模式,适配不同交互场景。
2.2 Agent智能体基类
所有智能体都继承自基础 Agent 类,基类约定统一调用入口 __call__(msg)。自定义智能体只需要重写响应逻辑。 框架内置开箱即用 Agent 模板:
- DialogAgent:通用对话智能体;
- ReActAgent:支持思考 + 行动的 ReAct 推理智能体;
- UserAgent:模拟人类用户输入;
- PipelineAgent:串联多个智能体形成执行流水线。
同时我们可以基于基类扩展工具调用、长记忆、反思、自主规划能力。
2.3 Environment交互环境
Environment 用来承载多智能体所处场景,负责消息路由、全局状态维护。常见两种环境模式:
- 1. 顺序执行环境:按照预设顺序依次调用智能体;
- 2. 异步广播环境:消息广播给所有智能体,智能体自主决定是否响应,适合开放博弈、群聊场景。
这里容易混淆:Agent负责自身思考逻辑;Environment负责管理智能体之间的交互规则。如果想要实现 “多人聊天室”“模拟辩论赛”,自定义Environment是标准方案。
2.4 ModelWrapper模型包装器
这一层抹平不同大模型API接口差异。不管调用在线API还是本地开源 LLM,对外暴露统一函数。 我们只需在配置文件统一声明模型参数,全局智能体直接引用配置名称,集中管理密钥、模型参数、请求限流、重试策略。模型切换只需要修改配置,无需修改智能体业务代码。
3. 单机与分布式架构差异
AgentScope支持两种部署模式,代码几乎兼容:
- 单机模式 所有Agent运行在同一个进程/线程,消息通过内存传递,开发调试便捷,适合原型验证、小规模实验。缺点:单进程资源受限,无法横向扩容。
- 分布式模式 智能体可以分布在不同机器、不同进程。框架内置RPC通信模块,远程Agent调用体验和本地调用保持一致。我们不需要编写网络通信代码。适合大规模多智能体集群、生产环境部署。
两种模式实现平滑切换,只需要初始化时调整少量配置,极大降低项目从原型迁移到生产环境的成本,这也是AgentScope相比很多同类框架突出优势。
四、关键能力与特性
1. 标准化智能体生命周期管理
一个智能体完整生命周期包含初始化、接收消息、推理执行、产生响应、暂停、销毁。 如果从零开发多智能体系统,很容易出现资源泄漏、重复初始化、并发冲突等问题。AgentScope统一管控生命周期:
- 初始化阶段自动加载模型配置、记忆存储;
- 执行阶段管控并发,支持同步/异步调用;
- 支持智能体动态创建、动态销毁;
- 程序退出时自动释放模型连接、关闭持久化存储。
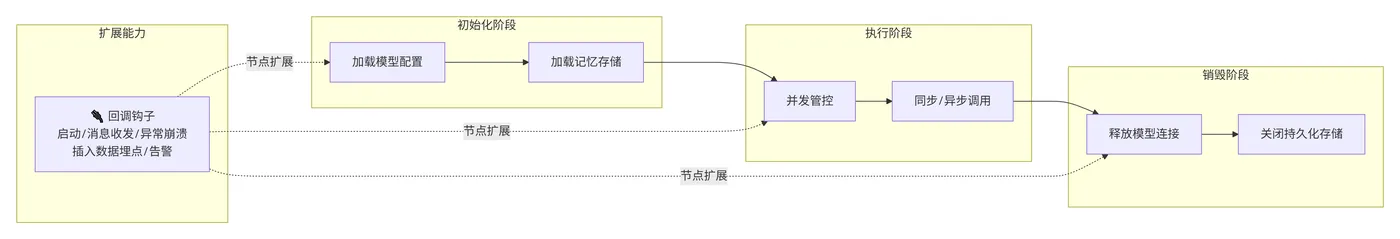
同时框架提供完善回调钩子,我们可以在智能体启动、消息收发、异常崩溃等节点插入自定义逻辑,例如数据埋点、异常告警。
2. 灵活的记忆管理机制
记忆是Agent持续完成任务的核心能力。AgentScope没有强制绑定单一记忆方案,提供多层级记忆抽象:
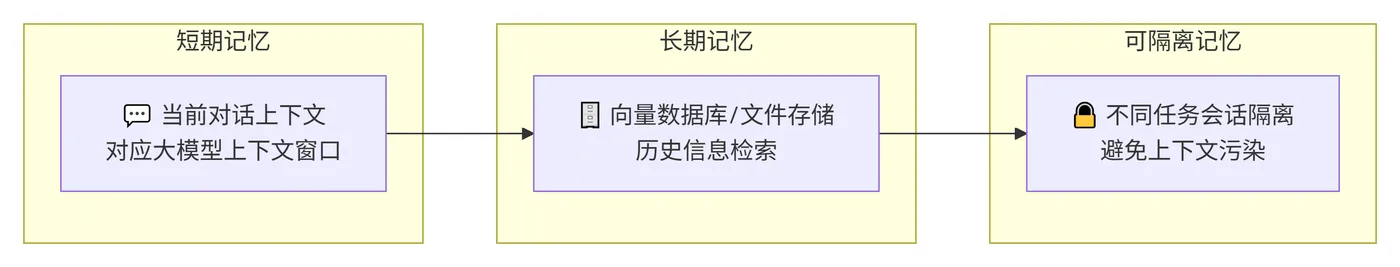
- 短期记忆:保存当前对话上下文,随消息流转,对应大模型上下文窗口;
- 长期记忆:支持开发者接入向量数据库、文件存储,实现历史信息检索;
- 可隔离记忆:不同任务会话相互隔离,避免上下文污染。
内置智能体默认携带基础对话记忆。如果需要实现RAG、历史反思,只需要扩展记忆模块,将检索结果拼接进提示词。这里区分一个关键点:框架只提供记忆抽象接口,向量库检索逻辑需要我们结合 LangChain、LlamaIndex 自行接入,灵活性更高。
3. 工具调用扩展能力
现代智能体离不开工具调用(函数调用),让大模型能够操作外部系统:查询数据库、联网搜索、执行代码、调用业务接口。
AgentScope 支持两种工具集成方式:
- 轻量化方式:在智能体提示词中描述工具信息,由模型输出工具指令,开发者解析执行;
- 标准化函数调用:兼容各大模型原生 Function Call 能力,自动封装函数描述、参数校验。
可以基于ReActAgent快速搭建具备工具使用能力的智能体。下面提供简易工具调用伪代码示例:
from agentscope.agents import ReActAgent
# 定义工具函数
def search_internet(keyword: str) -> str:
    """联网搜索信息"""
    return f"【搜索结果】关于{keyword}的相关资讯"
# 创建具备工具能力的智能体
tool_agent = ReActAgent(
    name="检索助手",
    sys_prompt="你可以调用搜索工具获取外部信息",
    model_config_name="qwen",
    tools=[search_internet]
)

4. 任务编排:Pipeline与交互环境
面对复杂任务,常常需要多条智能体协作流程。AgentScope提供两套编排方案应对不同场景:
- Pipeline(流水线):线性串联智能体,A智能体输出直接作为B智能体输入,适合固定流程任务,例如:信息收集→摘要整理→报告生成;
- Environment(环境):面向非固定流程,智能体自由交互,适合辩论、沙盘模拟、多人协作开放场景。
可以混合使用两种模式:
- 固定流程使用Pipeline简化开发;
- 动态交互场景自定义Environment实现消息广播与规则管控。
5. 调试、日志与可视化支持
多智能体系统调试难度远高于普通程序。多个Agent并行交互,消息链路复杂,一旦出错很难定位问题。 AgentScope原生配套工程化调试能力:
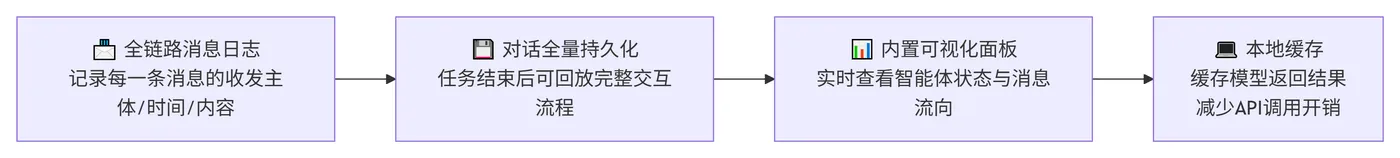
- 全链路消息日志,记录每一条消息收发主体、时间、内容;
- 支持对话全量持久化,任务结束后回放完整交互流程;
- 提供内置可视化面板,实时查看智能体状态、消息流向;
- 支持本地缓存模型返回结果,调试阶段减少API调用开销,节约成本。
6. 异常处理与容错机制
调用大模型 API 经常遇到限流、超时、网络错误、输出格式异常。框架内置统一容错策略:
- 模型请求支持自定义重试次数、重试间隔;
- 捕获推理异常并封装标准错误信息传递给智能体;
- 支持异常回调,出现故障时触发兜底应答逻辑,防止整个多智能体流程中断。
五、主流Agent框架对比
我们也探讨过多个Agent框架,都会面对选型纠结的问题:AgentScope、AutoGen、CrewAI、LangChain如何选择:
1. 框架定位对比
1.1 LangChain:单智能体流水线、RAG、工具链构建。
- 短板:原生多智能体交互能力薄弱,缺少标准化消息总线与分布式支持,多Agent需要自行实现通信。
- 适用:搭建检索增强、单智能体工具应用。
1.2 AutoGen:多智能体对话,擅长代码相关智能体协作。
- 短板:分布式能力较弱,架构耦合较重,自定义交互环境门槛偏高。
- 适用:代码生成、多智能体对话原型验证。
1.3 CrewAI:面向任务规划的多智能体团队,擅长静态任务分工。
- 短板:交互模式偏固定,灵活自定义消息路由能力不足。
- 适用:结构化任务拆解,固定角色智能体团队。
1.4 AgentScope:通用多智能体底层基础设施,消息抽象、分布式扩展、环境解耦。
- 优势:单机/分布式无缝切换,模块化程度高,扩展性强。
- 短板:上层开箱即用高级智能体数量少于AutoGen。
- 适用:需要灵活自定义交互规则、未来可能扩容为分布式集群的中大型多智能体项目。
2. 选型参考建议
- 如果只是做 RAG、单智能体工具机器人:优先LangChain;
- 快速原型验证、代码类多智能体:优先AutoGen;
- 固定角色分工、简单业务流程:优先CrewAI;
- 需要自定义复杂交互规则、长期考虑分布式部署、搭建通用多智能体平台:优先 AgentScope。
框架之间不存在绝对壁垒,可以组合使用。例如使用AgentScope管理多智能体通信,每个智能体内部借助LangChain实现RAG与工具调用。
六、应用场景实践思路
1. 典型适用场景
- 智能体模拟沙盘:例如模拟商业谈判、舆情推演、多方博弈。多个具备不同立场 Agent 在环境中自由交互,观测推演结果。依靠自定义 Environment 实现规则约束。
- 分工式复杂任务处理:科研写作、方案撰写、软件开发,不同职能智能体各司其职,依次传递信息协作完成目标,适合使用 Pipeline 串联。
- 交互式多人对话仿真:模拟客服大厅、线上群聊场景,多个智能体 + 虚拟用户持续交互,用于业务流程压力测试、对话策略验证。
- 自动化评测系统:搭建评测智能体、被测试智能体,自动生成测试问题,完成自动化打分,实现大模型应用自动化测评。
2. 不适合使用的场景
- 仅单一智能体,不存在智能体交互:框架多智能体能力无法发挥,引入额外复杂度;
- 极致轻量化线上问答服务:框架内置较多通用抽象,追求极致低延迟的极简服务可以选择轻量自研方案;
- 强实时端侧小型应用:当前版本更加偏向服务端部署,端侧资源受限场景适配不足。
3. 多智能体报告生成流程
结合实际应用场景,我们通过六个专用智能体协作完成文档撰写的应用流程,需满足需求Agent梳理目标,检索Agent收集资料,整理Agent提炼要点,撰写Agent生成初稿,评审Agent检查漏洞,输出Agent整合修改意见后交付终稿。各环节职责清晰、顺序流转,形成从需求到交付的完整闭环。

- 1. 需求 Agent:接收用户需求,梳理任务目标;
- 2. 信息检索 Agent:根据目标调用搜索工具收集资料;
- 3. 整理 Agent:清洗信息,提炼有效要点;
- 4. 撰写 Agent:基于要点生成初稿;
- 5. 评审 Agent:检查内容漏洞,提出修改意见;
- 6. 输出 Agent:整合修改意见,生成最终文档。
同时这套流程可以通过Pipeline串联。如果想要让评审Agent和撰写Agent来回辩论修改,则切换为Environment实现双向消息交互。整套流程依托AgentScope管理消息传递、上下文隔离,我们只需要定义每个智能体角色提示词与逻辑。
七、总结
总的来说,AgentScope本质上不是用来 “一键造出超级智能体” 的魔法工具,而是一套标准化多智能体系统工程底座。在大模型应用开发走向纵深的当下,单一模型问答应用慢慢无法满足复杂业务需求,多智能体协同必然是重要发展方向。但如果每个团队从零搭建通信、调度、状态管理底层模块,会造成大量重复开发。AgentScope核心价值,就是把多Agent系统中通用、繁琐的底层工程问题标准化解决,把通信、消息序列化、智能体生命周期、分布式能力封装好。
- AgentScope以 “消息” 作为所有智能体交互统一载体,依靠Agent、Environment两大核心抽象构建多智能体体系;
- 最大差异化亮点:单机、分布式代码平滑迁移,模块化架构,高度灵活可扩展;
- 选型核心判断标准:我们的项目是否存在多个智能体交互,未来是否存在分布式扩容需求;
- 框架重在提供基础设施,业务层面的智能体能力(规划、记忆、RAG、工具)依旧需要开发者结合业务场景自主实现。
技术框架永远只是手段。真正决定多智能体应用效果的,依旧是任务拆解思路、智能体角色设计、提示词工程、流程规则设计。框架解决工程效率问题,业务逻辑需要我们持续打磨。
附录:多智能体协作撰写行业分析报告
示例实现多智能体协作撰写行业分析报告,使用内置DialogAgent,消息流转由AgentScope管理,其中需求解析Agent接收用户需求,梳理报告大纲;信息调研Agent基于大纲梳理关键调研方向,撰稿Agent根据大纲+调研信息生成报告初稿;评审Agent审阅初稿,提出优化修改意见;
"""
AgentScope 完整实战示例:多智能体协作生成行业分析报告
框架版本:AgentScope >=0.0.8
"""
import agentscope
from agentscope.agents import DialogAgent
from agentscope.message import Msg
# ===================== 1. 初始化框架与模型配置 =====================
# 请替换为自己的模型Key,示例使用通义千问;也支持OpenAI、本地LLM等
model_config = {
    "config_name": "qwen_turbo",
    "model_type": "dashscope_chat",
    "model_name": "qwen-turbo",
    "api_key": "sk-xxxxxxxxxxxxxxxxxxxxxxxx",  # 替换你的API Key
}
# 加载配置,初始化agentscope运行环境
agentscope.init(model_configs=model_config)
# ===================== 2. 创建各个职能智能体 =====================
# 智能体1:需求解析助手
demand_agent = DialogAgent(
    name="需求分析师",
    sys_prompt="""
你是专业需求分析师。接收用户撰写报告需求,输出结构化行业分析报告大纲。
输出规范:
1. 清晰划分章节标题;
2. 逻辑层层递进;
3. 不需要生成正文,只输出大纲。
""",
    model_config_name="qwen_turbo"
)
# 智能体2:信息调研助手
research_agent = DialogAgent(
    name="调研专员",
    sys_prompt="""
你负责根据报告大纲,梳理需要收集的关键信息点与调研维度。
模拟行业信息调研,列出支撑报告写作的关键素材方向。
条理清晰,分点罗列。
""",
    model_config_name="qwen_turbo"
)
# 智能体3:报告撰稿人
writer_agent = DialogAgent(
    name="撰稿专员",
    sys_prompt="""
你是资深行业分析师。根据报告大纲 + 调研素材,撰写完整行业分析报告初稿。
行文正式、客观,段落通顺,具备商业分析逻辑。
""",
    model_config_name="qwen_turbo"
)
# 智能体4:评审专家
review_agent = DialogAgent(
    name="评审专家",
    sys_prompt="""
你是行业评审专家,审阅分析报告初稿。
从逻辑完整性、数据视角、风险分析、落地价值四个维度提出修改建议。
逐条列出问题与优化方向。
""",
    model_config_name="qwen_turbo"
)
# ===================== 3. 搭建多智能体执行流水线 =====================
def run_report_workflow(user_query: str):
    print("===== 用户需求输入 =====\n", user_query, "\n")
    # 初始化起始消息
    current_msg = Msg(name="用户", content=user_query)
    # 步骤1:需求分析师生成大纲
    current_msg = demand_agent(current_msg)
    print(f"\n【{current_msg.name}输出】\n{current_msg.content}\n")
    # 步骤2:调研专员基于大纲梳理调研要点
    current_msg = research_agent(current_msg)
    print(f"\n【{current_msg.name}输出】\n{current_msg.content}\n")
    # 步骤3:撰稿专员生成报告初稿
    current_msg = writer_agent(current_msg)
    print(f"\n【{current_msg.name}输出】\n{current_msg.content}\n")
    # 步骤4:专家评审给出修改意见
    current_msg = review_agent(current_msg)
    print(f"\n【{current_msg.name}输出】\n{current_msg.content}\n")
    return current_msg
# ===================== 4. 启动运行 =====================
if __name__ == "__main__":
    user_requirement = "生成一份2026年AI智能体行业发展趋势分析报告"
    run_report_workflow(user_requirement)