
上一篇解决的是“企业应该建设什么”。
本篇解决一个更困难的问题:建设完成之后,如何证明 GEO 真的有效?
在实际 GEO 项目中,一个非常常见的场景是:
团队打开 ChatGPT、Perplexity、豆包、DeepSeek 或其他 AI 产品,输入一个问题:
“XX 行业有哪些值得推荐的品牌?”
发现客户品牌出现了。
截图。
然后得出结论:
GEO 优化成功。
从营销展示角度,这张截图可能有价值。
但从工程和实验角度,它几乎不能证明任何事情。
原因很简单。
生成式 AI 的输出不是一个固定排名结果。
一次回答可能受到:
模型版本
检索结果
Query 表达方式
会话上下文
时间
地域
模型随机性
搜索索引变化
外部信源变化
等多个变量影响。
因此,如果企业准备把 GEO 变成一项长期基础设施,就必须从:
“截图证明”
升级成:
“实验测量”
也就是说:
GEO 必须可测量、可重复、可比较、可追溯。
一、为什么 GEO 不能只看“品牌提及率”
目前很多 GEO 工具最常见的指标叫:
Mention Rate
品牌提及率
如果准备了  个问题,其中品牌出现在
 个回答中,那么:

其中:
 :Mention Rate
- :出现目标品牌的回答数
- :总测试回答数
例如:
测试 100 个 Query
品牌出现 62 次
那么:
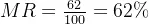
这个指标没有问题。
但它只能回答:
AI 有没有提到品牌?
它无法回答:
AI 说得对不对?
例如:
AI 提到了品牌。
但同时说:
公司成立于 2016 年。
真实情况是:
2018 年。
或者:
产品已经获得 FDA 批准。
实际上只是完成了一项普通第三方检测。
从“Mention Rate”来看,这是一次成功曝光。
从企业事实治理角度看,这是一次严重失败。
因此:
Visibility ≠ Accuracy
可见,不等于正确。
二、从 GEO 论文到企业指标体系:Visibility 只是第一层
Aggarwal 等人在 KDD 2024 的论文 GEO: Generative Engine Optimization 中提出了一个重要方向:
研究内容在生成式引擎答案中的 Visibility。
论文构建 GEO-bench,对不同优化方法影响内容可见度进行了实验,并报告某些方法在其实验条件下可以实现最高约 40% 的可见度提升。需要强调,这里的“最高约 40%”属于特定基准、特定方法和实验环境下的结果,不应被理解成企业 GEO 的普遍提升幅度。
这篇论文非常重要。
但企业场景比论文实验复杂。
企业真正关心的至少包括:
有没有出现?
说得准不准确?
有没有引用?
引用对不对?
重要信息有没有被召回?
不同测试是否稳定?
不同模型表现是否一致?
信息是不是已经过期?
所以,企业 GEO 的评估模型需要从单一 Visibility 扩展为一个多维系统。
三、建议把企业 GEO 拆成六个核心指标
一个相对实用的企业 GEO 指标体系,可以从六个维度开始:
Visibility
Accuracy
Citation
Coverage
Stability
Freshness
即:
可见性
准确性
引用质量
知识覆盖
稳定性
时效性
本文在综合现有 GEO 研究、生成式搜索可验证性研究及企业知识治理需求的基础上,构建了一套适用于企业 GEO 实践的工程化评估框架。
四、指标一:Visibility——品牌是否进入了 AI 答案
最基础的指标仍然是品牌提及率:
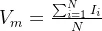
其中:
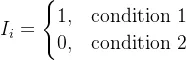
 \=
 :第
 个回答出现目标实体
- \=
 :第个回答未出现目标实体
假设:
N = 200
出现品牌 = 126
则:

但这里有一个关键问题:
“出现”本身也应该分层。
例如:
Level 0:完全未出现

Level 1:仅列表中出现

Level 2:出现品牌并包含基本说明

Level 3:包含核心卖点

Level 4:成为主要推荐对象之一
因此,也可以进一步设计一个加权 Visibility Score:
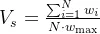
其中 是每个回答的曝光权重。
注意:
权重必须由企业自己提前定义,而不是测试以后再调整。
否则容易发生“为了让结果好看而改评分规则”的问题。
五、指标二:Accuracy——AI 说的到底对不对
如果第一篇已经建立了 Claim Matrix,那么 Accuracy 就可以真正开始计算。
假设企业已经定义:
CL001 公司成立年份
CL002 产品重量
CL003 产品续航
CL004 商标权利人
CL005 产品认证
...
对于某次 AI 回答,可以抽取它涉及的企业事实主张:
AI Answer
↓
Claim Extraction
↓
与 Claim Matrix 对比
定义:
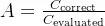
其中:
 :AI 正确表达的 Claim 数量
 :能够核验的 Claim 总数
例如一个回答包含 8 个可核验事实:
7 个正确
1 个错误
则:
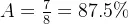
这里要特别注意:
没有证据能够判断的 Claim,不应该强行判成正确。
应该单独标记:
Verified
Incorrect
Unsupported
Ambiguous
Outdated
这样更符合真实的信息治理逻辑。
六、为什么 Accuracy 比 Mention 更重要
生成式搜索研究已经给出了一个非常重要的警告。
Liu、Zhang 和 Liang 在 EMNLP 2023 的论文 Evaluating Verifiability in Generative Search Engines 中,对 Bing Chat、NeevaAI、Perplexity.ai 和 YouChat 进行了人工评估。
研究报告:
平均只有 51.5% 的生成句子得到引用的完整支持,74.5% 的引用能够真正支持与其关联的句子。
这组数字来自该论文当时测试的四个生成式搜索系统以及其测试数据,并不是“所有今天的 AI 系统仍然只有 51.5% 准确率”。
论文真正告诉我们的,是另一个更重要的事实:
引用存在,不等于答案已经被证实。
所以企业 GEO 监测不能只记录:
AI 引用了公司官网。
还必须继续检查:
这个官网页面真的支持 AI 的这句话吗?
七、指标三:Citation——引用率远远不够
最简单的 Citation Rate 是:
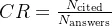
例如:
100 个 AI 回答
其中 48 个引用了目标企业信源
则:

但这仍然太粗。
更合理的 GEO 引用评价至少应该拆成:
Citation Presence
Citation Correctness
Citation Authority
Citation Diversity
即:
有没有引用
引用对不对
引用质量如何
来源是否过度集中
八、Citation Precision:引用是否真的支持结论
可以借鉴生成式搜索可验证性研究中的 citation precision 思路。
定义:
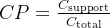
其中:
 :真正支持对应 Claim 的引用数量
 :全部被检查引用数
例如:
AI 给了 20 个引用

其中:
16 个确实支持相关陈述
4 个并不能支持
则:
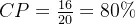
从 GEO 项目角度,这个指标非常重要。
因为一种常见情况是:
AI 的答案中出现了企业官网链接。
但链接页面只是品牌首页。
而 AI 的回答却声称:
“该产品通过了 XX 临床验证。”
如果首页根本不存在这个信息,那么这并不是有效证据。
九、Citation Coverage:重要事实是否都有证据支持
另一个指标是:
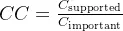
其中:
 :回答中需要证据支持的重要事实数量
 :真正得到有效引用支持的事实数量
例如:
AI 回答中有:
10 个重要事实陈述
其中 6 个有有效引用
那么:

于是可以形成:
Citation Quality
=
Citation Precision
+
Citation Coverage
但不要简单相加。
如果需要做一个综合 Citation Score,更推荐使用调和平均:
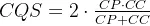
这实际上类似于 Precision 与 Recall 的 F1 思路。
这里再次说明:
CQS 是本文提出的企业管理指标,不是现有 GEO 标准定义的公式。
之所以选择调和平均,是因为它会惩罚“一个指标很好、另一个很差”的情况。
例如:
CP = 100%
CC = 20%
如果使用算术平均:

看起来似乎还不错。
但实际上只有 20% 的重要事实得到引用支持。
使用调和平均:
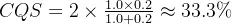
更加符合风险直觉。
十、指标四:Claim Coverage——企业真正想表达的信息,AI 召回了多少?
很多企业会遇到这种问题:
AI 对品牌描述没有明显错误。
但非常“平”。
例如企业真正的核心优势是:
A
B
C
D
AI 每次只说:
A
这不是事实错误。
但它意味着企业知识体系的核心信息没有被有效召回。
因此需要建立:
Claim Recall
定义:
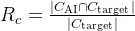
其中:
 :某个 Query 对应的目标 Claim 集合
 :AI 实际召回的 Claim 集合
例如:
目标 Claim:
CL01、CL02、CL03、CL04、CL05

AI 实际出现:
CL01、CL02、CL04
那么:
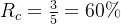
这比所谓:
“核心卖点出现率”
更容易工程化。
因为它直接连接第一篇文章建立的:
Query Matrix
↓
Claim Matrix
十一、Query Coverage:企业到底覆盖了多少真实用户问题
企业做 GEO,另一个常见的“数据幻觉”是:
建立了 1000 个 Query。
于是宣布:
Query Coverage = 1000
这没有意义。
Query 数量不是 Coverage。
真正应该问:
用户的重要意图是否被覆盖?
可以先把 Query 分成 Intent:
Brand
Product
Comparison
Purchase
Price
Risk
Technology
Usage
After-sales
Reputation
假设某行业经过研究定义了 10 个核心 Intent。
企业的知识体系有效覆盖其中 8 个:
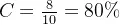
更进一步:
如果不同 Intent 重要性不同,可以采用权重:
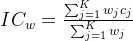
其中:
 :Intent 权重
 :该 Intent 是否达到覆盖标准
例如购买决策类问题可能比泛科普问题权重更高。
但权重必须提前制定。
十二、指标五:Stability——同一个 Query,答案稳定吗?
这是 GEO 评估最容易被忽略的一项。
假设同一个问题运行 10 次:
品牌出现:
7 次

品牌未出现:
3 次
Mention Rate:

但是如果:
今天 100%
明天 20%
后天 90%
这并不是一个稳定状态。
所以需要加入:
Run-to-Run Stability
最简单的方法可以使用伯努利变量的标准差:
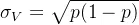
其中:
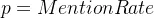
但只看这个值还不能描述时间漂移。
更加实用的做法,是把每个时间窗口的 GEO 指标记为:

计算:

即变异系数:
 :时间窗口之间的标准差
 :均值
CV 越低,说明指标相对越稳定。
但要注意:
CV 在均值接近 0 时不适合使用。
因此企业需要根据具体指标选择稳定性统计方法,而不是强行统一。
十三、不要只做一次 Query:建立 Query Variant
用户不会永远用同一句话提问。
例如:
A品牌靠谱吗?
可以有:
A品牌怎么样?
A品牌值得买吗?
A公司可信吗?
A产品质量如何?
A和B哪个靠谱?
语义相近,但不是同一个字符串。
所以应该定义:
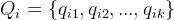
其中:
 :一个用户意图
 :该意图下不同表达方式
然后:
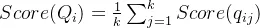
这样能减少“企业只针对固定提示词优化”的问题。
十四、Query 不能全部由 AI 自动生成
这一点需要特别提醒。
AI 很适合辅助扩展 Query。
例如从:
“新能源汽车安全性”
扩展出:
碰撞安全
电池安全
起火风险
儿童安全
高速安全
但如果企业完全让 AI 自己生成测试集,就可能产生:
人为不存在的问题
过度模板化问题
真实用户几乎不问的问题
与企业业务无关的问题
因此 Query Set 最好由多种来源构成:
Search Console / SEO 搜索词
站内搜索
客服问题
销售咨询
社交平台评论
搜索联想
公开问答平台
真实用户调研
AI 辅助扩展
AI 应该用于扩展。
而不应该成为唯一来源。
十五、指标六:Freshness——AI 引用的是不是旧事实
第一篇已经讨论过 Digital Fact Debt。
第二篇需要把它变成指标。
假设企业有 条仍可能被公开调用的核心 Claim:
其中:
 :当前有效
 :已经过期
则:

定义为 Fact Freshness Rate。
例如:
1000 条事实
有效 930 条
过期 70 条
那么:

另外也可以定义:
Outdated Answer Rate
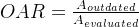
例如:
200 个回答
18 个使用了旧产品信息
则:

这个指标对于:
价格
库存
产品版本
认证
高管
政策
法规
市场数据
尤其重要。
《规范》也明确要求价格、监管状态、资质有效期、市场数据等时效性事实设置有效期、复核频率或触发式更新条件。
十六、最终要不要做一个 GEO Score?
可以。
但一定要非常谨慎。
很多行业工具最大的一个问题,就是制造一个:
GEO Score = 82
然后不给用户解释 82 是怎么算出来的。
这种分数很容易成为“伪精确”。
企业内部可以建立 Composite Score。
但是:
Composite Score 应该用于管理,不应该被宣传成 AI 平台的官方排名分。
例如可以定义:
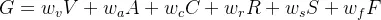
其中:
 :Visibility
 :Accuracy
 :Citation Quality
 :Claim Recall
 :Stability
 :Freshness
并满足:

例如:
Visibility      20%
Accuracy        25%
Citation        20%
Claim Recall    15%
Stability       10%
Freshness       10%
那么:
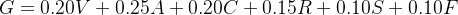
注意:
这只是一个企业管理模型示例。
不同企业应该根据自己的风险和业务目标重新定义。
例如:
医疗企业:
Accuracy 权重更高
Evidence 权重更高
消费品牌:
Visibility
Recall
Citation
可能相对更重要。
十七、为什么有时候乘法模型比加法模型更合理
还有另一种思路:
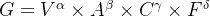
这种模型的特点是:
任何一个核心指标接近 0,整体得分都会显著下降。
例如:
Visibility = 90%
Accuracy = 30%
使用加权平均以后,结果可能仍然不算太低。
但从企业风险角度:
AI 非常频繁地提到品牌,但是 70% 的信息可能不正确。
显然不能称为优秀 GEO。
因此对于高风险行业,我更倾向于:
核心风险指标设置“门槛”,而不是单纯平均。
例如:
Accuracy < 95%
→ 不允许评为 A 级
或者:
出现重大错误 Claim
→ 项目直接进入 Risk Review
这与《规范》的思路也是一致的。
标准明确指出,效果观察结果不能抵消合规风险;如果存在核心事实未经核验、虚假宣传、AI 标识或数据安全等重大问题,不应仅因为效果指标良好就判断项目合格。
十八、企业 GEO 应该使用“门槛 + 综合评分”
因此,更成熟的模型不是:
只看 GEO Score
而是:
Hard Gate
+
Composite Score
例如:
Gate 1
重大事实错误 = 0

Gate 2
高风险违规 Claim = 0

Gate 3
核心事实证据链完整率 ≥ 95%

Gate 4
Accuracy ≥ 95%

--------------------

通过 Gate 后:

再计算 Visibility
Citation
Recall
Stability
Freshness
这里的 95% 仍然是示例阈值,而不是标准强制要求。
真正的阈值应该由企业自己的:
行业风险
业务风险
法律要求
内部 SLA
共同决定。
十九、RAG 评估体系对 GEO 有什么启发?
RAG 和 GEO 并不相同。
但 RAG Evaluation 给 GEO 提供了非常好的方法论参考。
ARES 是 Saad-Falcon、Khattab、Potts 和 Zaharia 在 NAACL 2024 发表的一套 RAG 自动评估框架。
它重点评估三个维度:
Context Relevance
Answer Faithfulness
Answer Relevance
也就是:
检索出来的内容和问题是否相关?
答案是否忠于检索到的内容?
答案是否真正回答了用户的问题?
ARES 同时通过少量人工标注配合自动化评估,而不是完全依赖一个 LLM Judge 自己打分。
这一点对 GEO 非常值得借鉴。
企业 GEO 也不应该:
GPT-5 判断 GPT-5 是否正确
然后完全相信自动分数。
二十、LLM-as-a-Judge 可以用,但不能成为唯一裁判
一个成熟的 GEO 监测系统可以采用:
AI 自动抽取
↓
AI 自动初判
↓
规则校验
↓
人工抽样
↓
高风险人工复核
例如:
Step 1
LLM 从回答中抽取 Claim

Step 2
Claim 与 Fact Database 匹配

Step 3
程序检查数值 / 日期 / 实体

Step 4
LLM 判断语义一致性

Step 5
10% 人工抽检

Step 6
高风险行业全部关键 Claim 人工复核
而不是:
一个模型
↓
自动生成答案
↓
另一个 Prompt
↓
自动说“正确”
否则很容易形成:
Evaluation Hallucination
即:
评估系统本身也产生幻觉。
二十一、一次专业 GEO 测试应该怎么设计?
可以使用:
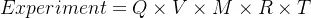
其中:
 :Query
- :Query Variant
- :Model
- :Independent Run
 :Time Point
例如:
100 个 Query
×
3 个表达变体
×
5 个 AI 平台
×
3 次独立测试
×
4 个时间点
总观测数:
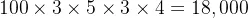
这里的 18,000 只是计算示例,不代表行业标准样本量。
真正的测试规模要根据:
预算
Query 数量
模型 API 成本
行业风险
监测频次
来决定。
重点是:
GEO Measurement 必须控制变量并保留实验记录。
二十二、推荐企业建立 Benchmark,而不是永远看绝对值
假设:
Month 1 GEO Score = 42
Month 2 GEO Score = 56
56 到底好不好?
不知道。
所以必须建立 Baseline。
定义:
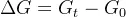
其中:
 :项目开始前 Baseline
 :当前结果
还可以计算相对变化:
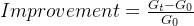
假设:
Baseline = 40
Current = 50
则:
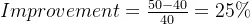
但一定要注意:
这个 25% 是企业自定义 GEO Score 的相对变化。
绝不能包装成:
“AI 推荐率增长 25%”
除非你的指标本身测量的就是推荐率。
二十三、GEO 最好做 Control Group
如果企业发布了 100 篇新内容以后:
Mention Rate:
40% → 60%
可以直接说:
这 100 篇内容带来了 20% 提升
吗?
不能。
因为同期可能发生:
品牌新闻事件
模型升级
官网改版
市场热度增加
竞品负面事件
搜索索引更新
季节变化
所以最好建立某种 Control。
例如:
优化 Query Group
vs
未优化 Query Group
然后:
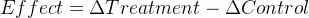
这其实就是最简单的 Difference-in-Differences 思路。
例如:
优化组:
40% → 60%
+20pp

控制组:
42% → 50%
+8pp
那么可归因增量可以粗略估计为:
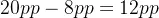
这里仍然必须谨慎。
在真实 GEO 环境下,完全满足因果推断条件通常很困难。
因此更准确的表达应该是:
“在当前测试设计下观察到与优化相关的增量变化。”
而不要轻易说:
“证明 GEO 导致增长 12%。”
二十四、企业 GEO Dashboard 最终应该长什么样?
一个比较完整的 Dashboard 可以包括:
| 模块 | 核心指标 |
|---|---|
| Entity | 实体识别正确率、实体混淆率 |
| Claim | 核心事实覆盖率、错误事实率 |
| Evidence | 证据链完整率、有效证据率 |
| Query | Intent 覆盖率、Query 覆盖率 |
| Visibility | Brand Mention Rate、Weighted Visibility |
| Accuracy | Claim Accuracy、Unsupported Claim Rate |
| Citation | Citation Rate、Precision、Coverage |
| Recall | Core Claim Recall |
| Stability | Run Variance、Time Variance |
| Freshness | Fact Freshness、Outdated Answer Rate |
| Risk | 严重错误、违规 Claim、异常传播 |
| Business | AI Referral、Lead、Conversion |
特别强调:
最后的:
AI Referral
Lead
Conversion
不应该和:
AI Visibility
混为一谈。
因为:
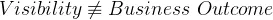
曝光只是中间变量。
二十五、从技术架构看,GEO Monitoring 应该怎么实现?
一个企业级 GEO Monitoring Pipeline 可以设计为:
Query Repository
      ↓
Scheduler
      ↓
Multi-model Runner
      ↓
Raw Response Store
      ↓
Citation Extractor
      ↓
Entity / Claim Extractor
      ↓
Fact Validation
      ↓
Metric Engine
      ↓
Risk Detection
      ↓
Dashboard
      ↓
Human Review
      ↓
Correction Queue
核心数据库至少需要:
query_id
query_variant_id
model_id
run_id
timestamp
answer
entities
claims
citations
accuracy
visibility
risk_status
这样同一个 Query 才能真正做:
模型对比
时间对比
版本对比
趋势对比
二十六、监测系统真正的价值不是“看分数”,而是找到问题发生在哪一层
假设 GEO Score 下降。
不要立刻下结论:
内容做得不好。
真正应该沿链路排查:
Query
↓
Retrieval
↓
Source
↓
Entity
↓
Claim
↓
Citation
↓
Answer
例如:
Case A
品牌完全没有出现
可能是:
Retrieval 问题
Case B
品牌出现,但是描述错误
可能是:
Claim / Source 问题
Case C
AI 描述正确,但没有引用官网
可能是:
Citation / Source Competition 问题
Case D
引用官网,但是答案仍然错误
可能是:
上下文理解 / Citation Faithfulness 问题
所以:
GEO Monitoring 本质上应该是 Debugging System。
而不是排行榜。
二十七、企业 GEO 真正应该优化的是“信息传输损耗”
如果把整个 GEO 系统抽象成:
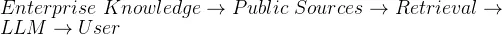
那么每一层都会产生信息损失。
我们可以用一个概念模型表示:
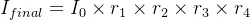
其中:
 :企业原始知识质量
 :知识到内容的保真率
 :内容被检索到的概率
 :检索内容被模型正确理解的概率
 :最终回答正确传达的概率
这不是现有论文定义的正式 GEO 方程。
但它很好地解释了一个现实:
任何一层接近 0,前面的努力都会大量损失。
例如:
事实库非常完整
但官网无法抓取。
那么:

最终效果仍然很低。
或者:
曝光非常高
但知识本身就是错的。
那么:
本身就存在问题。
二十八、为什么 GEO 不能只优化“答案”
成熟 GEO 的目标不应该是:
让 AI 多说我。
而应该是:
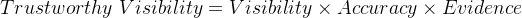
进一步再加入:
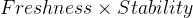
最终形成:
Trustworthy Visibility
可信可见性。
这个概念比单纯:
AI Visibility
更适合企业。
因为企业真正需要的不是:
被 AI 看到。
而是:
被 AI 正确地看到。
结语:GEO 下一阶段竞争的不是“谁监测更多模型”,而是谁拥有更好的测量系统
第一阶段的 GEO 行业,很容易围绕:
是否收录
是否提及
是否推荐
展开。
但真正进入企业级应用以后,这远远不够。
成熟的 GEO 应该能够回答:
AI 有没有找到企业?

找到的是哪个实体?

说了哪些 Claim?

这些 Claim 正确吗?

证据来自哪里?

引用真的支持结论吗?

核心信息召回了多少?

结果是否稳定?

是否存在旧数据?

变化能否归因于我们的优化?

发生错误以后能否定位问题?
当这些问题都能被系统化回答时:
GEO 才开始从:
Marketing Experiment
进入:
Engineering System
第一篇的核心是:
Entity
→ Claim
→ Evidence
→ Query
→ Knowledge Hub
第二篇是它的补充:
Query
→ Observation
→ Claim Validation
→ Citation Validation
→ Metrics
→ Diagnosis
→ Correction
两篇文章合在一起,才形成一个完整闭环:
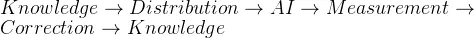
这才是企业 GEO 真正应该建设的工程体系。
参考文献
- Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. GEO: Generative Engine Optimization. Proceedings of the 30th ACM SIGKDD Conference on Knowledge Discovery and Data Mining (KDD ’24), 2024, pp. 5–16. DOI: 10.1145/3637528.3671900.
- Liu, N. F., Zhang, T., & Liang, P. Evaluating Verifiability in Generative Search Engines. Findings of ACL: EMNLP 2023, pp. 7001–7025. DOI: 10.18653/v1/2023.findings-emnlp.467.
- Saad-Falcon, J., Khattab, O., Potts, C., & Zaharia, M. ARES: An Automated Evaluation Framework for Retrieval-Augmented Generation Systems. NAACL 2024, pp. 338–354. DOI: 10.18653/v1/2024.naacl-long.20.
- 中国新闻技术工作者联合会:《生成式引擎优化(GEO)可信信息传播与信息生态治理规范》,T/CAPT 026—2026。

