大家好,我是数据库小学妹👋 我踩过的坑,你别再踩。
去年一个同城双活的项目上线三个月,客服开始集中收到一类投诉。用户说,我上午改过的收货地址,下午又变回旧的了。让他再改一次,过两天可能又回去。运维把链路查了个遍。两个中心都在正常写,同步也在正常跑,日志里一条报错都没有。
我一开始怀疑是缓存,把两个中心的缓存全清了,问题照旧。后来把那条记录的历史版本拉出来看。它一天里被改了四次,两个中心各改两次,互相覆盖。最后留下的是哪一版,取决于同步的到达顺序,而这个顺序每次都不同。
那次之前,我以为双活就是两套库都开着,谁接流量都行。那次之后我才明白,"两个地方都能写"这六个字有多重。
先分清容灾和多活
这两个词经常被混着用,但它们不是一回事。
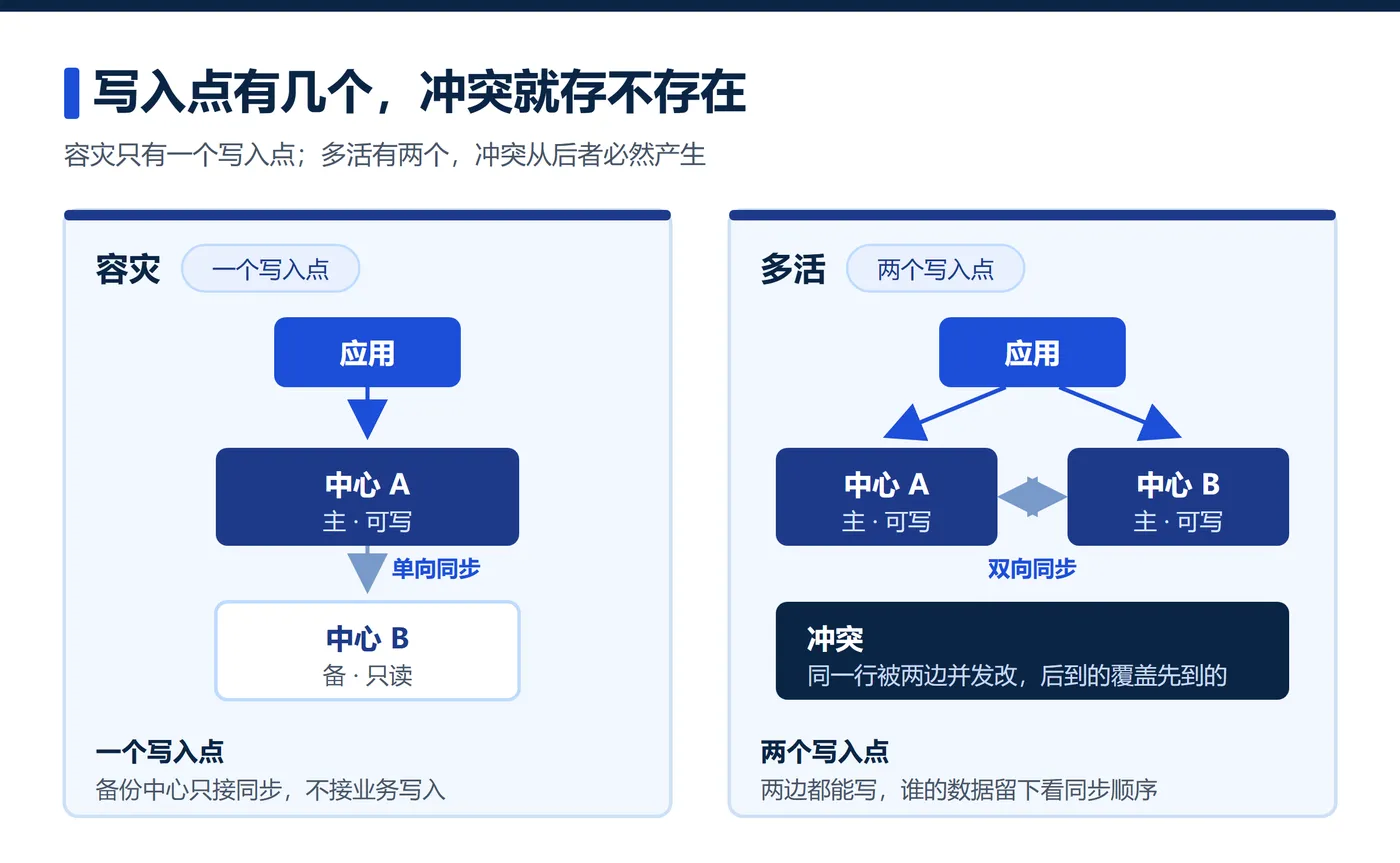
容灾是备着不用。主备、两地三中心都属于这个路子,金仓这类国产库在这一档也有方案。备用中心平时不接写入,只在主中心挂了以后接管。数据是主中心同步过去的,只有一条写入链路。这种形态下不存在写冲突,因为写的源头只有一个。
多活是两边都在写。同城双活、异地多活都属于这一类。只要有两个地方同时接受写入,冲突就是必然的,不是概率。这跟你配置得好不好没关系。"两个写入点"这个前提本身就带着矛盾。
很多人上多活,第一反应是"多一个中心多一层保险"。它换来的可用性提升,代价是问题从数据库搬进了业务代码。这笔账要提前算。
| 维度 | 容灾 | 多活 |
|---|---|---|
| 备用中心接不接写 | 不接 | 接 |
| 写入点 | 一个 | 多个 |
| 写冲突 | 不存在 | 必然存在 |
| 解决的问题 | 主中心故障后能顶上来 | 两个中心都在承载业务 |
| 典型形态 | 主备、两地三中心 | 同城双活、异地多活 |
| 主要代价 | 备用资源平时闲置 | 一致性复杂度上移到业务 |
冲突只有三种来源
实际遇到的冲突看着五花八门,归到根上就三类。
第一类是用户投诉里最常见的那种。用户在离自己近的中心改资料。另一个中心的副本被别的流程也改了。两条修改各自往对面同步,谁覆盖谁看的是到达顺序。
第二类最隐蔽。两个中心各查本地,都查不到重复,就都写进去了。等数据同步过来才发现有两条一模一样的唯一键。
第三类最基础。发号本身是写操作。只要两个中心都在发号,撞号就一定会发生。
| 冲突来源 | 具体表现 | 为什么必然发生 |
|---|---|---|
| 同一行并发改 | 两个中心同时改同一行,后同步的覆盖先同步的 | 两边都能写,就没有唯一的先后顺序 |
| 跨中心唯一约束 | 两边同时建了编号相同的单据,本地校验都通过 | 唯一性要看全局,本地看不到对方 |
| 自增与序列 | 两个中心发出来同一个主键 ID | 各自独立发号,没有共享的号源 |
冲突率是可以算出来的。取一个时间窗口,看同一主键被两个中心都改过的比例。这个占比就是你的冲突率。
-- 写冲突率:同一主键在同一分钟窗口内被两个中心都改过的比例
SELECT
  SUM(CASE WHEN center_cnt > 1 THEN 1 ELSE 0 END) / COUNT(*) AS conflict_ratio
FROM (
  SELECT
    pk_id,
    FLOOR(UNIX_TIMESTAMP(modify_ts) / 60) AS win,
    COUNT(DISTINCT center_id) AS center_cnt
  FROM change_log
  GROUP BY pk_id, win
) t;
这个窗口的粒度需要根据表的更新频率来定,高频表用分钟,低频表用小时。粒度太细会把正常的先后修改误判成冲突,太粗又会漏掉真正的并发写。这个数摸清之前,任何多活方案都只停在纸面上。
四个方案,逐个说
单元化:让一份数据只从一个地方写
这是核心系统里最主流的做法,叫 Set 化。
思路很直接。既然冲突来自"两个地方都能写",那就规定每份数据只有一个地方能写。按一个业务维度把流量切开,比如按用户 ID 取模,前一半走中心 A,后一半走中心 B。同一个用户的所有写请求,永远落到同一个中心。另一边只放只读副本,不接写。
同一行数据的写入点只剩一个,冲突从源头就没了。难点不在数据库,在路由。接入层要保证同一个用户的请求每次都被分到同一个单元。这个判断不能在各个应用里各写各的,要在接入层统一做。有一个应用漏了这条规则,自己连了另一个中心写,前面的设计全白费。
单元化还有一笔代价,跨单元访问。用户 A 要转钱给用户 B,两人如果分属两个单元,这笔操作就跨了单元。要么在应用层拆成两次单元内调用,要么走一条专门的跨单元通道。业务切得越干净,这类调用越少。切不干净,跨单元调用就会变成新的瓶颈。所以单元化的前提,是业务能被干净地切开。
最后写入胜出:简单,但会静默丢数据
这个方案叫 Last Write Wins。每条写入带一个时间戳,两个中心的数据撞上,谁的时间戳新谁留下。
实现简单,代价是静默丢数据。被覆盖的那条修改不报错,不留痕,就那么没了。用户看到自己的修改失效,系统这边什么都不知道。
它还依赖时钟。时钟一漂,谁"最后"写就说不准。普通做法用 NTP 同步物理时钟,但物理时钟会回拨、会跳变,网络一抖偏差就上去。工程上用得多的是混合逻辑时钟,把物理时间和一个逻辑计数器拼起来,保证单调递增。它能处理同一物理时刻内的先后排序,处理不了时钟本身已经漂错的情况。
用最后写入胜出,就得配监控。持续测两个中心的时间偏差,超过阈值立刻告警。
-- 时钟漂移监控:偏差超过 50 毫秒的记录
SELECT
  center_id,
  drift_ms,
  check_ts
FROM center_clock_drift
WHERE ABS(drift_ms) > 50
ORDER BY ABS(drift_ms) DESC;
50毫秒这个阈值对同城双活是合理的,因为同城RTT通常在1毫秒以内。异地多活的跨城RTT通常30到50毫秒,漂移阈值要按实际RTT来定,不能直接照搬。原则是:漂移量不能超过跨中心RTT的量级,否则时间戳排序就会失去意义。
跨中心共识同步写:把跨城延迟写进响应时间
这个方案的思路是,写入不落单边,要等多数派确认才算成功。靠 Paxos 或 Raft 这类共识协议来做。
好处是一致性强,不用操心覆盖。代价是延迟。同城两个数据中心的网络往返大概 1 毫秒,异地通常 30 到 50 毫秒。写入要等多数派,多数派里必然有跨城的那一个,这几十毫秒就直接进了响应时间。
更麻烦的是抖动放大。跨城网络一抖,P99 立刻跟着跳,业务侧的感受是"偶尔卡一下"。这种卡顿在应用日志里看不出来,得去看网络延迟分布才找得到。这套方案适合写入量不大、一致性要求极高的场景。放在高并发的交易链路上,跨城延迟会直接吃掉响应预算。
冲突检测与合并:适合能合的数据
前三个方案都在想办法避免冲突,这个方案承认冲突,然后把两条并发修改合起来。
工具是版本向量。给每条数据挂一份各中心的修改计数,合并时对比向量,能判断两次修改是"有先后"还是"并发"。有先后就取新的,并发才需要业务介入。
能合并的数据还能做自动合并,这类专门的数据结构叫 CRDT。计数器可以合并,集合可以合并,某些形态的寄存器也可以合并。两个中心各给一篇文章点了赞,合并时把计数加起来就行。
余额不行。余额的两个并发修改,语义上未必能相加。A 中心扣了 100,B 中心也扣了 100,用户实际只该被扣一次。这类数据的正确性很难靠合并算法保证,得把账户的写入点收敛到一边。绕一圈,又回到了单元化。
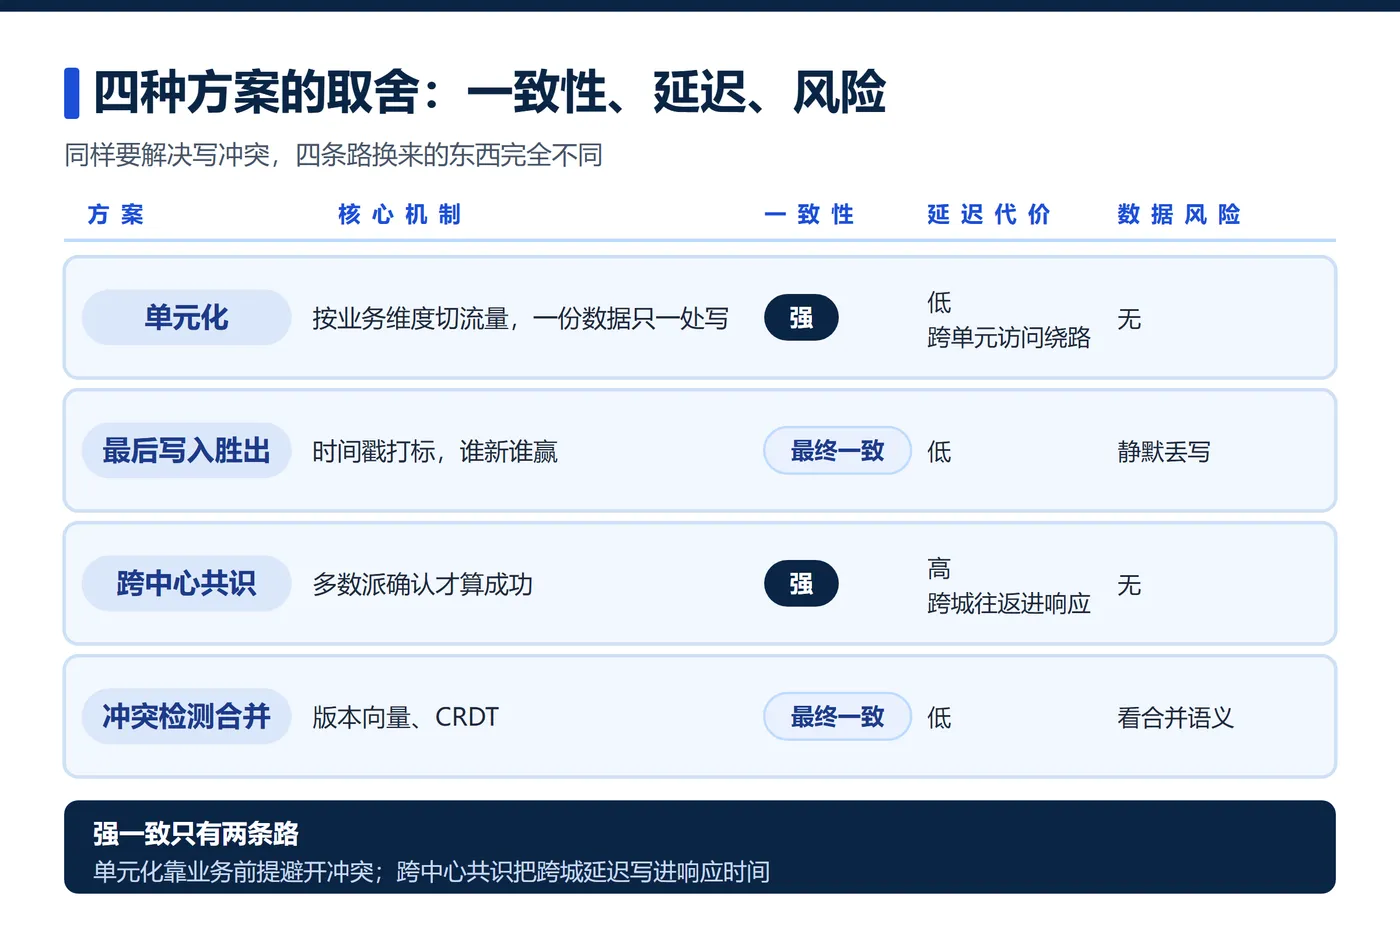
| 方案 | 机制 | 一致性 | 延迟代价 | 数据风险 | 适用条件 |
|---|---|---|---|---|---|
| 单元化 | 按业务维度切流量,一份数据只一个中心写 | 强 | 跨单元访问要绕路 | 无 | 业务切得干净 |
| 最后写入胜出 | 时间戳打标,谁新谁赢 | 最终一致 | 低 | 静默丢写 | 冲突少、可容忍丢 |
| 跨中心共识 | 多数派确认才算成功 | 强 | 跨城 RTT 进响应 | 无 | 写入量低、强一致刚需 |
| 冲突检测与合并 | 版本向量、CRDT | 最终一致 | 低 | 看合并语义 | 数据本身可合并 |
唯一性约束是最难的一块
三类冲突里,唯一性约束要单独拎出来说,因为它没有又好又省的办法。
我见过的做法大多是号段预分配。它把冲突概率压到"段用完的那一刻",日常运行不受影响。但要接受号的浪费,也得有一套段用完时的续领流程。
| 解法 | 做法 | 代价 |
|---|---|---|
| 集中分配 | 一个中心统一发号,别的中心来取 | 发号中心成了新单点,跟多活的初衷相反 |
| 号段预分配 | 每个中心预领一段号,段之间不重叠 | 段用完要重分,各中心用量不均时会浪费 |
| 跨中心校验 | 写入前先去其他中心查一遍 | 多一次跨中心往返,本质还是分布式锁 |
还有一种是最终一致加补偿。先写进去,事后对账发现重复再合并。这要求业务能容忍短暂重复,比如允许两个用户看到同一个订单号几分钟。
自增主键也有类似的坑。传统做法是给两个中心的自增步长错开。
-- 两个中心的自增步长错开,避免撞号
-- 中心 A
SET @@auto_increment_increment = 2;
SET @@auto_increment_offset   = 1;   -- 产出 1,3,5,7...
-- 中心 B
SET @@auto_increment_increment = 2;
SET @@auto_increment_offset   = 2;   -- 产出 2,4,6,8...
-- 加第三个中心时步长要改成 3,新号段会和已有数据撞在一起
两个中心时它够用。要扩第三个中心,步长得从 2 改成 3,历史号段立刻重叠。这种分法从设计上就没给扩容留余地。
避坑清单
最后写入胜出依赖时钟,必须配时钟同步,并且持续监控漂移量。漂移阈值要提前定,超了就告警。别等用户来投诉,才发现两边的时间早就差了半秒。
单元化的路由必须在接入层统一做,不能靠各个应用自己判断。这条规则只要有一个应用没遵守,数据就会从那个缺口漏到另一个中心去写。
最后一条是我自己搞错的。我一开始以为每个中心都能写、读写都走本地就完事了。没想到用户在自己中心刚写完,下一次请求被负载均衡甩到另一个中心,读到的是同步还没到的旧数据。用户以为没保存成功,又点了一次保存。后来补上了会话粘性,让同一个用户的读写固定走同一个中心。
写在最后
多活的第一步不是加中心,是找一个能把写入干净切开的维度。找不到这个维度,硬上多活只是把一致性问题从数据库搬到了业务代码里。
容灾和多活也不是一回事。容灾解决的是"主中心挂了怎么办",多活解决的是"两个中心都别闲着"。前者是底线,后者是能力的进阶。我的做法是先有容灾,再谈多活。顺序反过来,风险会高很多。
我现在判断一个系统该不该上多活,先问三个问题。写入能不能按一个维度切开。切不开的那部分占比多少。业务能不能容忍短暂的重复或者丢失。三个答案基本就定了走哪条路,或者干脆不走。
你手上的系统,多活的流量是按什么维度切的?评论区聊聊。
我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见👋