
人行道场景检测数据集 | 10300张YOLO智慧城市数据集
适用于无障碍导航、街道环境感知与目标检测研究
一、数据集概述
本数据集面向 计算机视觉 目标检测任务,专为人行道/街道场景中的多类目标(行人、车辆、道路设施及穿戴物品等)检测模型训练、验证与测试设计,共包含约10300张高质量标注图像,覆盖21 类 街道环境核心目标。该数据集可广泛应用于盲道/无障碍导航、智能出行辅助、街道环境感知、智慧城市管理等场景,适用于YOLOv5/v7/v8/v10/v11/v12等主流检测框架。
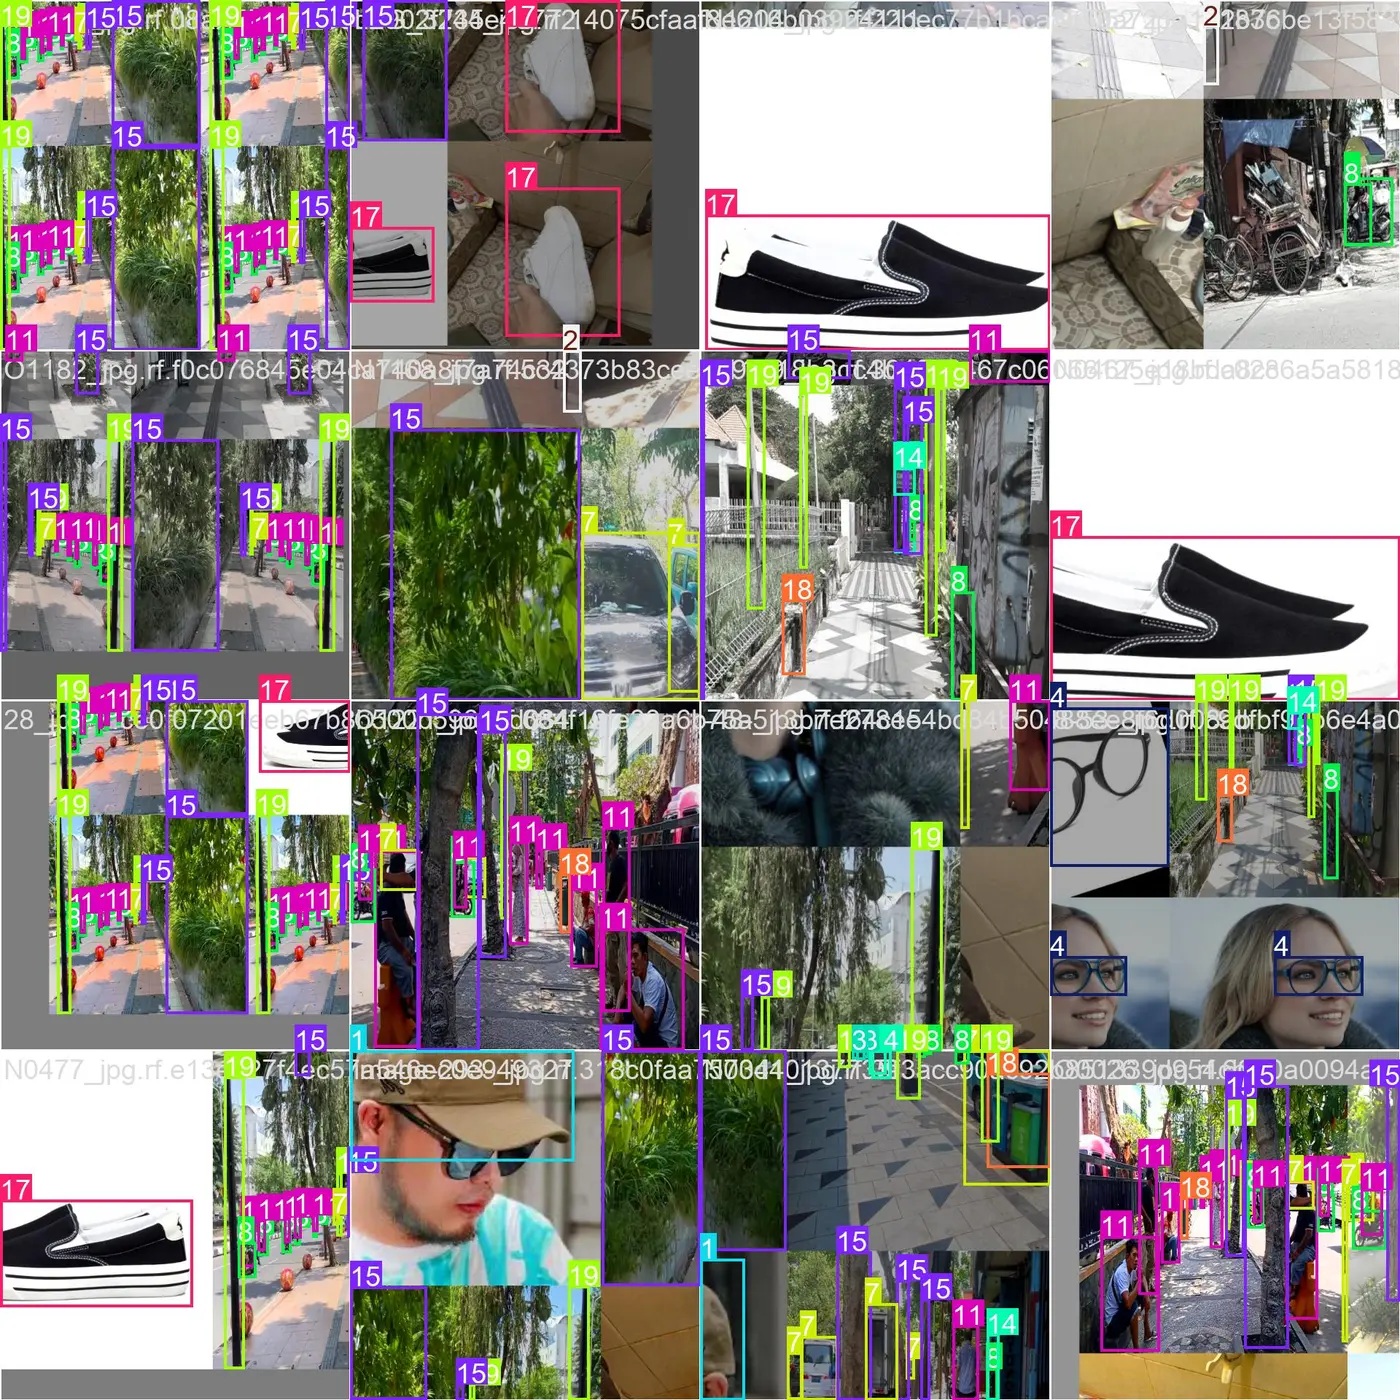
随着智慧城市建设和无障碍出行需求的不断提升,利用计算机视觉技术实现人行道场景的多目标感知已成为提升城市出行安全与便利性的重要手段。本数据集针对街道环境中目标类别多样、场景复杂度高、光照变化丰富等问题进行专项构建,可为智能出行辅助系统与城市环境感知设备提供高质量数据支撑。
数据集下载
通过网盘分享的文件:人行道场景检测-21类
链接: https://pan.baidu.com/s/1UiXMhCQQZ16TMVLpf3nmzQ?pwd=w6v7
提取码: w6v7
二、数据集基本信息
| 项目 | 内容 |
|---|---|
| 数据集名称 | 人行道场景检测数据集 |
| 数据规模 | 约10300张高质量标注图像 |
| 任务类型 | 目标检测(Object Detection) |
| 检测目标 | 21类人行道/街道场景目标 |
| 类别数量(nc) | 21类 |
| 标注方式 | Bounding Box目标框标注 |
| 数据格式 | YOLO标准格式 |
| 数据来源 | 真实街道与人行道场景采集 |
| 数据划分 | Train / Valid / Test |
| 适配模型 | YOLOv5、YOLOv7、YOLOv8、YOLOv10、YOLOv11、YOLOv12、Faster R-CNN等 |
三、数据集类别说明
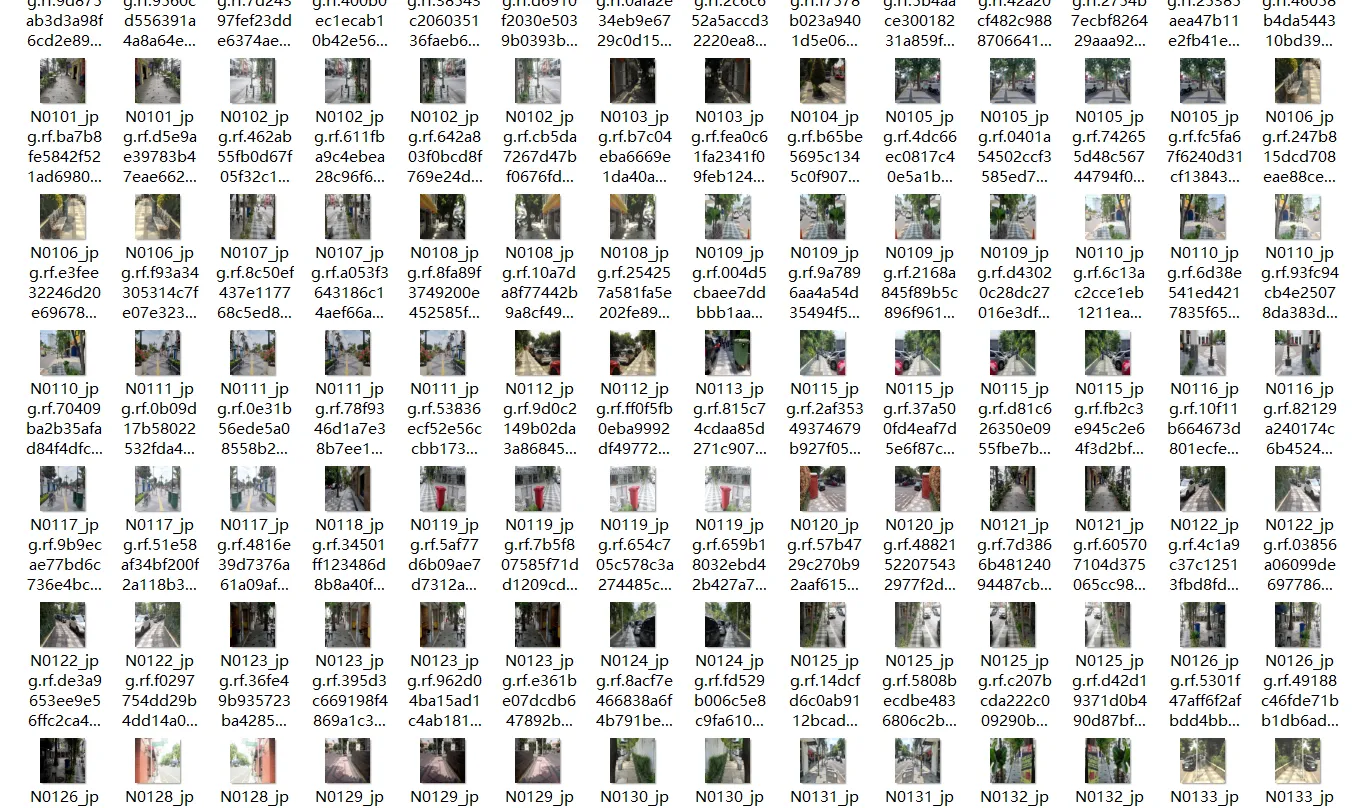
本数据集为多类别目标检测数据集,共设置21个检测类别,覆盖人行道/街道场景中的行人、车辆、道路设施及穿戴物品等多样目标,类别丰富,贴合智慧城市与无障碍出行实际需求。
类别配置
nc: 21

names:
  - backpack
  - hat
  - bench
  - bollard
  - glasses
  - traffic_light
  - mask
  - car
  - motorcycle
  - motorcycle_test
  - no_mask
  - pedestrian
  - pole
  - pole_test
  - sign
  - tree
  - planter
  - shoes
  - trash_can
  - rod
  - zebra_cross
类别详情
| 类别ID | 类别名称 | 英文名称 | 类别说明 |
|---|---|---|---|
| 0 | 背包 | backpack | 行人携带的背包/双肩包 |
| 1 | 帽子 | hat | 行人佩戴的各类帽子 |
| 2 | 长椅 | bench | 街道/人行道旁供休息的长椅 |
| 3 | 隔离桩 | bollard | 人行道或道路隔离桩/防撞柱 |
| 4 | 眼镜 | glasses | 行人佩戴的眼镜/墨镜 |
| 5 | 交通信号灯 | traffic_light | 路口交通信号灯 |
| 6 | 口罩 | mask | 行人佩戴的口罩(正样本) |
| 7 | 汽车 | car | 街道上的汽车/轿车 |
| 8 | 摩托车 | motorcycle | 街道上的摩托车 |
| 9 | 摩托车_测试 | motorcycle_test | 摩托车测试专用类别 |
| 10 | 未戴口罩 | no_mask | 行人未佩戴口罩 |
| 11 | 行人 | pedestrian | 人行道/街道上的行人 |
| 12 | 柱子 | pole | 街道上的立柱/灯柱 |
| 13 | 柱子_测试 | pole_test | 柱子测试专用类别 |
| 14 | 标志牌 | sign | 街道标志牌/指示牌 |
| 15 | 树木 | tree | 街道绿化树木 |
| 16 | 花盆 | planter | 街道花盆/绿化容器 |
| 17 | 鞋子 | shoes | 行人穿着的鞋类 |
| 18 | 垃圾桶 | trash_can | 街道公共垃圾桶 |
| 19 | 杆 | rod | 街道上的横杆/栏杆 |
| 20 | 斑马线 | zebra_cross | 人行横道/斑马线 |
21类设计从行人属性、交通工具、道路设施、街道环境四个维度完整覆盖人行道场景核心目标,场景复杂度高,贴近真实城市出行环境,为智慧城市与无障碍出行提供全面的视觉感知基础。
四、数据集结构说明
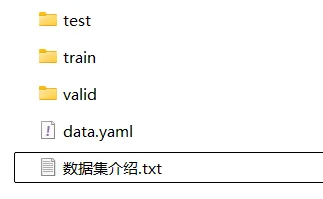
数据集采用标准YOLO目录结构组织,已按训练集、验证集、测试集进行科学划分,结构清晰,便于直接接入主流检测框架。
人行道场景检测-21类/
├── train
│   ├── images
│   └── labels
├── valid
│   ├── images
│   └── labels
├── test
│   ├── images
│   └── labels
└── data.yaml
各数据集作用如下:
- train/images & labels:训练集图像与标签,用于模型参数学习与特征提取;
- valid/images & labels:验证集图像与标签,用于超参数调优、早停监控及防止过拟合;
- test/images & labels:测试集图像与标签,用于最终模型性能评估与泛化能力测试。
标注文件为同名.txt格式,每行格式为类别索引 x_center y_center width height,坐标均为归一化值,配套 data .yaml已配置好类别名称与数量,可直接适配YOLO系列等目标检测框架。
五、数据集核心优势
1. 专注人行道与街道场景感知
本数据集以人行道/街道场景多目标感知为核心任务,所有图像聚焦于真实城市街道与人行道环境下的多类目标采集。类别设计贴合无障碍导航、智能出行与智慧城市管理实际需求,更利于训练出针对城市街道场景的高精度多 目标检测模型 。
覆盖场景包括:
- 城市主干道与次干道人行道
- 商业区步行街与广场
- 学校与医院周边街道
- 住宅区道路与社区街道
- 不同时段(白天/黄昏/夜间)
能够有效提升模型的实际部署效果。
2. 完整的街道目标谱系覆盖
21类标签从四个维度形成完整覆盖:
行人属性维度:
- 行人类:行人(核心主体)
- 穿戴类:背包、帽子、眼镜、口罩、未戴口罩、鞋子
交通工具维度:
- 汽车、摩托车
道路设施维度:
- 长椅、隔离桩、交通信号灯、标志牌、垃圾桶、斑马线、柱子、杆
街道环境维度:
- 树木、花盆
覆盖从“人”到“物”到“环境”的完整街道场景,为城市出行智能感知提供全面的数据基础。
3. 丰富的场景与目标形态
数据覆盖多种街道环境与目标状态:
- 人流车流密度:稀疏街道、常规人流、密集人群、交通拥堵
- 目标尺度:大型目标(汽车、树木)→中型目标(行人、长椅)→小型目标(帽子、眼镜、口罩)
- 行人姿态:站立、行走、坐姿、不同朝向
- 设施状态:完好、破损、不同摆放方式
场景贴近真实城市出行环境,有效提升模型泛化能力。
4. 多样的拍摄条件
数据覆盖:
- 光照条件:白天强光、阴天散射光、黄昏低照度、夜间灯光等
- 天气条件:晴天、阴天、雨天等
- 拍摄角度:平视、俯视、侧视等不同视角
- 道路类型:宽幅主干道、窄幅支路、步行街等
- 城市风格:不同城市、不同区域特征
能够有效增强模型在真实城市环境中的鲁棒性。
5. 大规模高质量标注
约10300张高质量图像,样本量丰富,保障多类别模型训练的收敛性与泛化能力。所有图像均经过高质量人工精准标注:
- 边界框规整、无漏标/错标
- 21类目标判别标准统一清晰
- 密集场景下的独立标注处理
- 满足高精度多类别检测模型训练需求
有效保证模型训练质量。
6. 即用型数据组织
标准目录结构+data.yaml配置,无需复杂预处理,下载即可直接用于模型训练,降低使用门槛。
六、适用场景
盲道/无障碍出行辅助与导航
为视障人士出行辅助设备提供街道环境多目标感知能力,识别行人、障碍物、道路设施等,保障安全出行。
街道环境多目标感知与理解
应用于城市环境感知系统,全面理解人行道与街道场景中的各类目标分布与状态。
智慧城市与人行道设施管理
自动检测街道设施的完好状态与分布情况,辅助城市管理与设施维护决策。
自动驾驶 /机器人街道环境感知
为自动驾驶车辆、服务 机器人 提供人行道场景的环境感知能力,支撑路径规划与避障决策。
公共安全与城市管理
在公共安全与城市管理场景中监测街道人员活动与设施状态,辅助安防与管理决策。
教学科研
用于多类别目标检测算法验证与调优等科研场景。
七、适用研究方向
本数据集可广泛应用于以下研究领域:
- 城市街道场景理解研究(21类)
- 多类别目标检测研究
- 行人检测与属性识别研究
- 无障碍出行与辅助导航研究
- 智慧城市与城市计算研究
- YOLO系列模型优化研究
- 轻量化检测模型与边缘部署研究
- 域适应与跨城市泛化研究
- 交通场景感知研究
- 公共空间设施管理研究
八、总结
人行道场景检测数据集包含约10300张高质量标注图像,采用标准YOLO格式构建,专注于人行道与街道场景的多目标检测任务。数据集覆盖背包、帽子、长椅、隔离桩、眼镜、交通信号灯、口罩、汽车、摩托车、未戴口罩、行人、柱子、标志牌、树木、花盆、鞋子、垃圾桶、杆、斑马线等21类核心目标,具有类别丰富、场景真实、标注精准等特点,可广泛应用于无障碍导航、智慧城市管理、街道环境感知、自动驾驶等领域,是开展城市街道场景智能感知算法研发与智慧城市系统建设的优质数据资源。

