
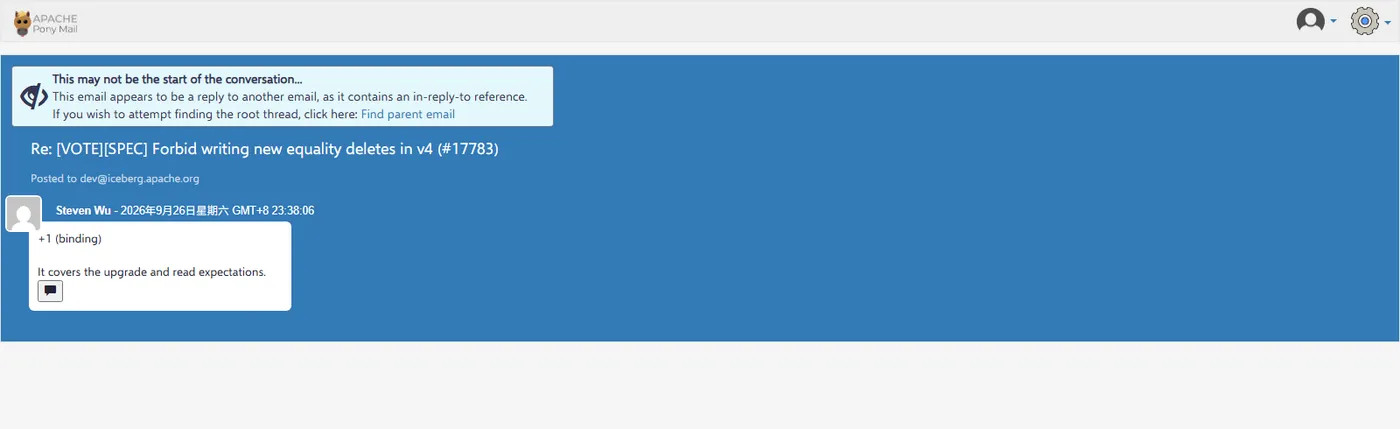
九月底,Apache Iceberg 的 dev 邮件列表上挂出一个投票,标题是 [VOTE][SPEC] Forbid writing new equality deletes in v4。
翻译过来就一句话。
下一版规范 v4 里,社区打算正式禁止大家再写一种用了五年的删除格式。
一种格式要被一本正经地讨论着禁掉,说明它欠的债,比带来的方便多了。
这笔账得从「删一行数据」说起。
这事在数据库里是日常操作,在数据湖里曾经是个大工程,而且是 Iceberg 花了三个大版本、到 v3 才算真正做利索的工程。
把这段账翻完,你就明白 spec 推到 v3 这件事,比湖仓圈大半的热闹都重要。
先立个背景。
Iceberg 的表不是一堆孤立文件的集合,它是一份元数据加一批数据文件加一批删除标记的组合体。
每一版规范干的都是同一类活,把某种丑事管起来。
v1 管的是表长什么样,v2 管的是怎么删一行,v3 管的是把删除这件事从补丁收编成正编。
2021 年,v2 规范落地,第一次把行级删除写进了标准。
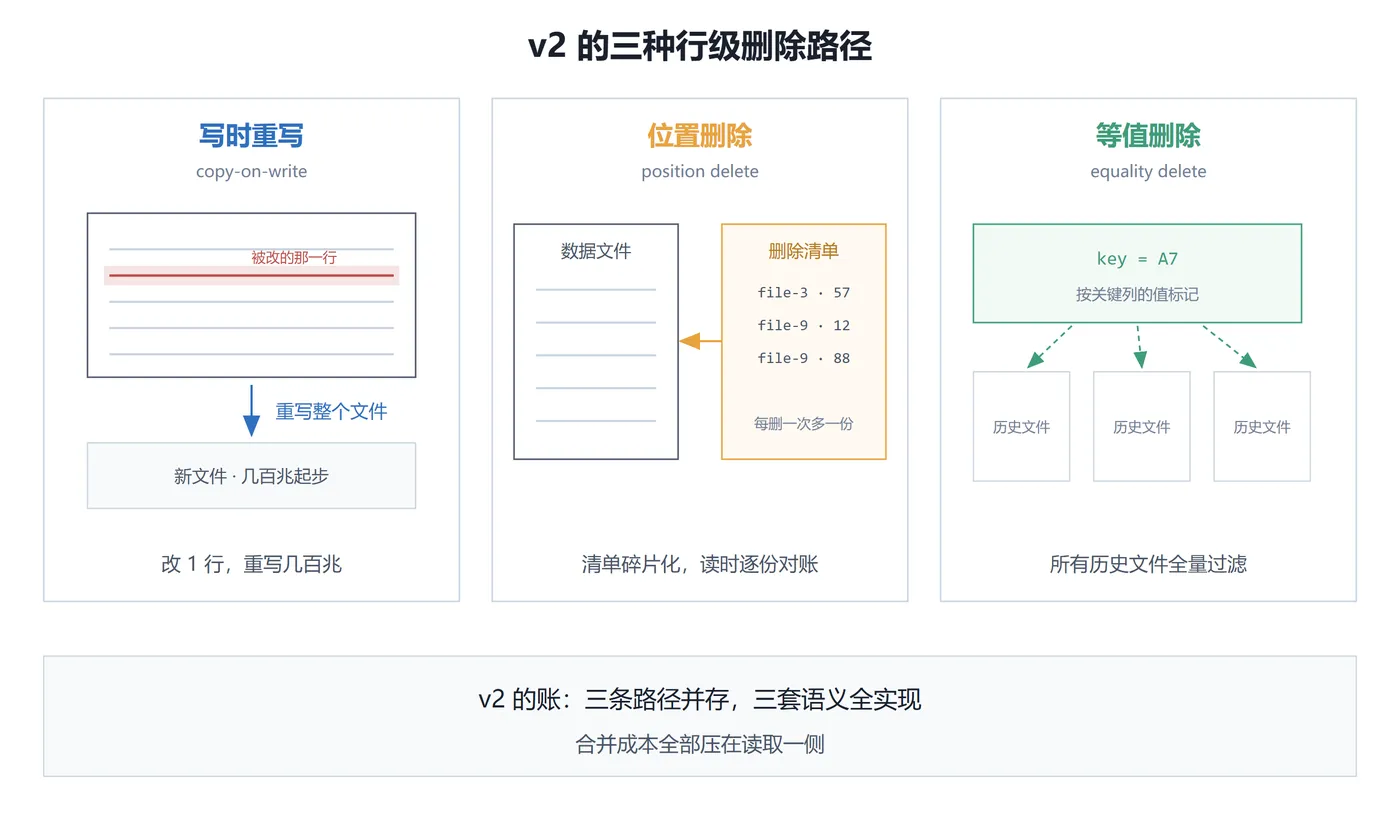
在那之前,湖里删数据基本只有一个办法,把受影响的数据文件整个重写一遍。
这个办法的学名叫 copy-on-write。
好处很直白,表永远干净,读的时候什么都不用合并。
坏处也很直白,你改一行,它重写一个文件。
数据文件几百兆起步,改十行就是几个 G 的写放大。
数据量小的时候这不算事。
表上亿行、更新天天有的时候,这玩意就是灾难。
写入的人扛不住,写入的账单也扛不住。
所以 v2 给了两个新选择。
都叫 delete file,思路是不碰数据文件,把「哪些行没了」单独记下来。
第一种叫 position delete。
记法很朴素,就两列,一列记数据文件路径,一列记行号。
file-3 的第 57 行没了,清单里就添一行。
读的时候,引擎拿着这份清单把对应行跳过去。
这套语义有个术语,叫 merge-on-read,读时合并。
第二种叫 equality delete。
它连行号都懒得记,只记关键列的值。
规则是,任何数据文件里只要某行的这几个列值跟清单对上了,这一行就当删了。
这个设计明显是给流式写入准备的。
Flink 往湖里打 CDC 数据,上游来一条删除事件,写入端根本不知道目标行躺在哪个文件的第几行,它手里只有这条数据的键。
按值标记,对写入端极其友好,一行都不用找。
写的人舒服了,读的人遭殃。
position delete 的毛病叫碎片。
每次删除或更新都生成一个新的 delete file,删一百次就是一百个小文件。
读一个数据文件之前,得先把跟它关联的清单全部捞出来对一遍。
合并压力全压在读取那一侧,查询延迟就是这么一点点烂掉的。
行业里对写入口径的态度也分了家。
偏批处理的写入端偏爱 copy-on-write,宁可写入贵一点,换读取永远干净。
偏流式的写入端只能选 merge-on-read,写入优先,读取的债以后再说。
两条路没有对错,但选了一条,就等于把另一边的成本签字画押认领了。
copy-on-write 还有条容易被忽略的连锁反应。
重写文件会生成新的快照,下游做增量消费的作业,是按文件变更来认新数据的。
重写出来的文件在增量视角里就是新面孔,处理不好,同一批数据会被下游再嚼一遍。
选写入模式之前把下游的增量链路一起看一遍,这步跳过的人,后面都在还债。
equality delete 的毛病更重。
它是按值标记,语义上要求每一份可能包含这些值的历史数据文件都过一遍这个条件。
意思就是,你上周删了一条数据,今天去查任何一张老分区的大表,只要分区规则没把数据隔开,那些文件全都要被这个删除条件重新筛一遍。
公平地讲,equality deletes 不是谁拍脑袋发明的坏东西。
它是 Flink CDC 那一代流式写入真正能用湖的唯一路径,撑了好几年,没有它,流式入湖在那个年代根本落不了地。
它只是把成本记在了读的头上,而读的成本,是要过很久才会被人算清楚的。
引擎侧的坑也是真踩出来的。
Trino 修过 equality delete 作用到嵌套字段上、读出重复数据的 bug。
Cloudera 的文档里挂着 MERGE 语句在 equality delete 表上失败的已知问题。
SeaTunnel 甚至出过一次事故,建表时字段配置不对,无意间把整套 equality delete 语义激活了。
这些东西散在各自的 release notes 里,单看哪条都不起眼,凑到一起就是一句话。
这套机制能用,但谁用谁扎手。
散落的 delete file 还带来了第二笔账,运维账。
Iceberg 的工具箱里躺着两个专门的维护过程,一个叫 rewrite_data_files,一个叫 rewrite_position_delete_files。
名字起得很诚实,就是把数据文件重写一遍、把删除文件重写一遍。
v2 时代认真用表的团队,几乎都得在自己的调度系统里安排这类合并作业。
不安排的,小文件和删除清单就越堆越多,表看起来还在跑,读取延迟已经悄悄烂掉了。
v2 还配了序列号语义来给删除定先后。
谁先删谁后删,哪条删除对哪些数据生效,全靠这套号排。
规范写到这个份上,复杂度已经开始外溢了。
老实讲,写到这里问题已经很清楚了。
删除一个操作,被拆成 copy-on-write、position delete、equality delete 三种做法,各有各的场景,各有各的坑。
三种做法在同一张表里还可能混着出现。
一个引擎要把三套语义全部实现、全部测对,才敢说自己完整支持 v2。
这就是 v2 留给全行业的账。
功能都有,代价是复杂度摊给了每一个读数据的人。
v3 是来收账的。
2025 年,Iceberg 规范推到 v3。
只看新特性清单的话,你会觉得这一版挺杂。
加了半结构化类型,加了纳秒精度时间戳,加了行级血缘,还加了几何空间类型。
这些都重要,但都不是这一版真正的主角。
主角是 deletion vector,中文圈常直接叫 DV。
它的思路不复杂。
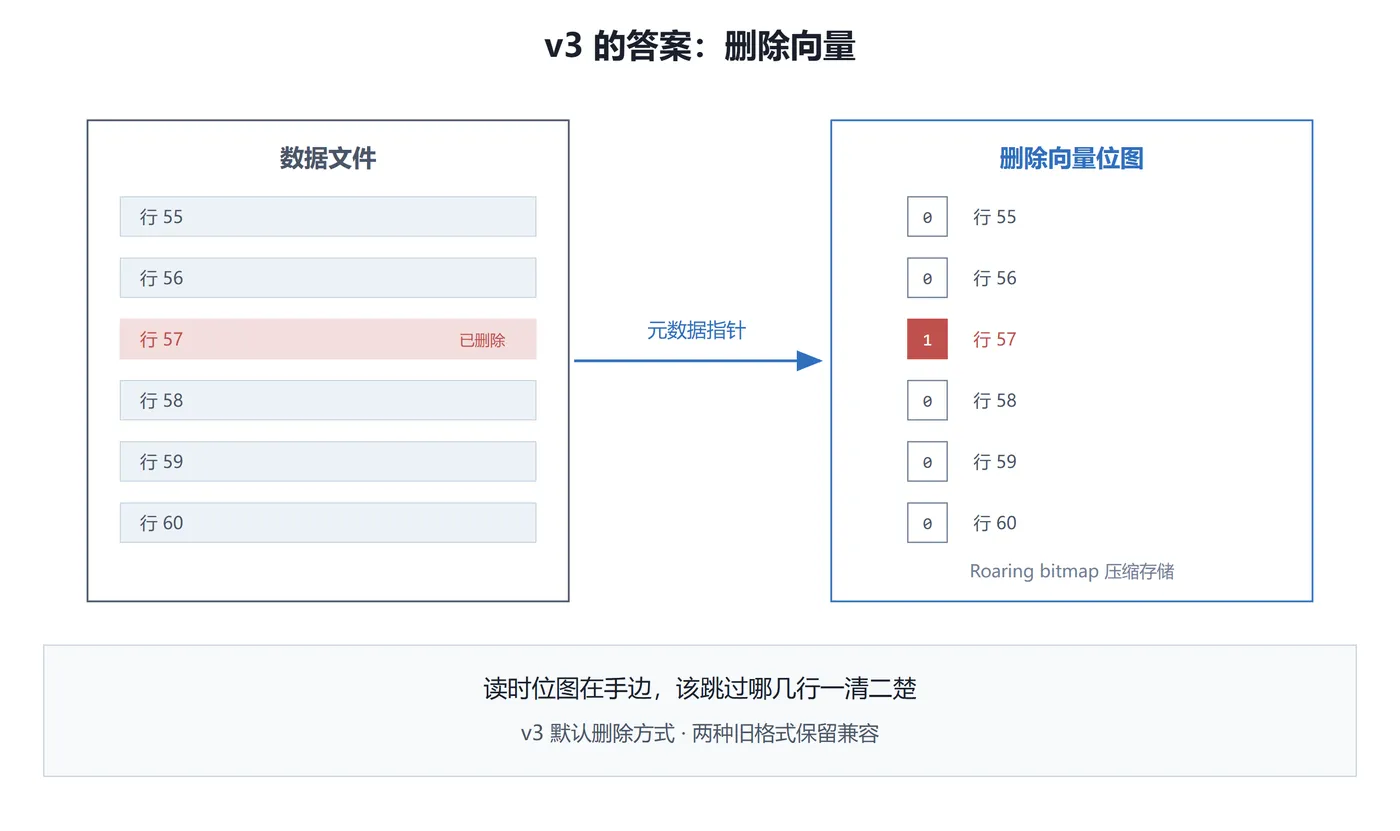
把「哪些行没了」压成一个位图,贴在数据文件自己旁边。
第 57 行没了,位图的第 57 位就标成 1。
位图用 Roaring bitmap 压缩,存成独立的小文件,数据文件的元数据里直接带着指向它的指针。
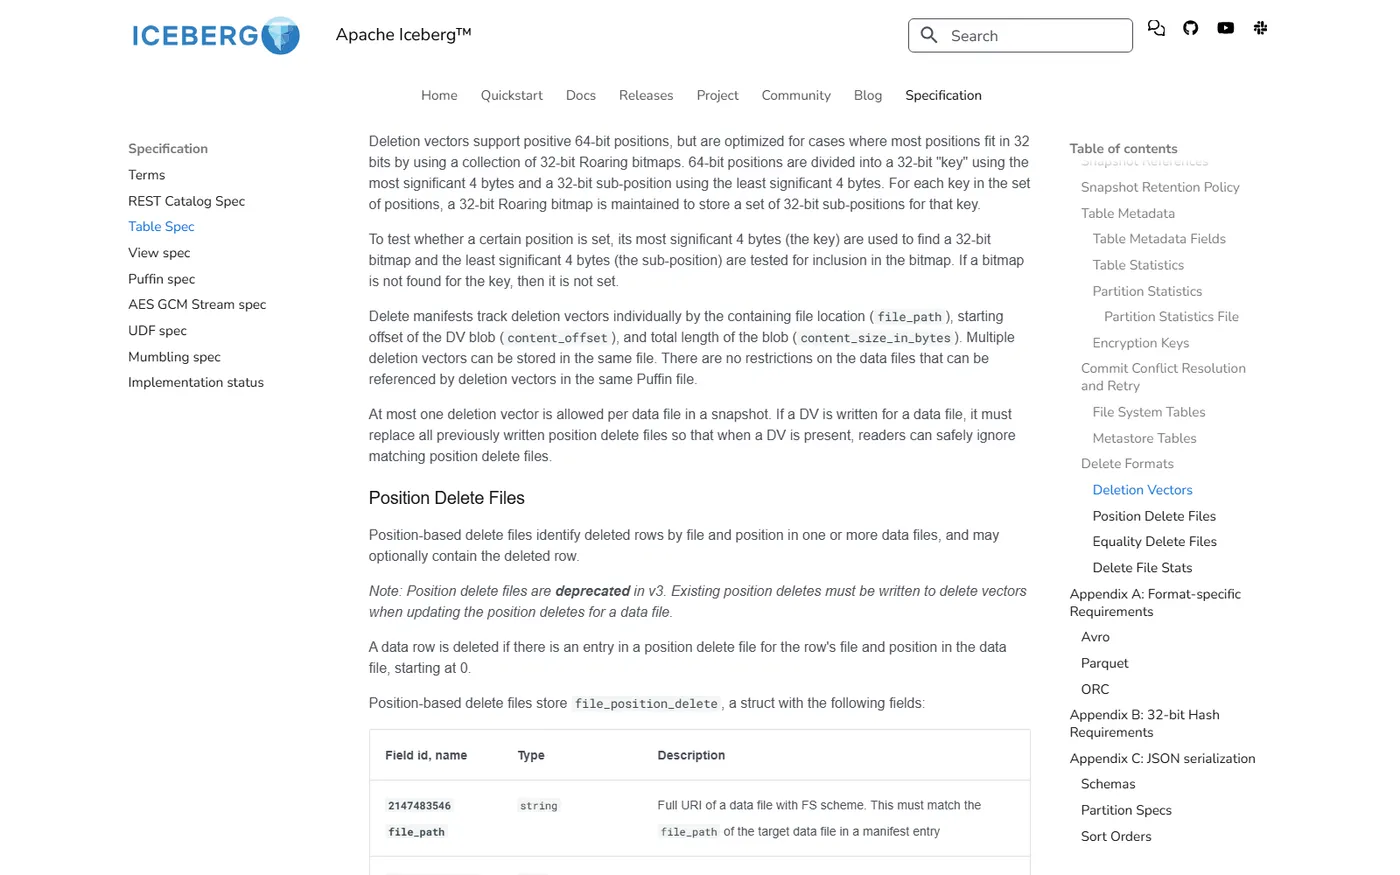
还有个设计点得单独看,位图是按数据文件粒度挂的,一个文件一份,互不合并。
好处是引用关系干净,将来重写某个数据文件时,它对应的位图直接跟着作废,不存在跨文件的对齐问题。
跟 position delete 摆在一起比,好处就显出来了。
position delete 是一批散落在表各处的清单,delete vector 是每个文件自带的一页说明书。
读文件的时候位图就在手边,内存里一查,该跳过哪几行一清二楚。
没有跨文件捞清单的合并风暴,也没有按值过滤的语义负担。
有个细节得单独讲。
位图删除并不是 v3 凭空发明的,2023 年的 Iceberg 1.4.0 就开始以运行时扩展的形态,在 v2 表上支持这种写法。
顺带看一眼隔壁两家,Delta Lake 的删除向量走的同样是位图路线,Paimon 更干脆,把 LSM 树那套写合并机制直接搬进了湖里。
三大家各自交卷,答案出奇地趋同,位图化的删除就是现阶段这个问题的最优解,这一点上竞争者难得地达成了共识。
共识比赢家更有信息量。
谁赢了市场还有得吵,三家一起往位图上靠,说明删除这个问题在工程上已经被打穿,剩下的分歧只是路线和生意。
跑了一年多,生态验过了,v3 才把它收编成正式规范。
这个顺序值得玩味,好规范大多长这样,先让实现去趟路,趟稳了再写进标准,而不是反过来。
更关键的一步棋,是 v3 把 deletion vector 定成了默认的删除方式。
这一句的分量在于收敛。
v2 时代三条删除路径并存,v3 时代收敛成一条推荐路径,老的两种保留兼容,但不再推荐。
新表默认走位图,写入端省心,读取端省心,引擎实现也省心,终于不用把三套语义全背在身上了。
当然也别把位图想成免费午餐。
删除攒多了,位图照样膨胀,攒到一定程度还是要靠合并重写来还账,这事在 v3 里只是被推到了更靠后的位置,没有被消灭。
诚实地说,删除这件事在数据湖里没有终点,只有成本曲线的挪动。
位图让「删」这个动作变便宜之后,那些合并作业的性质也变了,从救火变成了定期保养。
调度策略可以从被动挨打改成主动安排,这是运维面上一个实实在在的松动。
说完删除,把 v3 的其他几件新东西过一遍。
每一件都值得单独立传,这里只讲它各自解决什么问题。
Variant 类型。
往湖里放 AI 数据的人都有个体感,半结构化数据硬拍平成几百列,又丑又浪费。
日志、模型输出、嵌套 JSON 这一堆东西,Variant 让你原样存进湖表,查询的时候再按需取字段。
这是 v3 里明确为 AI 时代准备的部件。
取字段的效率取决于引擎对 Variant 的实现深度,下推做得好的引擎能省掉大半解码开销,这块各家的差距以后会越拉越明显。
纳秒精度时间戳。
v2 的时间戳到微秒为止。
金融行情和高端传感器数据里,微秒不够用。
这个补丁看着小,对某些行业是刚需。
unknown 类型。
表结构演进的保险丝。
上游系统加了新列,下游的老引擎还没升级,新引擎把这个列标成 unknown 先存着,老引擎看到 unknown 直接安全忽略。
整条数据管道不用逼着所有人同步升级,多级管道里这玩意能省掉无数次的协调会议。
row lineage,行级血缘。
每一行数据带上自己的世系信息。
增量消费、CDC 下游追踪这类事,第一次有了规范层的地基,以前靠业务键自己比,现在规范直接给。
还有地理空间类型和默认列值,篇幅关系不展开,spec 原文里都写得很清楚。
接下来是所有人最关心的问题,我这张表要不要升 v3。
这里得先拆一个最容易混的概念,规范版本和实现版本不是一回事。
format-version 是表自己的契约版本,它决定这张表在元数据里允许出现哪些结构。
你平时说的 Iceberg 1.4、1.8,是运行时的实现版本,它决定你手里的工具能读写哪些契约的表。
两套版本号各走各的,一个老运行时配上新契约的表会读不了,一个新运行时看老契约的表则完全没问题。
社区里大量所谓的升级踩坑,一半是把这两套版本号搅在一起谈出来的。
技术上的答案简单得离谱。
建表属性 format-version 从 2 改成 3,就一个开关的事,升级动作发生在元数据层,底下的数据文件一个都不用动。
还有一层语义要心里有数,升级改的只是元数据里的版本声明,已经写进去的数据文件保持原样,新写入的文件才按新规范来。
一张刚升级的 v3 表里,老的 v2 形态数据和新形态数据会共存相当长时间,两套删除机制在同一张表里和平共处。
但这个开关是单向的,规范里写明了格式版本只升不降。
升上去那一刻起,就没有官方退路了。
所以真正的成本不在这一刀,在刀口两边。
写这一侧,Iceberg 新版本的运行时已经陆续支持写 v3 表,deletion vector 的写入在主流引擎里逐步就位。
读这一侧就得认真对待了。
你手上的每一款查询引擎、每一款报表工具,对 v3 新特性的支持是各自排期的。
位图的读取问题不大,Variant 这种新类型,引擎不支持就是读不了。
所以升级前的功课不是学新特性,是把手上每个引擎的 v3 支持矩阵逐个核一遍。
谁支持读,谁支持写,谁只认 v2,列成表再看动不动。
这一步没有捷径。
各家文档的说法和实际行为还可能有出入,关键路径上的引擎,建议拿自己的查询亲自验一遍再下结论。
写这篇之前,我把 Iceberg 官网的 spec 页来回翻了三遍。
v2 那份删除规范越读越像一部补丁史,每一种删除格式都是对上一种的修补,补丁摞补丁,摞出了 v3 的全部动机。
还有个时间差值得看一眼。
v2 是 2021 年,v3 是 2025 年,中间隔了四年。
四年磨一版规范,在这个一切都在赶热点的行业里,慢得近乎固执。
但表格式这个东西的演进逻辑本来就是,底座上跑着全行业的数据,动一次的成本按亿行计,慢就是它的敬业。
有个问题值得说一句。
这么重要的一版规范,中文圈的动静小得跟它的重要性完全不匹配。
我猜原因不复杂,格式规范这类题材门槛高、读起来费劲、离变现又远,愿意啃的人天然就少。
但做湖仓的人躲不开它。
而且越晚看越吃亏,v4 一旦把禁写落地,现在没跟上的团队,到时候是被动换姿势。
你的表格式往哪个方向演进,决定了未来几年每一次查询、每一次写入的底层成本。
最后回应开头那个投票。
v4 打算禁止再写 equality deletes,不少人第一反应是这人真激进。
把账翻完再看,这一步顺理成章。
v3 的 deletion vector 已经把删除的活接过去了,equality deletes 留着只承担历史数据的兼容。
新数据还在往里写它,就是给未来继续埋雷。
规范设计的规律大抵如此。
先允许一切,再用一个版本把正确的事情变成默认,最后才有底气去禁止错误的事情。
v3 做的是第二步,v4 准备做第三步。
落到操作上,不同的人该做的事其实就三句话。
刚开始建湖的,直接从 v3 起步,别再从 v2 起家,新表的默认路径就该是位图。
手上已经有 v2 大表的,先核引擎支持矩阵,再挑业务低峰做元数据升级,升级是单向门,想清楚再拨。
只读不写的,等你的查询引擎把 Variant 支持补齐再说,位图那部分对读端反而是减负。
v3 规范全文在 Iceberg 官网的 spec 页,删除相关的章节在 format-version 3 那一节,配着这篇看正好。
开篇那个投票的原帖就挂在 dev 列表归档里,标题里带 VOTE 和 SPEC 两个词,一搜就能搜到。
祝大家,湖仓愉快。

