
本文基于超兔CRM「周期服务交付台」的真实开发,分享一次领域建模实践:如何把「按月发生、跨期滚动」的 B2B 服务,从为实物设计的订单体系中剥离出来,抽象成一套可筛查、可扩展、多租户通用的模型。模型不是闭门设计——每个方向都与真实客户在实际业务上验证,结合技术方的结构推演。文中包含演进过程、状态机设计、核心代码、多租户设计要点以及 DB 层的一致性方案。
先说结论
经过多轮方案演进,我们最终把周期型服务抽象为三层实体:
- 服务合同(ServiceContract):管理主体,承载法律关系与客户归属;
- 交付计划(DeliveryPlan):合同下的明细,单次交付与周期交付统一建模,可随时追加、续期;
- 交付记录(DeliveryRecord):按月发生的履约事件,是一线唯一需要填写的东西。
而筛查的核心,是一个以「月」为最小颗粒的状态机:每个月,系统对每条交付计划计算 hit / nodate / out / qfull 四种状态,hit 即当月待交付项。整套模型已在超兔CRM两个数据结构完全不同的租户环境中验证通过。
下面展开讲为什么以及怎么做。
一、问题的起点:订单模型的三个隐含假设
我们最初的想法很直接:交付计划不就是合同下的行项目吗?在订单模型上加「分期」字段应该就能管。
真正深入业务才发现,订单模型有三个隐含假设,而服务一条都不满足:
| 维度 | 实物订单 | 周期型服务 |
|---|---|---|
| 交付物 | 有形,可点数、可验收 | 无形,状态和过程本身就是交付物 |
| 履约动作 | 出库 → 发货 → 签收 | 按月发生,没有物流节点 |
| 时间结构 | 一次交割 | 跨期滚动,12 期 / 24 期是常态 |
| 交付边界 | 清晰,订单行即边界 | 模糊,计划可随时新增、续期累加 |
一个典型的企服客户旅程长这样:
核名 → 注册地址 → 工商执照 → 刻章 → 银行开户 → 税务登记
     → 代理记账(12期,按月) → 年度报告 → 汇算清缴 → 变更事项
这里大部分产品是单次交付的,而代账是按月发生的 12 期、24 期。设备维保场景类似:按月巡检 ×12、季度深度保养 ×4、应急响应若干次。它们共同的特征是:一次签约,履约按月滚动。
让客服在服务场景点「发货确认」、让财务在维保合同上等一个永远不存在的签收单——模型与现实的错位随处可见。这也是超兔CRM决定把服务管理从既有订单模型中独立出来的直接原因。
二、方案演进:我们和客户实战测试过四个方向
最终模型不是在会议室里设计出来的。过程中我们与多家真实客户一起,在他们正在进行的业务上逐个方向试跑;每一个方向,客户先用真实数据实战检验,超兔技术方同步做结构层面的逻辑推演——客户负责回答「在业务上成不成立」,技术方负责回答「在模型上可不可持续」。下面是被淘汰的四个方向,记录它们在实战与推演中各自暴露的问题。
方向一:合同 + 12 期交付计划
在一份合同下挂 12 条交付计划,每期一条。这是结构上最接近正解的方向——合同做主体,交付明细挂在合同下,期次各自独立、各有交付日期,也不需要反复签合同。
它被否掉的原因只有一个:信息密度太大。 服务明细随期次线性膨胀,真正有效的信息被埋没在大量同质数据中:12 期、24 期计划摆在一起,内容完全一样、只有期次不同,用户要在一屏屏重复的行里找出「哪个月有异常」。不是不行,而是不爽——当一个系统要求用户从噪声里自己捞信号,管理动作就不会真正发生。其中最典型的场景仍然是漏交付:某个月没有交付记录,列表里只是沉默地少了一行,异常没有任何地方主动暴露。
方向二:用订单管理,多期交付压缩成一个数量
把一项服务的多期交付装进一笔订单,用一个数量字段(如 amount = 12)表达总共 12 次,已交付数量 +1 来滚动。合同总额对得齐,单据也最省,但问题随之而来:期次和交付时间没有数据颗粒支撑。
- 每一期「该在什么时候交付」——没有落点。订单上只有一个数量在变化,「下一期的交付日期」是模糊的;
- 「已发 3 期、剩 9 期」之外,系统回答不了「第 4 期约定的是几月」——时间维度被数量维度吞掉;
- 配套的发货确认、库存扣减更是为实物设计的流程节点,服务无物可出,在服务场景里全部空转。
客户实战中的感受因此是「数字对、进度糊涂」;技术推演确认:这不是体验瑕疵,而是数据模型里缺少时间颗粒,按月筛查、到期预警这些管理动作从根上就无法成立。
方向三:即时通讯群 + 合同备注
这是客户在接触系统前最普遍的现状,我们也陪客户完整跑过一轮实战:十单以内,靠人的记忆勉强维持;二十单以上,进度躺在聊天记录里,月底对账靠翻聊天,新人接手几乎无法还原历史。
技术推演的结论是:信息散落在非结构化介质中,意味着它无法被查询、无法被聚合,也就无法形成任何管理动作——这不是管理方式简陋,而是结构上不成立。
方向四:Excel + 共享文档(兜底方案)
需要说明的是,这并不是一个比前面更先进的方向,而是客户在系统方案走不通时、避而求其次的退路——如果找不到合适的工具,至少用 Excel 把信息结构化记下来。它比方向三稍好的也仅此而已:信息被记录了,却不与合同联动、不与交付记录联动,「到期」无法预警,实际工作中只会在客户投诉时才被动发现欠账。
技术推演指出关键缺口:计划、记录、合同三者没有关联关系,「该交的交了没有」这个问题无法被系统回答,仍然依赖人——工具只承担了记录,却没有承担管理。作为兜底可以维持运转,但它恰恰反衬出:这个领域缺的不是一张更好的表格,而是一个对的模型。
得到的结论
四个方向和客户逐一跑完,得到一个很有意思的共同结论:每条路其实都能走,但没有一条是康庄大道。 方向一结构正确却别扭——重复行淹没信息;方向二单据最省却颗粒模糊——时间维度没有落点;方向三、方向四则是退而求其次的原始方案。都不是不行,但终归是不爽。
而产品演进的动力恰恰来自这个「不爽」:既然凑合的根源是缺少对的载体,那就为服务的多周期管理建立一个专用模型——让一条交付计划同时撑住时间颗粒与数量滚动,让进度被一眼读懂,把「又简单又清晰、很爽」作为明确的设计目标。下面展开这个模型。
三、领域模型:三层实体的设计
最终模型恰好是方向一与方向二的合题:一项服务只建一条交付计划(解决方向一的密度问题——12 条重复行压缩为 1 条,期次进度改由计划上的日期窗口与月历承载),而这条计划同时携带时间窗口与总量(解决方向二的颗粒缺失——date / end_date 让「每一期在什么时候」重新有数据落点,数量滚动则保留订单方案的简洁)。结构如下:
几个关键设计决策:
1. 合同是主体,交付计划是明细。
法律关系、客户归属、框架总额挂在合同上,管理主线永远是合同;单次交付(工商注册)、周期交付(12 期代账)、续期累加(到期再加 12 期)都是合同下的一条计划。客户不想为续期反复签合同——这是服务业的交易常态,模型必须支持「在一个合同下持续往下加明细」。
2. 单次与周期统一建模,靠量条件区分。
不引入「交付类型」字段,而是用统一条件 totalQuantity > deliveredQuantity(总量 > 已交付量)表达「还有没有要交的」:
- 月度形态:
totalQuantity > 1,每品每月一条,交满为止; - 单次形态:
totalQuantity = 1,交一条即止,不做月度唯一性约束。
3. 交付记录是唯一的一线输入。
一线只需要回答「这个月干了没有」,不涉及合同变更。记录归属到月份,驱动所有进度展示。
四、核心:月度筛查状态机
筛查分两步:先筛合同,再筛合同下的交付计划。
第一步:合同过滤
合同层的过滤条件直接下推到数据查询(以下为条件语义的伪代码表达):
contractType   = {按月交付对应的动态枚举索引}
documentType   = 0              // 仅合同,不含订单
contractStatus = 1              // 仅执行中
approvalStatus IN (0, 2)        // 未开启审批的全读;开启审批的只读已通过
approvalStatus 的设计值得一提:它让同一套查询同时兼容两类租户——未开启审批时,所有合同审批状态为 0 全部命中;开启审批后,只有审批通过(2)的合同才进筛查,审批中(1)与驳回(3)自动排除。
第二步:交付计划状态机
对命中合同的每一条交付计划,按当月计算四种状态:
function planStatus(plan, viewMonth) {

  // 日期未填:存量数据的常见形态
  if (!plan.plannedStartDate || !plan.plannedEndDate) return 'nodate';

  var monthStart = viewMonth + '-01';
  var monthEnd   = viewMonth + '-' + pad2(daysInMonth(viewMonth));

  // 条件1:日期区间与当月有交集(不是简单的"包含当月")
  if (!(plan.plannedStartDate <= monthEnd && plan.plannedEndDate >= monthStart)) return 'out';

  // 条件2:统一量条件,交满即止
  if (!(+plan.totalQuantity > +plan.deliveredQuantity)) return 'qfull';

  return 'hit';
}
完整的筛查逻辑:
function getHits(viewMonth) {

  var hits = [];
  state.contracts.forEach(function (contract) {

    (state.plansByContractId[String(contract.contractId)] || []).forEach(function (plan) {

      if (planStatus(plan, viewMonth) !== 'hit') return;
      // 条件3:当月不能已有交付记录(月度唯一性)
      if (recordsOf(contract, plan).some(r => r.serviceMonth === viewMonth)) return;
      hits.push({
    contract: contract, plan: plan });
    });
  });
  return hits;
}
状态机的语义:
| 状态 | 含义 | 业务呈现 |
|---|---|---|
hit |
日期覆盖当月、未交满、当月无记录 | 进入「未交付」列表 |
nodate |
plannedStartDate / plannedEndDate 缺失 | 流水线留痕「日期未填 N」 |
out |
日期区间与当月无交集 | 留痕「不在服务期 N」 |
qfull |
totalQuantity = deliveredQuantity,已交满 | 留痕「量已交满 N」 |
这里有一个容易写错的点:日期判定是「交集」而不是「包含」。 正确条件是 plannedStartDate ≤ 当月最后一天 AND plannedEndDate ≥ 当月第一天。如果写成「当月在区间内」的直觉版本,会在跨月边界(比如计划从 10 月 31 日开始)上算错。
为什么需要显式的排除留痕
「没出现在列表里」必须对应一个确定的排除原因。流水线的每一步都输出构成计数:
① 本月需交付合约 —— N 份合同命中
② 合同下交付计划 —— M 条待闭环
   X 份合同 · 日期未填 a · 不在服务期 b · 量已交满 c · 当月已交付 d
方向一中那个「沉默的缺失」,在这套模型里第一次变得可观测。
五、最小颗粒为什么是「月」
这个结论经过穷举排除,而非拍脑袋:
| 候选颗粒 | 排除理由 |
|---|---|
| 年 | 「交付到哪了」要等年底才知道,中间完全失控 |
| 季 | 季度场景真实存在但占少数,按季管会让主流场景失真 |
| 月 | 计费口径、客户感知、信息密度三者同时最优 |
| 次 | 应急维修无法预排,在月度计划里记一次即可 |
选月的三个理由:
- 月是 B2B 服务的计费与对账口径——代账按月收、维保按月摊、驻场按月结,管理颗粒与财务结账天然对齐;
- 月是客户感知的节拍——「这个月巡检做了没有」是客户真正常问的问题;
- 密度刚好——12 个刻度,既密到能及时暴露问题,又疏到一行放得下、一眼读完。
季度服务怎么办?照样管:计划横跨多月,格子多亮几个月即可。我们刻意没有把三个月合并成一格——合并后单次交付无处安放、季度与月度的行无法横向比较。不为小概率形态牺牲大概率场景的可读性,是这里最重要的取舍。
同时模型容纳不完美执行:提前验收、月底补录、两月并做都是常态,所以「服务月」与「实际交付日」分开记录——工具适应现实,而不是要求一线把现实掰成工具的形状。
六、多租户 SaaS 设计:枚举必须动态处理
多租户系统里,数据字典(枚举)属于租户级配置,这是设计阶段就要明确的前提。合同分类 contractType 正是这类字段:每个租户可以按自己的业务配置分类项,「按月交付」在不同租户中的存储索引天然不同。
应注意避免的问题
1. 不要在代码里写死枚举索引。
同一个业务含义,在不同租户中对应不同的存储值,例如:
| 租户 | 「按月交付」的存储索引 |
|---|---|
| 租户 A | 6 |
| 租户 B | 23 |
写死任何一个值,都只会在单租户下成立。正确做法是把业务含义(「按月交付」这个显示值)作为代码中的常量,把存储索引当作运行期数据。
2. 不要在查询条件中使用枚举显示值。
查询条件中的枚举必须使用存储索引。超兔CRM在处理条件表达式时,对枚举显示值不会报类型错误,而是按默认索引处理——一旦误用,查询不会失败,却会静默返回错误的数据集,这种问题在测试中很容易被漏掉。
3. 不要把接口文档中的枚举显示顺序当作存储索引。
接口元数据返回的 valuerange 描述的是显示顺序,存储索引是独立的值,两者没有可靠的下标对应关系。枚举的真实取值以数据字典接口的运行期返回为准。
设计方案:查询前做动态 KV 翻译
数据字典查询接口(本文以 loadDictionary 代称)返回当前租户的键值对。筛查前先把业务含义翻译成存储索引,会话内缓存:
function resolveContractTypeIndex() {

  if (state.contractTypeIndex) return Promise.resolve(state.contractTypeIndex);
  return api.loadDictionary('ServiceContract', 'contractType').then(function (kv) {

    var hit = kv.find(r => r.value === '按月交付');
    if (!hit) throw new Error('当前租户未配置「按月交付」合同分类,无法筛查');
    state.contractTypeIndex = String(hit.key);   // 运行期取得,可能是 6,也可能是 23
    return state.contractTypeIndex;
  });
}
翻译完成后再拼查询条件:contractType = {翻译出的索引} AND documentType = 0 ...。翻译逻辑收敛在模型一层,所有租户共享同一套代码——租户差异通过运行期参数消化,而不是通过代码分叉消化。
七、一致性下沉:DB 层对筛查模型的支撑
状态机的四个状态完全由数据推导,因此数据本身的一致性是整个模型成立的前提。超兔CRM在设计上刻意不让应用层去维护交付状态,而是把两条关键的联动规则放在 DB 层(数据库触发器 + 写入事务内的服务端逻辑)实现,使上层永远读到自洽的数据。
机制一:交付记录写入时,已交付数量在同一事务内累加。
插入一条交付记录时,DeliveryPlan.deliveredQuantity 由 DB 层在同一事务内 +1。这样设计的考量是:
- 如果让应用层「先插记录、再更新计划」分两步走,就引入了双写一致性问题——第二步失败会留下「有记录、数量没变」的脏数据;
- 联动收敛在 DB 层后,
totalQuantity = deliveredQuantity成为可靠的判定条件,状态机的qfull状态不需要任何额外的状态字段; - 应用层不需要「创建记录后再把计划置为已交付」这类补偿操作,写入路径只有一条。
机制二:量交满后,计划日期窗口由 DB 层收敛。
当累加导致 deliveredQuantity = totalQuantity 时,DB 层同步把该计划的日期窗口刷新为交付月的月初/月末。这条规则服务于状态机的 out 判定:交满的计划不应再出现在后续月份的筛查结果中,而日期收敛让它在数据层自然出局,不依赖应用层记忆或额外的关闭标记。
两条机制合在一起,把「交付状态管理」从双向同步问题变成了只读推导问题:
写入侧(DB 层,事务内)          读取侧(应用层,无状态)
─────────────────────          ─────────────────────
插入交付记录          ──┐
已交付数量 +1          ├─ 同事务   读取计划与记录
日期窗口收敛          ──┘          按状态机推导四种状态
                                          ↓
                                   前端 = 数据的投影
这是设计上的明确取舍:状态只保留一个权威来源(DB 层数据),应用层不持有任何会漂移的状态副本。 上层代码因此可以无状态地重跑、重渲染,而不必担心与底层失同步。
归月口径的设计点
计划支持提前交付,而提前交付时「实际交付日期」与「服务月份」并不重合:9 月里为 10 月提前交付,记录的日期是今天,归属却是 10 月。因此归月的主键不能是交付日期,必须是记录中携带的服务月标识(解析不到时再回退到交付日期):
deliveryRecords.forEach(function (record) {

  var plan = state.planById[String(record.planId)];
  if (!plan) return;
  var matched = /服务月 (\d{4}-\d{2})/.exec(record.remark || '');
  addRecord(plan.contractId, plan.planId,
    matched ? matched[1] : monthOf(record.deliveredDate),  // 优先按服务月,退回交付日期
    record.deliveredDate);
});
八、交互落地:把状态机压缩成一条微缩月历
模型再好,一线看不懂也是零。交互上我们淘汰了进度条表格(太沉)、看板(找不到「这个月」)、甘特图(学习成本高),最终方案是:每行一条迷你月历 + 一个「已交付/总量」计数。
实现上就是一个 12 列 CSS Grid:
.miniCalendar {
    display: grid; grid-template-columns: repeat(12, 1fr); gap: 6px; }
.calendarCell {
    aspect-ratio: 1; border-radius: 4px; background: #e7e2d5; }
.calendarCell.delivered {
    background: #1a73e8; }             /* 已交付月份 */
.calendarCell.current   {
    box-shadow: 0 0 0 2px #e0701a; }   /* 当前查看月 */
两种交付节奏在视觉上自然分化:
年度代账(13期)  已交付 7/13
■ ■ ■ ■ ■ ■ ■ ▣ □ □ □ □ □      连续亮格 = 按月交付

季度深度保养    已交付 2/4
■ □ □ ■ □ □ ▣ □ □ □ □ □         亮一空二 = 按季交付,频率无需换算
选月历做载体基于三个判断:形状即语义(格子亮暗人人认识,零学习成本)、疏密即频率(交付节奏从排布直接读出)、密度可控(一行只回答「进度」和「当月状态」)。对工具类产品,理解门槛直接决定采用率。
「终于爽了」:操作本身成为正反馈
回到第二章那个「不爽」——在真实客户的使用中,这个界面带来的感受是相反的:
- 打开页面,这个月要交什么、交到哪了,一眼看清,不需要翻、不需要问;
- 完成一次交付,只填一条记录,提交后格子立刻亮起、计数即时 +1——操作和结果之间没有任何延迟与猜测;
- 切到未来月提前交付、补录历史月份,系统照常承接,不卡流程、不要求重签合同;
- 交满的计划自然淡出,不用手工关闭,也不会再有提醒打扰。
每一次点击都对应一个确定、即时、可见的结果。管理动作不再是负担,而变成一种轻量的、带正反馈的日常操作。 第二章里「每条路都能走、但都不爽」的憋屈,在这里被「简单、清晰、顺手」彻底替代——这正是专用模型存在的意义:不是功能更多,而是让用户每次操作都有愉悦的心情。
九、工程思考:为什么执着于模型,而不是按客单定制
最后回答一个常被问到的问题:每个客户需求都不同,按客单定制不是更省事吗?
短期确实省事,但客单定制意味着每个客户都是一座孤岛:需求改一次、代码改一遍,经验无法复用,成本随客户数线性增长。超兔CRM选择模型化路线,成本结构是「一次建模投入,边际成本快速收敛」: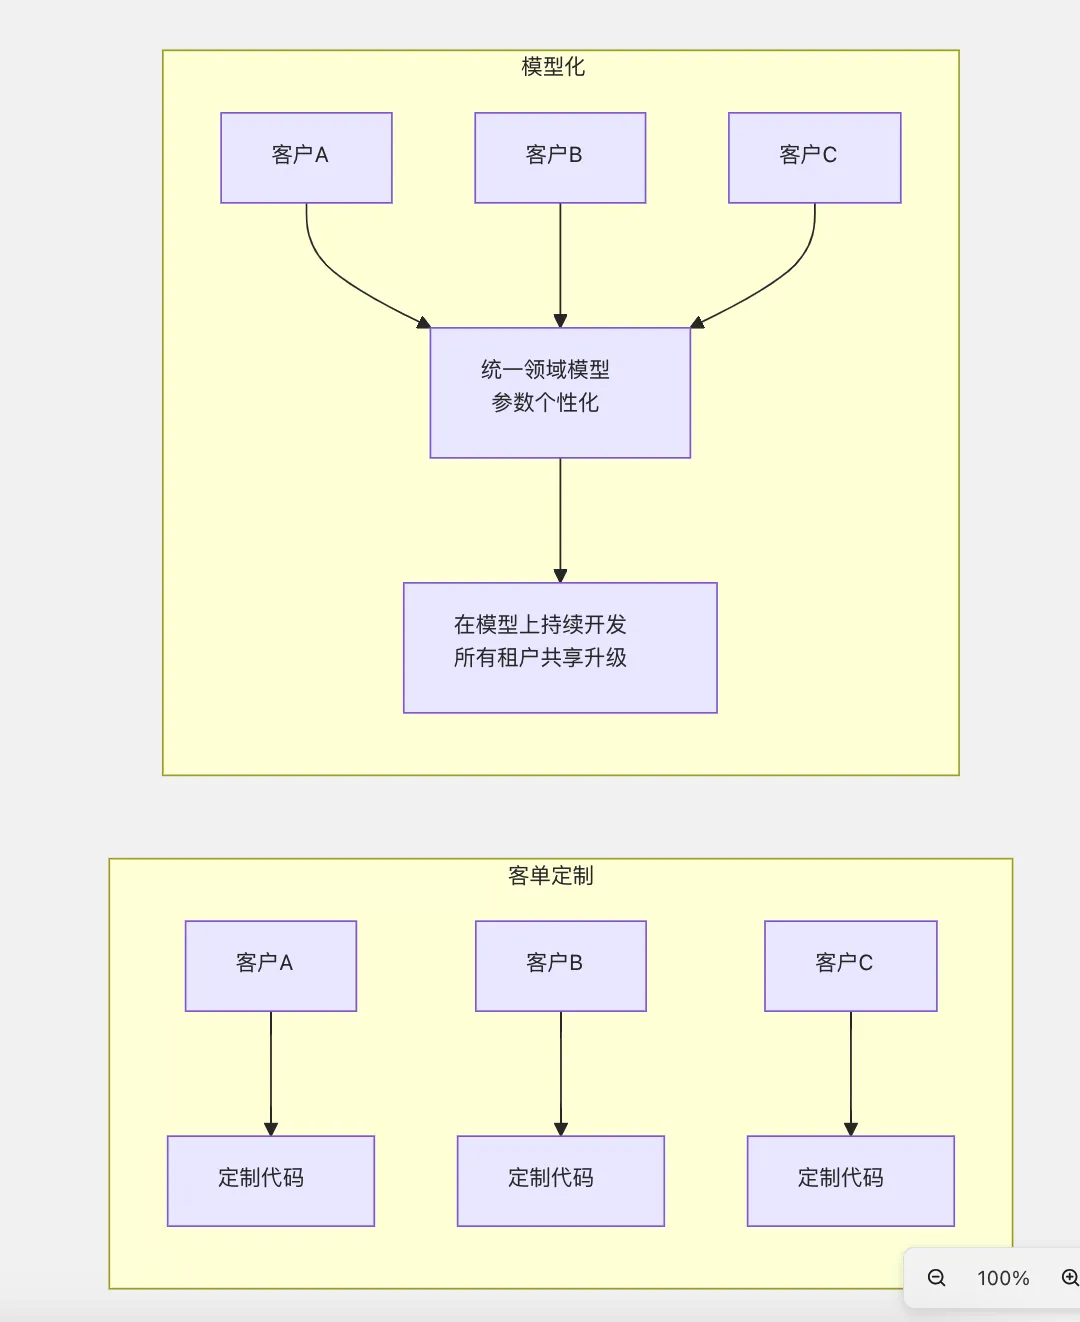
模型化的两个核心优势:
- 增长性:月度、季度、单次、续期都只是模型参数的变化,不需要重构;模型调整后所有租户共享升级;
- 成本收敛:业务 know-how 沉淀进模型而不是散落在各客户分支里,厂商的边际开发成本持续降低。
它本质上解决的是一个根本冲突:企业需要个性化服务,却付不起纯定制的高成本。 答案是「骨架标准化,参数个性化」——把管理逻辑抽象为实体对象(服务合同 / 交付计划 / 交付记录)和它们的关系。这与当下流行的「本体论」思路殊途同归:本质都是抽象、归纳、合并。
十、写在最后
复盘整个过程,正确的次序是:
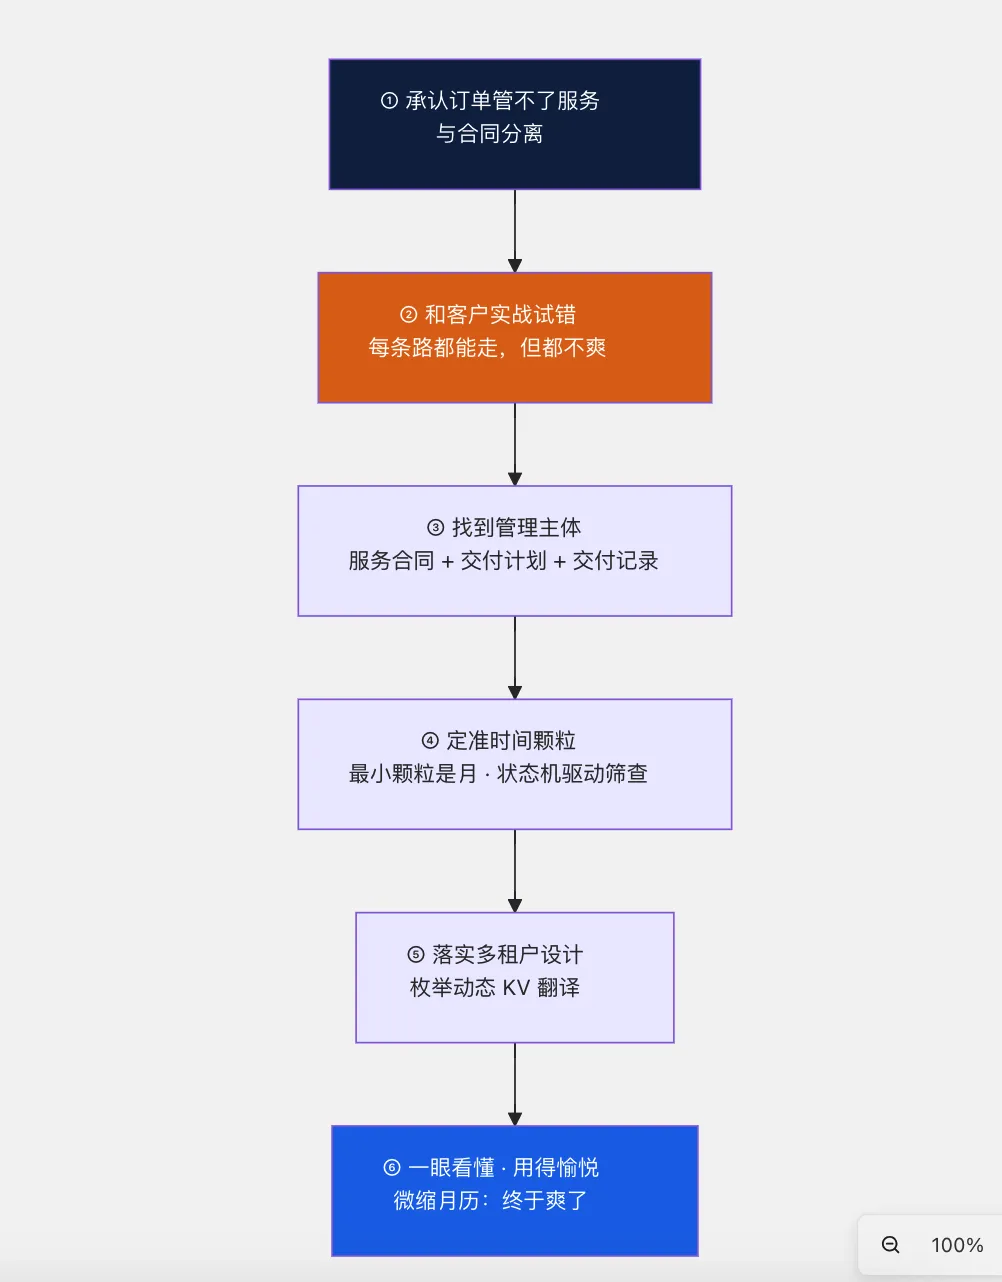
首尾三个节点刻意着色:深蓝(问题起点)→ 橙色(不爽的试错)→ 亮蓝(爽的终点),与本文「从憋屈到愉悦」的主线一致。
每一步都不神秘,但每一步都要对抗「用现成体系凑合」的惯性——无论是客户侧沿用旧习惯,还是技术侧沿用旧模型。B2B 的服务化是明确的趋势:设备商在变成服务商,制造商在长出订阅类业务,履约按月发生——当交付按月发生,工具就该按月思考。
而对工程而言,这个项目最大的启发是:好的模型不是功能更多,而是让「状态只有一个权威来源、差异只通过参数表达、缺失永远可观测」成为系统的默认性质。 落到用户身上,则是更朴素的一件事——从「每条路都别扭」到「每次操作都愉悦」。这个「爽」,就是模型价值最直接的证据。
欢迎在评论区交流:你们的业务里,周期型服务是怎么管的?

