
阿里云 ChatOps Agent 让非标准化环境可修复:内核漏洞换盘后的容器恢复
本文分享我们使用 阿里云 ChatOps Agent 修复 Linux 内核漏洞的真实实践:面对非标准化的服务器环境,我们在替换 ECS 系统盘后借助 Agent 的"参照物 diff"能力,把未知配置差异自动找出来,让容器服务快速恢复。
背景:安全工单来了,服务器却没"标准答案"
我们收到安全团队下发的漏洞修复工单:线上 ECS 实例存在 Linux 内核本地提权漏洞风险,需要尽快完成修复。这类漏洞的特点是普通本地用户可能借此获得 root 权限,甚至触发容器逃逸,因此留给运维窗口的时间通常很短。
但打开实例列表后,我们发现这套业务系统的交付历史非常"丰富":有些实例是标准镜像一键交付的,有些则经过多年手工调优;有的 Docker 数据目录在 /var/lib/docker,有的迁移到了 /home/data/docker;有的内核跟随系统默认更新,有的则锁定了特定版本。更要命的是,很多关键配置并没有沉淀到交付文档里——我们其实并不清楚每台服务器上到底做了哪些改动。
在这种非标准化环境下,"一刀切"的修复方案风险很高:直接升级内核可能遇到驱动不兼容,直接换镜像又可能丢失隐性配置。下图展示了面对内核漏洞时常见的三种修复路径,以及各自适用的前提条件:
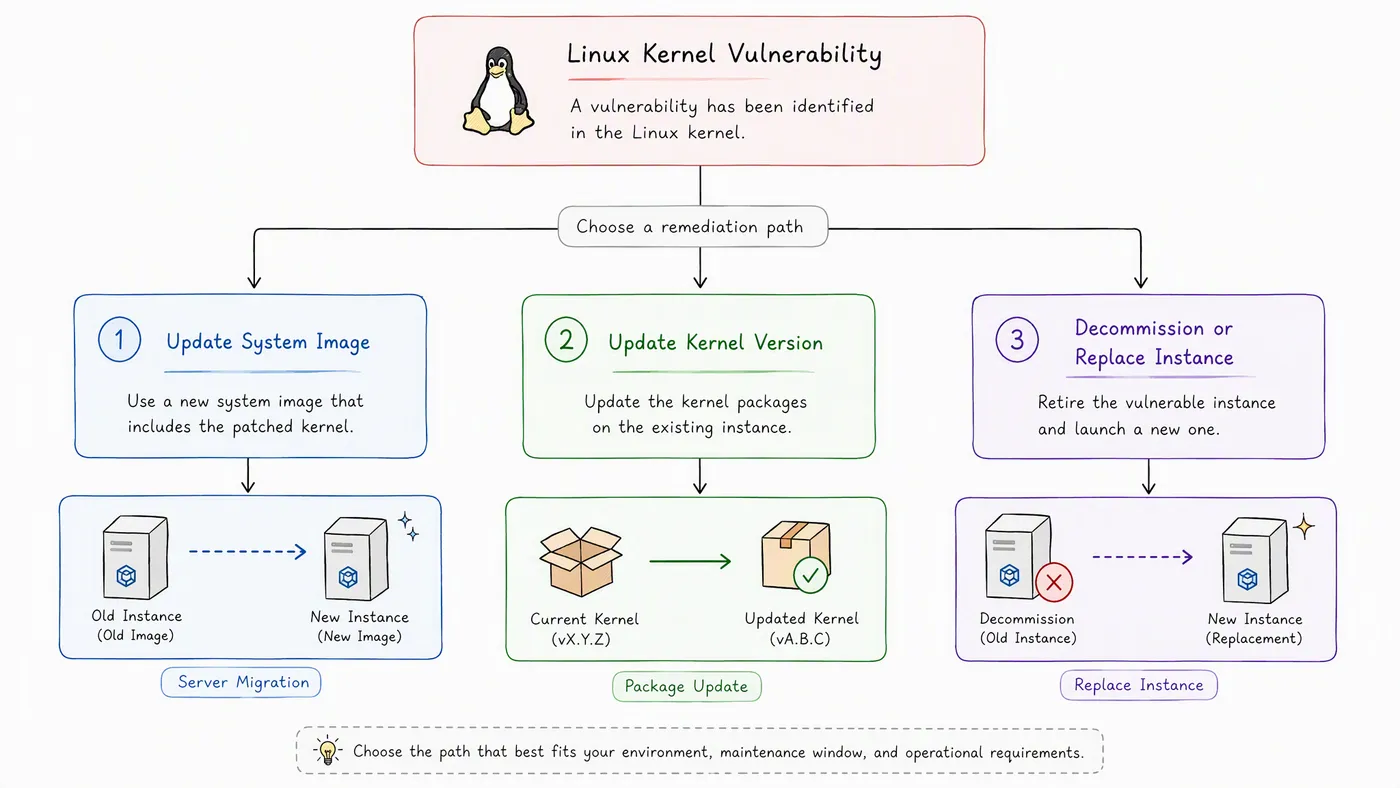
关键要点(结合上图逐项对照):
- 更新系统镜像:将实例重新部署到已包含安全补丁的最新镜像。优点是修复彻底、环境干净;缺点是需要迁移业务数据、协调停机窗口,对核心服务影响大。
- 更新内核版本:通过
yum update kernel升级内核并重启。优点是改动范围小、恢复快;缺点是部分老旧实例可能与新内核驱动不兼容,重启后存在启动风险。 - 服务下线/替换:对无业务运行的实例直接释放或替换。优点是彻底消除风险;缺点是需要事先完成业务迁移,不能用于承载在线流量的机器。
在我们的场景中,业务系统部署在多台 ECS 上,部分实例因历史原因未做标准化交付。为快速消除风险,我们选择对一台非核心业务的实例直接更换系统盘,采用"更新系统镜像"的方案完成修复。
系统盘更换后,漏洞风险确实消除了,但新的问题随之而来:业务容器无法启动。由于之前的配置没有文档记录,我们既不知道原服务器上做了哪些改动,也不清楚新系统与正常实例之间到底差在哪里。传统做法是 SSH 登录后凭经验逐项排查,但面对这种"非标准化 + 配置未知"的场景,效率低且容易误操作。于是我们让 阿里云 ChatOps Agent 介入,通过"找参照物、做 diff"的方式,把配置差异自动找出来,再基于差异完成恢复。
ChatOps 实践经验:使用 阿里云 ChatOps Agent 处理内核漏洞修复时,关键是把 Agent 定位为"对比诊断 + 方案生成"的助手。对于非标准化实例,先让 Agent 找参照物、做 diff,比直接让人凭经验排查更可控;同时要为高风险操作保留人工确认环节,避免自动化越界。
问题:系统盘替换后,容器为什么起不来
系统盘更换完成后,实例本身成功启动,操作系统也能正常登录。但运行业务的容器却无法拉起,报错信息类似于:
failed to register layer: symlink ... no such file or directory
这台实例早期由不同运维人员手工维护,没有完整的交付文档。Docker 数据目录、镜像存储路径、容器启动方式等关键信息并不清晰。面对这种情况,传统排查路径通常是:SSH 登录实例,逐条执行 docker info、docker version、df -h、ls /var/lib/docker,凭经验猜测根因,再逐项尝试修复。
这种"经验驱动"的方式在单一实例上还能勉强应付,但如果漏洞涉及几十上百台实例,效率和风险都将不可控。更重要的是,系统盘替换这个操作改变了实例的底层环境,很多原本"能用"的隐性配置在新系统下不再成立。
下图展示了系统盘替换后,原本正常的容器启动链路是如何断裂的:
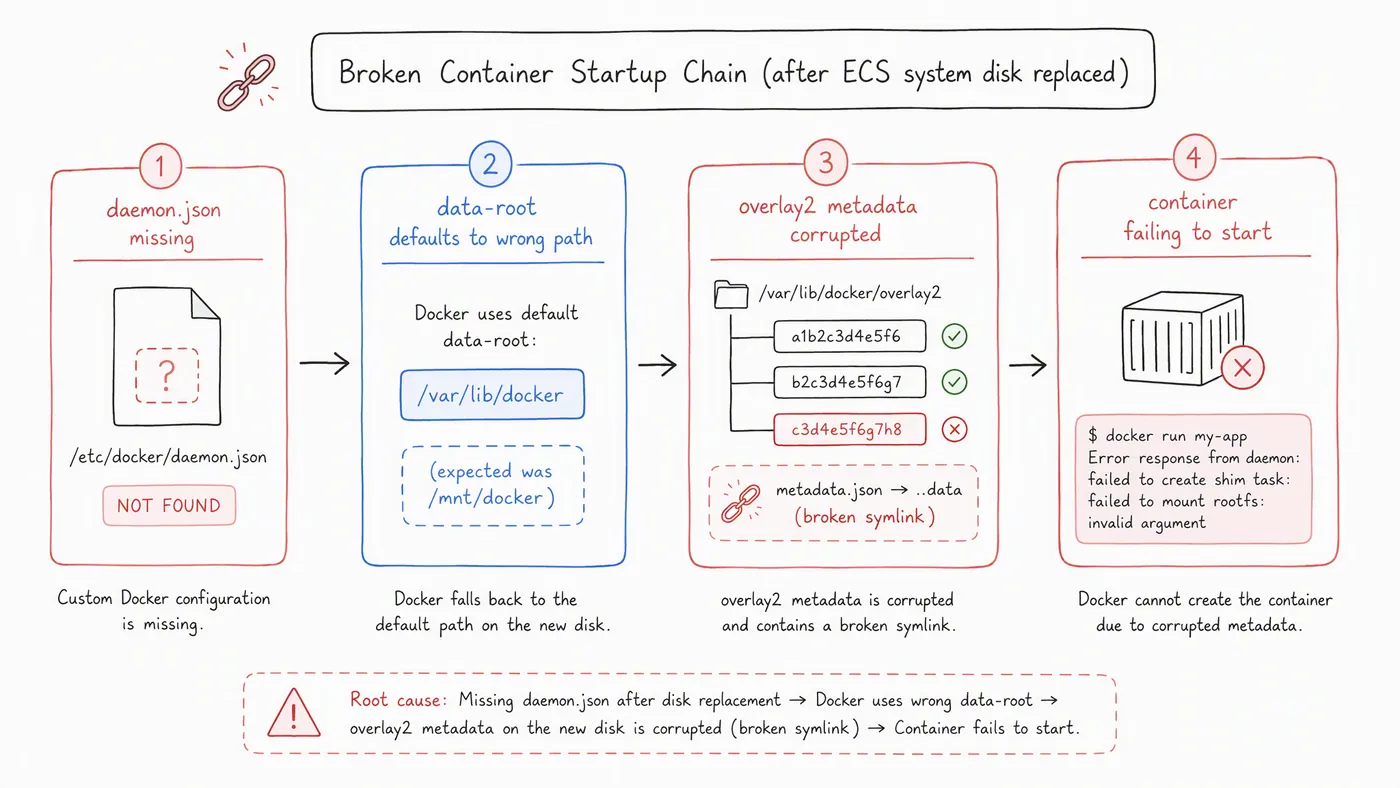
关键要点(结合上图逐项对照):
- daemon.json 丢失:原系统的
/etc/docker/daemon.json未随系统盘迁移,新系统使用 Docker 默认配置,导致data-root等关键参数回到默认值。 - 数据目录不一致:原系统可能将 Docker 数据放在
/home/data/docker或自定义路径,新系统默认使用/var/lib/docker,而旧数据目录中的 overlay2 元数据无法被正确识别。 - overlay2 元数据损坏:
failed to register layer错误的本质是 overlay2 存储驱动在注册镜像层时,发现符号链接或目录结构不完整,无法重建层关系。 - 业务感知滞后:容器启动失败只是表象,真正的问题是底层存储配置与业务期望不一致,而业务层无法自动适配这种变化。
易踩坑点:遇到 failed to register layer 时,常见误操作是盲目删除 /var/lib/docker 并重新安装 Docker。这可能会丢失本地镜像和容器状态,甚至影响关联的卷数据。正确的做法是先定位配置差异,再决定是修复配置还是重建数据。
解法:让 阿里云 ChatOps Agent 用"参照物 diff"替代凭空猜测
我们选择让 阿里云 ChatOps Agent 介入。核心思路是:不凭空猜测,而是找一台同角色、未做变更的正常实例作为参照物,让 Agent 自动对比两台实例的差异。
1. 确定参照物
在 阿里云 ChatOps Agent 中输入:
"帮我找出与这台实例同地域、同标签组且运行正常的 ECS 实例,作为参照物。"
Agent 调用资源查询工具,按标签和运行状态筛选出候选实例。选择参照物的关键在于"同角色":相同应用分组、相似负载、相同镜像基线。只有参照物足够相似,差异对比才有意义。
2. 对比关键配置
将异常实例和参照实例的关键信息交给 阿里云 ChatOps Agent:
"对比这两台实例的 Docker 配置:daemon.json、data-root、docker version、systemctl status docker、/home/data/docker 和 /var/lib/docker 目录差异。"
阿里云 ChatOps Agent 自动执行远程诊断命令,输出对比结果:
| 检查项 | 异常实例 | 参照实例 |
|---|---|---|
| Docker 版本 | 一致 | 一致 |
| daemon.json | 缺失 | 指定 data-root: /var/lib/docker |
| /var/lib/docker | 为空/损坏 | 正常 |
| /home/data/docker | 残留旧数据 | 不存在 |
| overlay2 元数据 | 符号链接断裂 | 完整 |
下图直观展示了"参照物 diff"方法的核心逻辑:通过并排对比异常实例与正常实例的关键配置,快速锁定差异点:
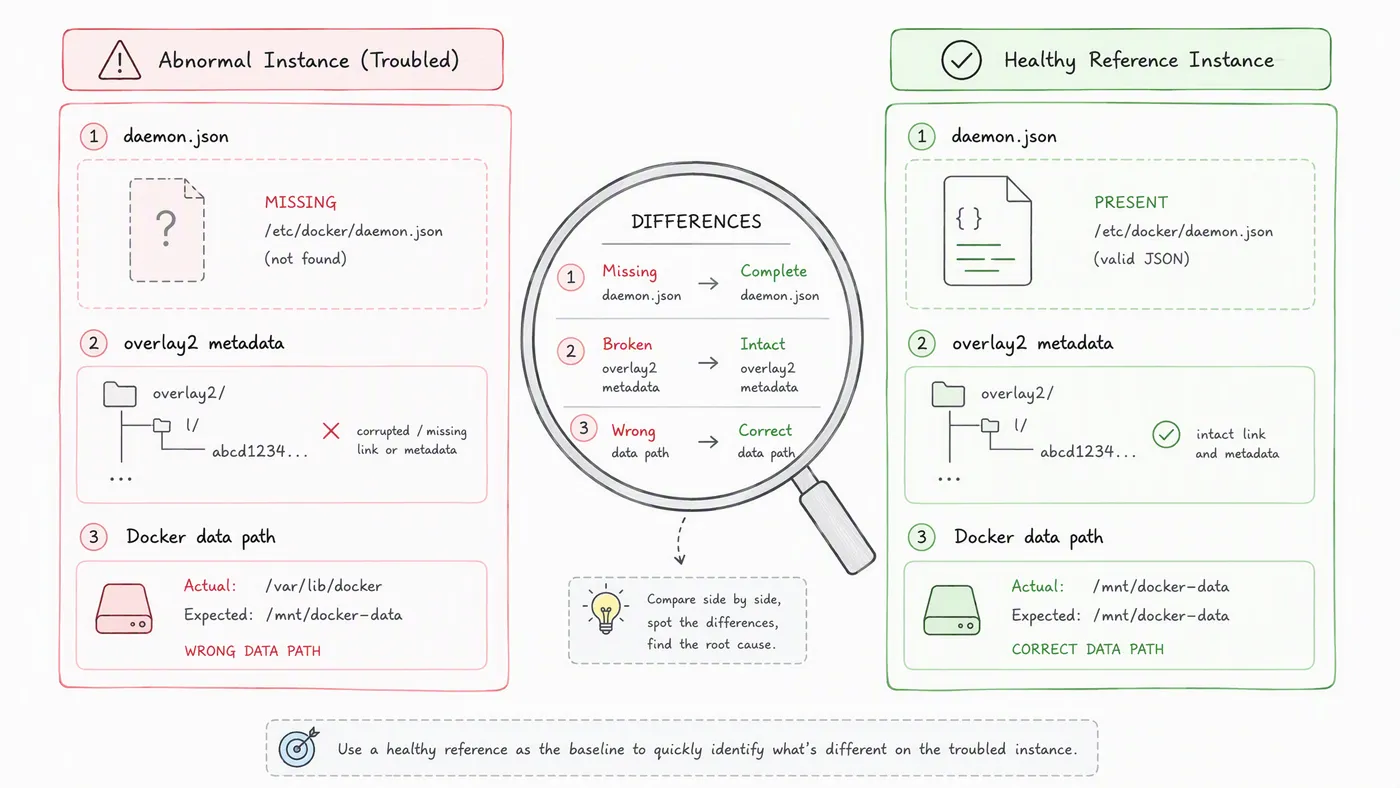
关键要点(结合上图逐项对照):
- 左侧异常实例:缺少
daemon.json,/var/lib/docker目录损坏或为空,/home/data/docker残留旧数据且未被正确引用,overlay2 元数据符号链接断裂。 - 右侧参照实例:
daemon.json明确指定data-root: /var/lib/docker,目录结构完整,overlay2 元数据可正常解析。 - 中间对比维度:Agent 不是简单比较文件存在性,而是同时检查配置项、目录结构、元数据完整性和服务状态,形成多维差异矩阵。
- 根因收敛:当多个差异指向同一配置项时(如
daemon.json缺失导致数据目录混乱),Agent 可以高置信度地定位根因。
关键技巧:选择参照物时,优先选择最近没有变更、业务运行正常的实例。如果同角色实例都已变更,可以退而求其次选择镜像基线相近的实例,但需要在对比时排除已知差异项。
3. 根因定位
阿里云 ChatOps Agent 结合报错日志和对比结果,给出根因:
系统盘更换后,新系统未继承原
/etc/docker/daemon.json配置,Docker 默认使用了不完整/损坏的数据目录,导致 overlay2 存储驱动的层注册失败。
这个结论的可靠性来自于"差异即证据":不是 Agent 凭空推断,而是两台实例的对比结果直接指向了配置缺失。对于非标准化环境,这种基于对比的推理方式比基于经验的猜测更加稳健。
修复:生成并执行恢复计划
根因明确后,阿里云 ChatOps Agent 自动创建修复计划,将恢复过程拆解为可跟踪的子任务:
- 停止 Docker 服务,避免数据损坏扩大。
- 清理不一致的 Docker 数据目录,移除损坏的 overlay2 元数据。
- 重新写入
/etc/docker/daemon.json,对齐参照实例的data-root配置。 - 重启 Docker 服务。
- 重新拉取镜像并启动容器。
- 验证容器状态和业务可用性。
下图展示了这六步恢复流程的完整闭环,每一步都有明确的进入条件和退出标准:
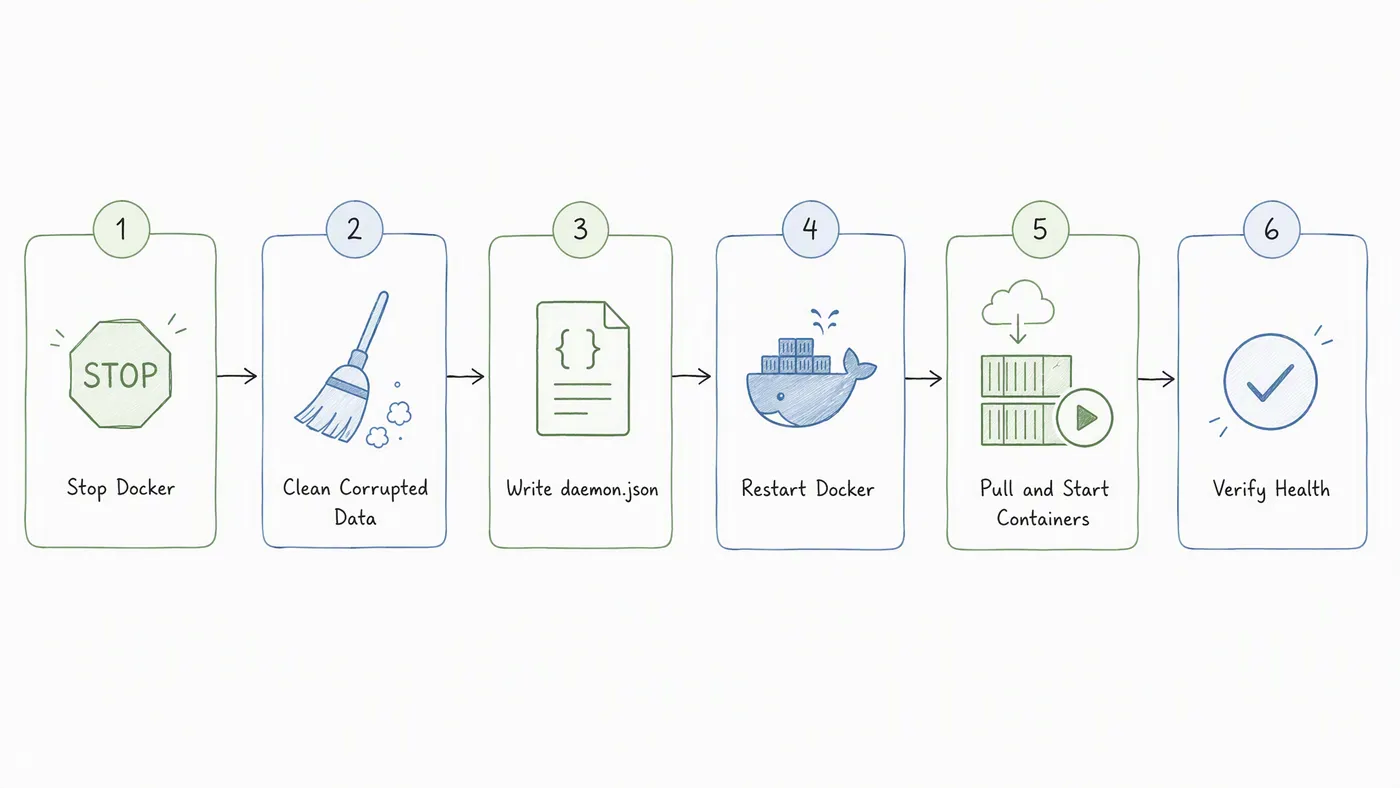
关键要点(结合上图逐项对照):
- Step 1 Stop Docker:使用
systemctl stop docker或service docker stop,确保后续清理不会破坏运行中的容器状态。 - Step 2 Clean Data:根据对比结果,选择性清理不一致目录。在本例中,重点是移除
/var/lib/docker中损坏的 overlay2 元数据,同时保留或归档/home/data/docker中的旧数据以备审计。 - Step 3 Write daemon.json:写入与参照实例一致的配置,例如
{ "data-root": "/var/lib/docker", "storage-driver": "overlay2" }。 - Step 4 Restart Docker:使用
systemctl start docker启动,检查docker info确认Server Version、Storage Driver、Docker Root Dir与预期一致。 - Step 5 Pull & Start:重新拉取业务镜像并启动容器。如果业务使用
docker-compose,在此步骤执行docker-compose up -d。 - Step 6 Verify:通过
docker ps、curl健康检查接口、查看业务日志等方式确认恢复成功。
# 停止 Docker
systemctl stop docker

# 清理损坏的 overlay2 元数据(示例,实际操作需谨慎)
rm -rf /var/lib/docker/overlay2

# 写入 daemon.json
cat > /etc/docker/daemon.json <<'EOFDOCKER'
{
  "data-root": "/var/lib/docker",
  "storage-driver": "overlay2"
}
EOFDOCKER

# 重启 Docker
systemctl start docker

# 验证配置
docker info | grep -E "Storage Driver|Docker Root Dir"
每一步的状态都在 阿里云 ChatOps Agent 会话中持续跟踪,用户可以随时查看进度、中断或调整计划。这种人机协同的方式既保证了自动化效率,又保留了人工干预的安全边界。
ChatOps 实践经验:让 Agent 执行恢复计划时,建议把操作按风险分级——删除数据目录、重启 Docker、重写配置等高风险步骤必须人工确认,查询状态、收集信息、生成对比报告等低风险步骤由 Agent 自动完成。这样既享受了自动化效率,又守住了安全边界。
经验总结与推广价值
这次案例暴露了 阿里云 ChatOps Agent 在非标准化环境下的真实边界:
- 远程命令执行受实例环境和网络影响,偶发命令不存在、超时或返回结果不一致的情况。
- Agent 对实例真实状态的判断需要结合多次命令结果交叉验证,不能单点采信。
- 涉及系统盘清理、Docker 重启、内核升级等高风险操作时,仍需人工确认关键步骤。
因此,最佳实践不是"完全交给 Agent",而是"Agent 负责诊断和规划,人负责确认和执行高风险动作"。
对运维团队而言,这套工作流的价值在于:
- 降低非标准化实例维护门槛:没有 SOP 也能修,隐性知识被 Agent 显性化。
- 缩短变更后 MTTR:把"登录排查"变成"一句话对比诊断"。
- 沉淀可复用模板:同类安全工单可直接套用,减少重复劳动。
- 完整审计链路:每次操作都有会话记录可追溯,满足安全合规要求。
结语
阿里云 ChatOps Agent 不是替代运维人员的工具,而是把"个人经验驱动"转变为"数据驱动 + 人机协同"的入口。在内核漏洞修复这类时间紧、影响大、实例环境差异大的场景中,"参照物 diff"方法能够有效降低不确定性,让客户更快、更安全地完成恢复。

