在复杂专业任务、长周期智能体、百万字文档精读、多模态深度推理等场景,普通大模型常常出现逻辑断层、长距离信息遗忘、复杂推理精度不足的问题。通义千问Qwen3.8-Max作为Qwen系列旗舰基座大模型,专为高复杂度专业任务打造,总参数量达到2.4万亿,推理时动态激活仅950亿参数,兼顾顶尖推理能力与可控的推理开销。模型原生支持百万Token超长上下文窗口,原生集成多模态理解、函数调用、联网检索、代码沙盒执行、上下文缓存等全套能力,在文本推理、视觉理解、复杂代码工程、金融量化、法律文书分析等专业基准测试中取得优异成绩。开发者可以通过百炼平台API快速调用,也可依托开源权重做私有化部署,适配企业级智能体、科研数据分析、合同批量审核、大型代码库重构等高要求业务场景。本文将从模型核心功能、底层技术架构、性能特点、API代码实战、业务场景选型、调优策略、开发避坑要点完整展开讲解,帮助开发者全面掌握Qwen3.8-Max的能力边界与落地方法。
一、Qwen3.8-Max核心功能介绍
Qwen3.8-Max属于多模态MoE旗舰基础模型,输入支持文本、图片、视频帧,输出为结构化文本内容。百万Token上下文窗口是它的核心亮点,可以一次性加载完整的长篇合同、数百页科研论文、完整项目代码仓库,无需对文档做切片拆分,规避文档分段带来的信息丢失、上下文割裂问题,适合一次性完成全文档的逻辑梳理、交叉校验、摘要提取。详情👉访问阿里云百炼大模型服务平台页面 了解。
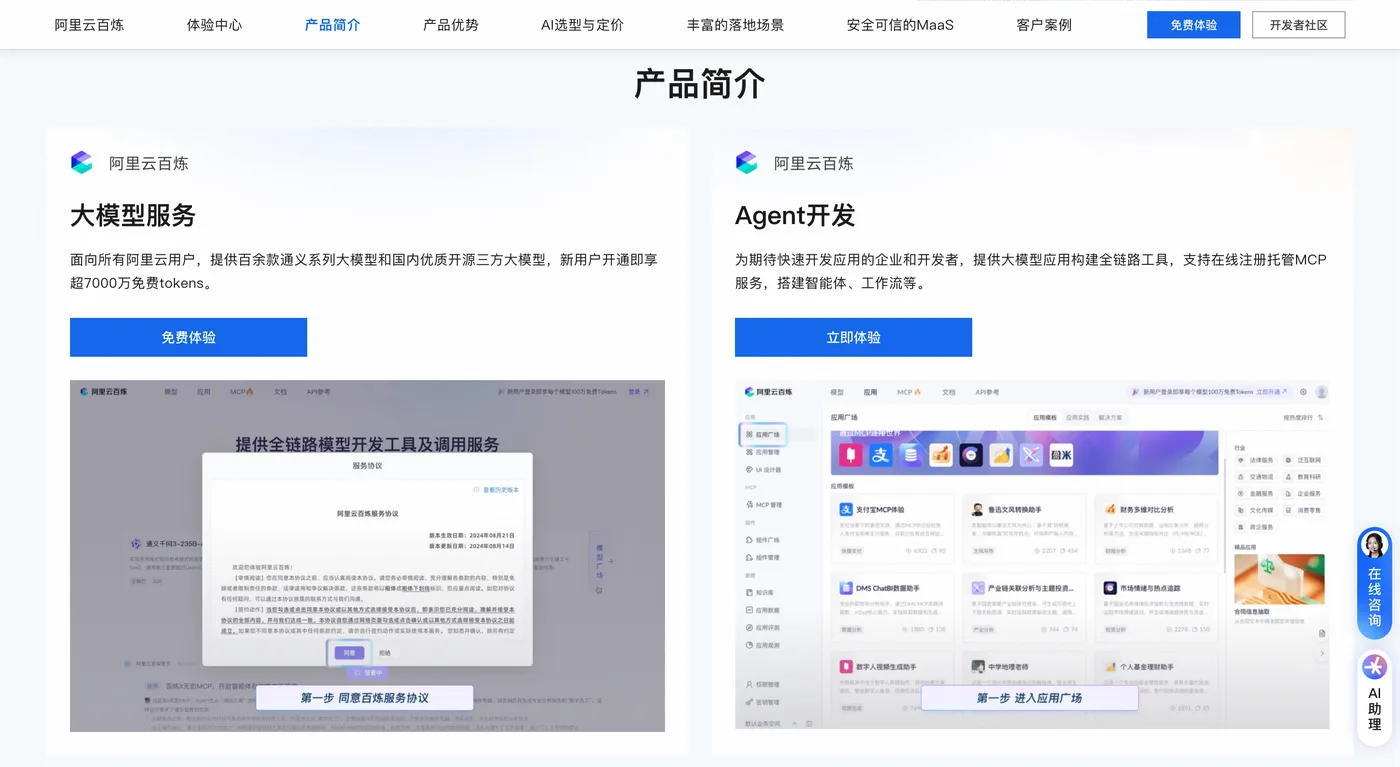
复杂推理与专业领域能力是Qwen3.8-Max的核心优势。模型针对法律、金融量化、科研、工程开发、设计等专业场景深度优化,能够完成多步骤长周期任务,例如量化研究中并行挖掘多组因子、回测验证、策略迭代;法律场景下批量审阅合同条款,识别风险点,比对多版本合同差异;科研场景阅读大量文献,完成实验方案设计、数据结论校验。在长周期任务中,模型可以自主拆解目标,生成多步骤执行计划,持续迭代反馈,维持长时间任务目标不丢失,这一点在复杂Agent智能体项目中尤为关键。
编程工程能力大幅升级,不再局限于单段代码编写。模型能够读懂完整的多文件项目仓库结构,理解模块之间的依赖关系,完成大型项目重构、漏洞扫描、单元测试编写、多语言工程迁移。面对大型工程需求,能够自主拆分开发任务,生成项目目录结构,分批输出代码文件,同时附带注释、部署文档和排错方案,适配后端、前端、数据分析、量化脚本等各类开发场景,可直接接入各类AI编程开发工具作为底层推理基座。
原生多模态理解能力,支持图片、图表、公式、长视频内容解析。可以识别截图代码、复杂财务报表、工程图纸、数学公式,完成图文混合文档的综合推理;长视频内容可通过抽取关键帧送入模型,完成视频内容摘要、关键事件提取、图表数据读取,在财报分析、试卷批改、科研图表解读场景实用性极强。
内置全套工具调用体系,支持Function Calling自定义工具,同时自带联网搜索、网页内容提取、代码解释器等内置工具。模型会自主判断任务是否需要调用外部工具,自动规划工具调用顺序,执行多轮工具迭代,完成复杂闭环任务。例如,联网检索最新行业资料,调用代码解释器执行数据计算与可视化,抓取网页原文做内容精读,工具调用过程稳定,多工具连续调用时不容易出现逻辑错乱。
同时模型支持结构化输出、上下文缓存、前缀续写、批量推理等实用能力。结构化输出可以强制返回标准JSON格式,大幅降低业务侧解析失败概率;上下文缓存机制针对重复前缀内容做缓存,减少重复Token计算,降低长文档循环调用场景的延迟与计费开销;前缀续写支持从指定文本位置继续生成,适合代码补全、文档续写场景。接口层面兼容OpenAI协议,原有基于OpenAI协议开发的业务系统,仅需要修改模型名称与API地址,少量改动代码即可完成迁移,降低项目改造工作量。
二、Qwen3.8-Max技术架构解析
Qwen3.8-Max基于Qwen3.5架构迭代升级,采用稀疏混合专家MoE架构搭配自研混合注意力机制,解决超大参数量模型推理成本高、超长上下文算力爆炸两大痛点。模型总参数规模2.4万亿,但内置路由控制器,收到用户输入之后,路由模块会根据输入文本语义,动态选择少量相关专家网络参与推理,单次推理仅激活950亿参数,其余专家保持休眠状态。这种设计,让模型拥有超大知识库与复杂推理能力,同时推理算力开销远低于同等规模稠密大模型,实现强推理能力与可控推理成本的平衡。
混合注意力机制是支撑百万上下文的底层核心。架构融合多种注意力模块,针对长序列做了针对性优化。对于大量重复、背景类文本,使用线性注意力快速处理,降低算力开销;对于关键信息、需要精细比对的核心段落,切换到高精度稀疏注意力,精准捕捉远距离Token之间的关联关系。百万Token输入场景下,模型不会像传统全注意力模型那样产生平方级算力增长,大幅降低超长文档的预填充耗时,同时保障远距离信息召回精度,避免长篇文档后半段内容遗忘的问题。
模型整体架构分为五层:多模态编码层、词嵌入层、MoE混合专家主干网络层、混合注意力模块、输出预测头。多模态编码层负责将图片、视频帧转为文本对齐的向量表征,和文本向量合并送入主干网络;词嵌入层对文本Token做向量化处理;主干网络由大量专家模块和路由控制器组成,路由动态选择专家参与计算;混合注意力模块在每一层网络内完成序列信息建模;最后输出预测头生成下一个Token。
上下文缓存模块是独立配套优化模块,在多次请求包含相同前缀上下文的场景下,服务端缓存前缀向量,后续请求直接复用缓存结果,不需要重复计算前缀Token。典型场景:反复针对同一篇长文档提问,文档内容作为固定前缀,多次提问只需要计算新问题部分,显著降低Token消耗与接口响应耗时,在知识库问答、批量文档审核场景收益巨大。
训练阶段采用多任务联合训练方案,融合海量专业文本、代码、图文、视频数据,搭配多阶段奖励优化,强化长周期任务规划、多轮工具调用、复杂逻辑推理能力。模型内置多轮任务反馈闭环机制,在Agent任务执行过程中,可以评估当前结果是否满足目标,如果存在偏差,自动调整执行策略,重新规划工具调用步骤,提升长周期复杂任务的成功率。
整套架构同时兼顾云端API调用与私有化本地部署两种模式。云端百炼平台对模型做了分布式负载均衡,自动调度算力资源,高峰期保障接口稳定性;本地部署时,MoE架构支持张量并行,将专家网络拆分到多张GPU卡,合理分配显存开销,在多卡服务器环境下可以实现稳定本地推理。
三、Qwen3.8-Max实战接入指南
开发者接入Qwen3.8-Max主要分为两种方式:百炼平台云端API调用,私有化本地部署。云端API无需准备高性能显卡,开箱即用,适合快速原型开发、线上业务落地;本地私有化部署适合数据不允许出网、高数据安全要求的企业场景,需要多卡GPU硬件支撑。下面提供环境配置、curl命令、Python完整可运行代码示例。
第一步,登录百炼平台控制台,创建API密钥,保存DASHSCOPE_API_KEY,密钥妥善保管,禁止硬编码写入代码仓库、前端页面。模型调用标识:qwen3.8-max。
第二步,配置环境变量,Linux/Mac终端执行下面命令:
export DASHSCOPE_API_KEY="sk-xxxxxxxxxxxxxxxxxxxxxxxxxxxx"
curl请求示例,基础对话调用:
curl -X POST [https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions](https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions) \
-H "Authorization: Bearer ${DASHSCOPE_API_KEY}" \
-H "Content-Type: application/json" \
-d '{
    "model": "qwen3.8-max",
    "messages": [
        {"role":"system","content":"你是资深量化研究专家,擅长因子挖掘与回测策略设计"},
        {"role":"user","content":"简述量化因子挖掘的完整流程,以及需要注意的过拟合风险"}
    ],
    "temperature":0.6,
    "max_tokens":3072
}'
Python兼容SDK调用示例:
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="[https://dashscope.aliyuncs.com/compatible-mode/v1](https://dashscope.aliyuncs.com/compatible-mode/v1)"
)

def qwen38_max_chat():
    response = client.chat.completions.create(
        model="qwen3.8-max",
        messages=[
            {
   "role": "system", "content": "你是专业法律文档分析师,擅长合同风险识别"},
            {
   "role": "user", "content": "请说明在合同审查中,需要重点核查哪些核心风险条款"}
        ],
        temperature=0.6,
        stream=False
    )
    print(response.choices[0].message.content)
    return response

if __name__ == "__main__":
    qwen38_max_chat()
开启工具调用(联网检索+代码解释器)的示例,模型自主判断是否调用工具:
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="[https://dashscope.aliyuncs.com/compatible-mode/v1](https://dashscope.aliyuncs.com/compatible-mode/v1)"
)

tools = [
    {
   "type":"web_search","web_search":{
   }},
    {
   "type":"code_interpreter","code_interpreter":{
   }}
]

resp = client.chat.completions.create(
    model="qwen3.8-max",
    messages=[{
   "role":"user","content":"查找近年量化因子研究相关文献,并用Python绘制简单的因子收益分布示意图"}],
    tools=tools,
    temperature=0.7
)
print(resp.choices[0].message)
本地部署方案,可以使用vLLM推理框架加速MoE模型推理,安装依赖包:
pip install vllm transformers accelerate torch
vLLM本地加载模型基础代码:
from vllm import LLM, SamplingParams

sampling_params = SamplingParams(temperature=0.6, max_tokens=2048)
llm = LLM(model="Qwen/Qwen3.8-Max", tensor_parallel_size=4)

prompt = "解释MoE混合专家模型的路由机制"
outputs = llm.generate(prompt, sampling_params)
for output in outputs:
    print(output.outputs[0].text)
本地部署Qwen3.8-Max对硬件要求较高,建议多卡高性能GPU环境;可采用量化方案降低显存占用,但量化会小幅降低复杂逻辑推理精度,高要求专业场景建议使用完整权重。
四、业务场景选型与模型调优策略
Qwen3.8-Max定位旗舰推理模型,适合对推理精度、长距离逻辑、多步骤任务规划要求高的场景。第一类,专业文档深度分析:法律合同审阅、财报解读、长篇论文精读,一次性加载几十万字文档,完成条款比对、风险识别、结论归纳。第二类,复杂Agent智能体开发,长周期多步骤业务自动化,例如科研辅助、量化研究流水线、多步骤办公自动化,依靠多轮工具调用完成闭环任务。第三类,大型代码工程项目开发,读取完整代码仓库,做代码审计、系统架构重构、漏洞排查、生成全套项目文档。第四类,多模态专业分析,包含图表、公式、截图的混合文档解析,财务报表、工程图纸、科研图表信息提取与推理。
调优策略:专业推理场景,建议调低temperature至0.4~0.6区间,降低随机性,保证推理结果稳定可靠;创意生成类任务可适当调高temperature。长文档场景优先开启上下文缓存,重复文档前缀复用缓存,节省Token开销。如果需要稳定JSON输出,开启结构化输出参数,强制模型返回标准JSON,减少业务侧解析异常。在Agent任务中,设置单次工具调用最大轮次,防止模型无限循环调用工具。
成本优化思路:区分模型选型,简单问答、短文本分类任务不需要使用Qwen3.8-Max,可以选用轻量化模型降低成本;只有复杂推理、长文档、多步骤Agent任务,才使用该旗舰模型。批量任务尽量复用上下文缓存,减少重复Token计费。测试环境和生产环境分开,原型调试阶段使用小批量样本验证提示词逻辑,上线前做压力测试,预估峰值Token消耗。
五、开发常见问题与避坑指南
- 百万上下文不是无限制稳定。虽然模型支持百万Token上下文,但上下文越长,接口延迟越高,Token消耗也会显著增加。业务开发时尽量精简输入内容,剔除无效冗余文本,不要无限制堆叠全部历史对话。关键指令尽量放在提示词靠前位置,提升模型对核心要求的关注度。
- MoE路由负载问题。MoE模型依靠路由选择专家,当输入内容高度集中在某一类专业领域,会出现部分专家负载偏高。云端API平台已经做好负载均衡;本地多卡部署时,需要合理设置张量并行,均衡各卡专家负载,避免单卡显存瓶颈。
- 多模态输入限制。图片、视频帧输入会折算为Token占用上下文窗口,一次性传入大量图片会快速消耗上下文额度,多图文任务需要控制单次传入图片数量。
- 密钥安全管控。API密钥禁止写死在前端、客户端代码中,线上业务请求必须经过后端服务中转。生产环境使用环境变量或者密钥管理服务保存密钥,定期轮换密钥,防止密钥泄露造成额度异常消耗。
- 模型输出不能直接用于高风险业务。模型推理存在概率性误差,金融、法律、医疗等高风险场景,模型输出仅作为辅助参考,必须增加人工复核流程,不能直接依靠模型结果自动执行业务操作。
- 结构化输出仍需要做参数校验。即使开启结构化输出能力,代码依然要增加JSON解析异常捕获与字段校验,防止极端场景下输出格式异常,保障业务系统健壮性。
六、总结
Qwen3.8-Max作为旗舰级多模态MoE大模型,依托2.4万亿总参数、动态激活950亿专家参数、百万Token超长上下文、混合注意力架构,在复杂专业推理、长周期Agent任务、大型代码工程、多模态深度理解等场景实现能力突破。模型内置联网检索、代码沙盒、网页提取等全套工具能力,兼容主流API协议,支持上下文缓存、结构化输出等企业级能力,开发者既可以快速调用云端API,也可以私有化本地部署。详情👉访问阿里云百炼大模型服务平台页面 了解。
对于企业研发团队和专业开发者,当业务需要处理复杂长文档、多步骤科研与金融任务、大型代码项目、多模态专业资料分析时,Qwen3.8-Max是旗舰级的模型选择。落地过程中,做好模型选型区分、提示词调优、上下文缓存配置、密钥安全管理,并且针对高风险业务增加人工复核与结果校验机制,就可以充分发挥模型强大的推理能力,搭建稳定可靠的企业级AI应用与智能体系统。随着模型持续迭代,Qwen3.8-Max的工具调用稳定性、长周期任务规划能力还会持续优化,持续拓展AI在专业领域的落地边界。