做 AI 教育产品,最容易走的一条路是:接一个最强的模型,所有地方都调它,前端加个聊天框。
这条路能跑通,但它把三种完全不同的问题混成了一种:有些任务要的是推理深度,有些要的是语言质量,有些只要一个稳定的分类结果。用同一个模型、同一套参数去做,结果是贵的地方不够贵,便宜的地方白花钱。
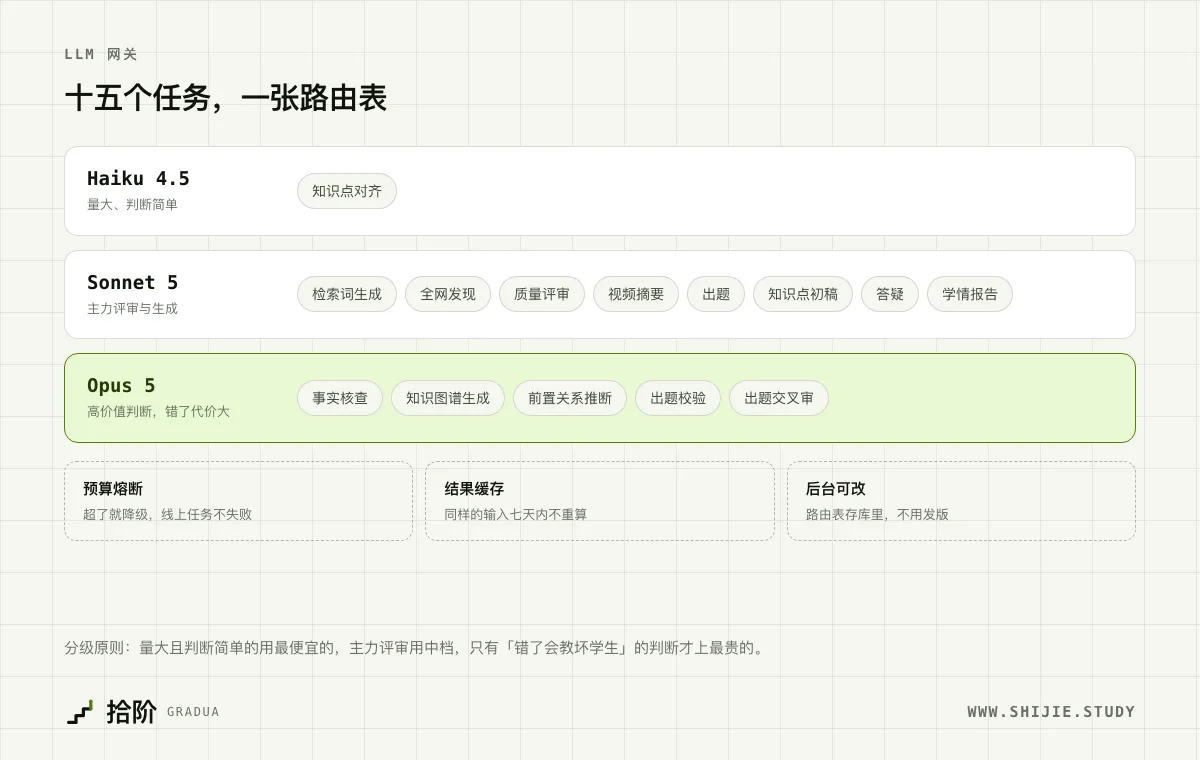
现在的架构是:十五个任务,一张路由表,三档模型。
一、先把任务拆开
我们产品里的 LLM 调用,最后归成了十五个任务:
class LLMTask(StrEnum):
    KEYWORD_GEN = "keyword_gen"                # 检索词生成
    WEB_DISCOVERY = "web_discovery"            # 全网发现候选视频
    KP_ALIGNMENT = "kp_alignment"              # 视频与知识点对齐
    QUALITY_REVIEW = "quality_review"          # 内容质量评审
    FACT_CHECK = "fact_check"                  # 事实核查
    VISUAL_REVIEW = "visual_review"            # 画面审核
    VIDEO_SUMMARY = "video_summary"            # 视频摘要
    KG_GENERATION = "kg_generation"            # 知识图谱生成
    PREREQ_INFERENCE = "prereq_inference"      # 前置关系推断
    QUESTION_GEN = "question_gen"              # 出题
    QUESTION_VERIFY = "question_verify"        # 出题校验
    QUESTION_CROSS_CHECK = "question_cross_check"  # 出题交叉审
    TUTORING = "tutoring"                      # 答疑
    KP_DRAFT = "kp_draft"                      # 知识点初稿
    LEARNING_REPORT = "learning_report"        # 学情报告
拆到这个粒度之后,一件事立刻清楚了:这十五个任务对模型的要求差异极大。
- 「视频与知识点对齐」本质是个分类问题,判断这条视频讲的是不是这个知识点。量极大(一万多条视频 × 候选知识点),但每次判断都很浅。
- 「前置关系推断」是要从几千个知识点里推出一张有向无环图——学这个之前必须先会什么。量小,但一次错了会让整个学习路径歪掉。
- 「学情报告」是写给家长看的一段话。它要的不是推理深度,是语言质量——别写得像机器在念数据。
用同一个模型跑这三件事,怎么配参数都是错的。
二、路由表:按「错了代价多大」分档
分级原则只有一条:量大且判断简单的用最便宜的,主力评审用中档,只有「错了会教坏学生」的判断才上最贵的。
DEFAULT_ROUTES: dict[LLMTask, RouteConfig] = {

    # 量大、判断浅 → 最便宜的,还开批处理
    LLMTask.KP_ALIGNMENT: RouteConfig(model="claude-haiku-4-5", batch=True, max_tokens=2000),

    # 主力评审与生成 → 中档
    LLMTask.QUALITY_REVIEW: RouteConfig(model="claude-sonnet-5", effort=Effort.HIGH,
                                        batch=True, max_tokens=4000),
    LLMTask.QUESTION_GEN: RouteConfig(model="claude-sonnet-5", effort=Effort.HIGH,
                                      batch=True, max_tokens=16000),

    # 错了代价最大的 → 最贵的,effort 也拉满
    LLMTask.FACT_CHECK: RouteConfig(model="claude-opus-5", effort=Effort.XHIGH,
                                    batch=True, max_tokens=6000),
    LLMTask.PREREQ_INFERENCE: RouteConfig(model="claude-opus-5", effort=Effort.HIGH,
                                          max_tokens=32000),
    LLMTask.QUESTION_VERIFY: RouteConfig(model="claude-opus-5", effort=Effort.HIGH,
                                         max_tokens=8000),
}
有两条配置特别值得说。
PREREQ_INFERENCE 给了 32000 的 max_tokens。 因为推断前置关系需要同时看到一大批知识点才能判断依赖,切成小块单独推会得到互相矛盾的结果。这是个「必须一次看全」的任务,token 上给得起就得给。
LEARNING_REPORT 只给了中等 effort 和 2000 token。 注释写得很直白:
#: 学情报告是写给家长看的一段话,不是结构化抽取 —— 要的是语言质量,
#: 不是推理深度。给中等 effort 和够写三段的 token。
把最贵的模型和最高的 effort 砸在一段家长通知上,不会让那段话写得更好,只会让账单更难看。
三、批处理:能等的任务就别急
注意上面有些配置带 batch=True。
这些是离线任务——内容采集、质量评审、出题。它们没有人在屏幕前等结果,跑一晚上和跑十分钟对业务没有区别。而批处理接口的单价明显更低。
所以判断标准很简单:有没有人在等?
- 学生点了「问一下」在等答案 → 同步,而且要快
- 凌晨跑的内容审核 → 批处理
- 教师提交的出题任务 → 批处理,第二天来看结果
这一条几乎是白捡的成本优化,唯一的代价是要把任务的异步链路做出来。
四、预算熔断:超了之后做什么,比超没超重要
async def _check_budget(task: LLMTask, estimated: float) -> str | None:
    """预算检查。返回降级模型名,或 None 表示按原计划执行。"""
    spent = await spent_today()
    if spent + estimated <= settings.llm_daily_budget_usd:
        return None

    if task in CRITICAL_TASKS:
        log.warning("LLM 预算超限,线上任务降级", task=task.value, spent=spent)
        return FALLBACK_MODEL

    log.error("LLM 预算超限,离线任务暂停", task=task.value, spent=spent)
    raise LLMBudgetExceeded(...)
关键在于它对两类任务的处理是不同的:
#: 线上任务预算耗尽时降级到便宜模型而不是直接失败 —— 学生正在等答案。
CRITICAL_TASKS = {
   LLMTask.TUTORING}
FALLBACK_MODEL = "claude-haiku-4-5"
- 离线任务超预算 → 直接停。 反正没人在等,明天再跑。
- 线上任务超预算 → 降级到便宜模型。 学生正在屏幕前等着,给他一个稍弱但可用的答案,比给他一个错误页强。
这个区分看起来是小事,但它是「预算控制」从一个财务功能变成一个可用性功能的关键。一刀切地熔断,等于让财务问题直接变成线上事故。
五、缓存:同样的输入,七天内不重算
cache = Cache(get_redis())
ckey = req.cache_key or _cache_key(req, route.model)

if use_cache:
    hit = await cache.get_json(ckey)
    if hit is not None:
        return LLMResult(..., from_cache=True)
缓存键包含模型名,这一点很重要——换了模型之后结果应该重算,而不是继续吃旧模型的缓存。
命中率在我们这里高得出乎意料,原因是内容类任务的输入天然重复:同一条视频会在不同知识点的候选列表里反复出现,同一个知识点的出题任务可能被触发多次。
TTL 给的是 7 天。再长意义不大——prompt 版本一改,缓存就该失效了。
六、路由表放在数据库里,不在代码里
async def get_route(task: LLMTask) -> RouteConfig:
    """读取路由配置。后台改了配置立即生效(缓存 60 秒)。"""
    cache = Cache(get_redis())
    overrides = await cache.get_json("llm:routes") or {
   }
    base = DEFAULT_ROUTES.get(task, RouteConfig())
    if task.value in overrides:
        return RouteConfig(**{
   **base.model_dump(), **overrides[task.value]})
    return base
代码里的 DEFAULT_ROUTES 只是兜底。真正生效的路由表存在数据库里,管理员在后台能改——换供应商、换模型、调 effort、调 token 上限,都不用发版。
这个决定的回报在模型迭代的时候体现得最明显。 新模型发布、某个任务效果不好想换档、某家供应商临时不可用——这些都是运营决策,不该是一次发版。
供应商层也是抽象的:Anthropic 走原生接口,其余(OpenAI、Gemini、DashScope)走兼容层。业务代码只写 gateway.run(...),不关心背后是谁。
七、一个踩过的坑:凭证检查要在建 Provider 之前
这个坑很具体,但值得说,因为它暴露的是一类问题。
原来的逻辑是:解析路由 → 创建 Provider → 调用。问题在于 Anthropic SDK 在构造的时候就可能抛异常——如果环境里找不到任何凭证,它会抛一句 Could not resolve authentication method。
这句英文会一路冒到学生的屏幕上。
if not _has_credentials(route):
    # 先查凭证、再建 Provider:Anthropic SDK 在构造时就可能抛
    # 「Could not resolve authentication method」,那条消息会一路冒到学生眼前
    log.error(
        "任务路由指向的供应商没有可用凭证,本次调用直接失败",
        task=req.task.value, provider=route.provider_code,
        hint=("去「管理后台 → 模型配置」把这个任务指向一个已填 API Key 的供应商"
              if route.from_db
              else "库里没有这个任务的路由,回落到了默认的 Anthropic —— "
                   "要么在后台给它配一条路由,要么配上 ANTHROPIC_API_KEY"),
    )
    return LLMResult(error="PROVIDER_NO_API_KEY", ...)
修法本身很简单,但注意那个 hint 字段:它根据「这条路由是从数据库来的还是回落的默认值」,给出两句不同的排查建议。
这是我在这个项目里逐渐养成的习惯——错误日志要告诉运维下一步该做什么,而不只是说出了什么事。 写日志的时候多花三十秒,排查的时候省半小时。
八、如果要我总结成三条
一、先拆任务,再选模型。 「用哪个模型」这个问题在任务没拆开之前是无解的,因为你面对的其实是十五个不同的问题。
二、按「错了代价多大」分档,不按「这个功能重不重要」分档。 答疑功能对用户很重要,但它答得稍弱一点,学生会再问一句;出题校验对用户是无感的,但它错了会直接教出错误认知。后者才该上最贵的模型。
三、把路由表交出去。 放进数据库、给后台入口。模型迭代的速度比你发版的速度快。
附:那十五个任务,最后长成了什么
架构图好画,关键是它有没有变成用户能看见的东西。下面四张是那十五个任务在界面上的落点。
PREREQ_INFERENCE(前置关系推断)→ 「建议先学」。 这个学生的「相反数」掌握度 94%,但系统仍然提示他先补「数轴」——因为数轴是它的前置知识点,而那个点的掌握度是 0%。这条依赖关系就是 Opus 从几千个知识点里推出来的那张图。
QUALITY_REVIEW + 教研定选 → 「换个老师讲」。 右侧的备选讲法带差异标签,标的是它和主推的差别在哪。
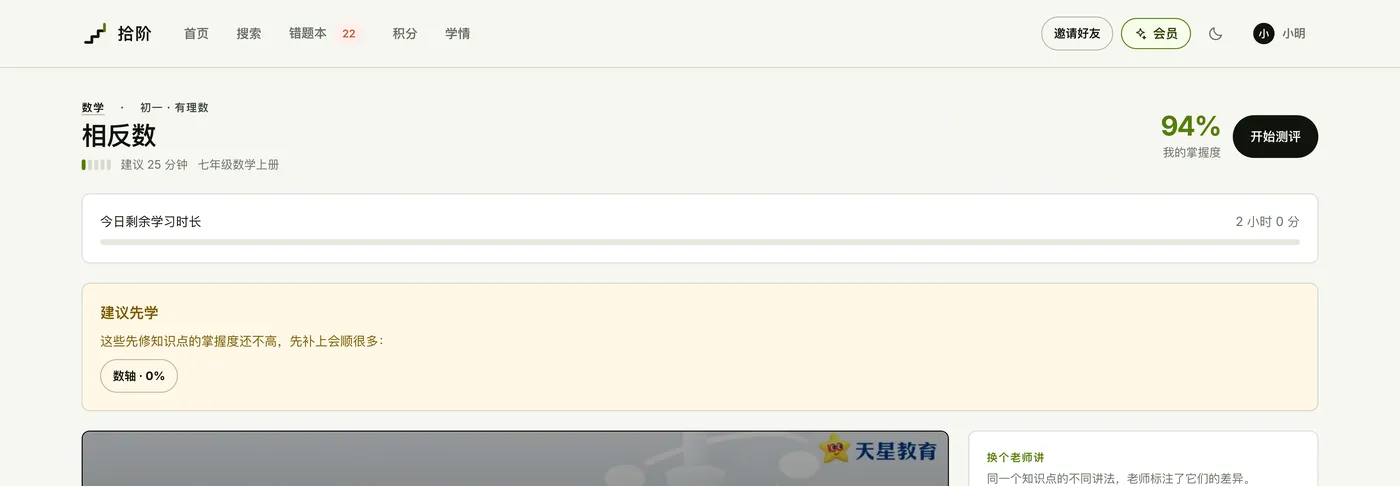
知识点页:前置建议来自 PREREQ_INFERENCE,备选讲法来自选片流水线
KP_ALIGNMENT + QUALITY_REVIEW → 教师工作台的那几个数字。 每行右边的候选/备选/题目,和下面那个 7.7 分,都是流水线跑出来的。教研看到的不是一堆原始视频,是已经打好分、标好知识点的候选清单——他只需要判断和拍板。
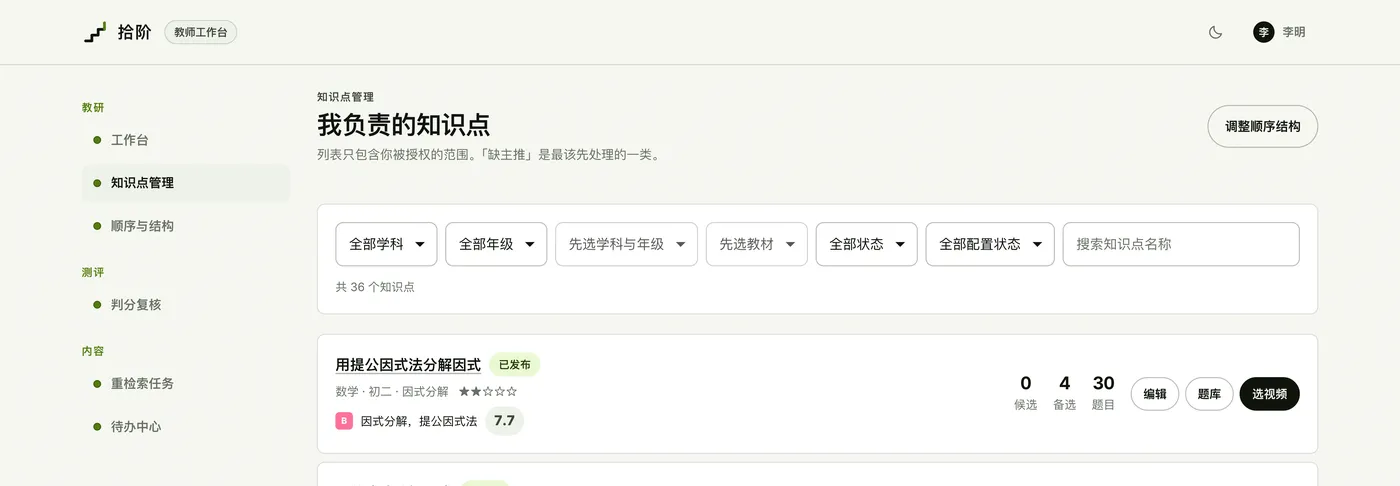
教师工作台:算法只负责海选,定选权在人
QUESTION_GEN → 学生做的题。
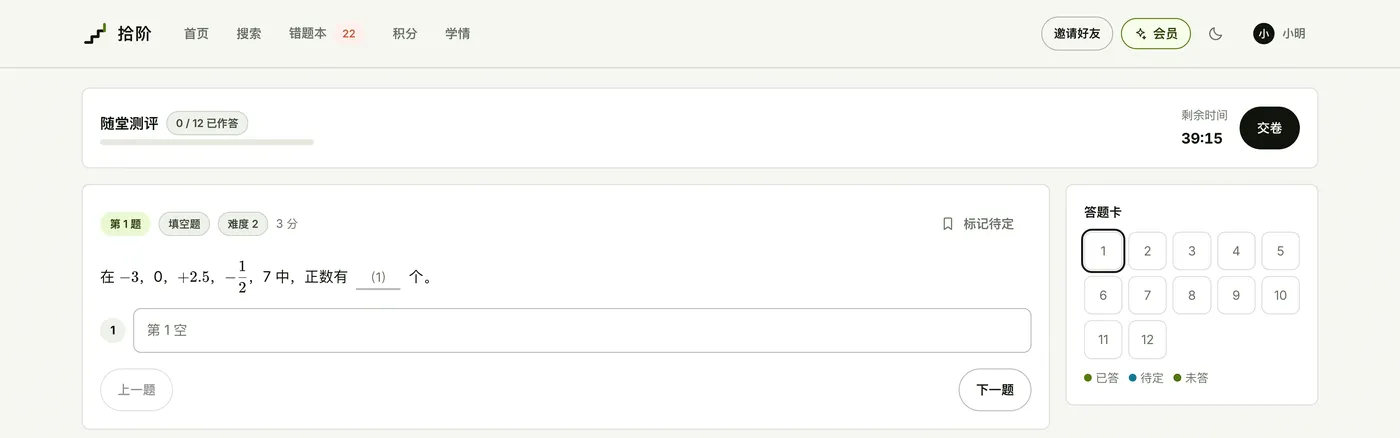
随堂测评
判分 + 掌握度回写 → 测评结果。 右侧「各难度得分率」把成绩按难度拆开——这个拆法直接对应掌握度算法里的难度权重。
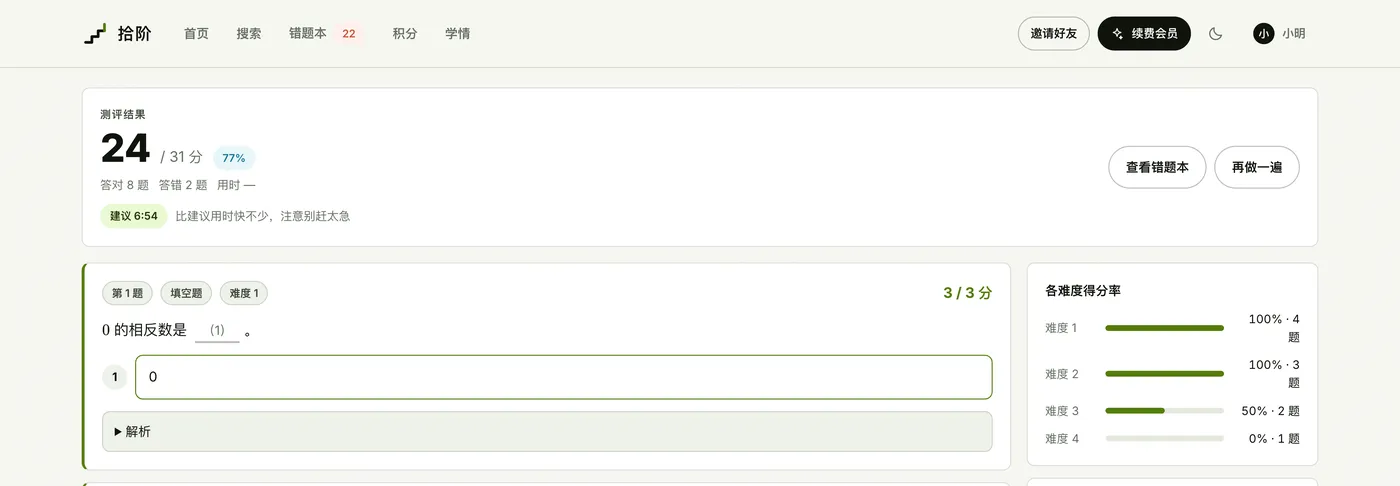
测评结果:按难度拆开,不是只给一个总分
一张路由表的价值,最终体现在这几屏上。
下一篇讲一个更具体的问题:AI 出的题为什么不能直接给学生做,以及我们为此加的四道闸门。