
15 个 Docker 容器,双层记忆,本地零成本跑日常任务,云端 API 只兜复杂推理的底。这套架构我实际跑了一段时间,把踩过的坑和取舍一次讲清。
一、为什么自建,而不是直接用 SaaS?
市面上的 AI 助手很好用,但当你把简历、求职材料、个人项目数据反复喂给它的时候,三个问题就暴露了:
- 隐私:敏感个人信息上传到第三方服务器,心里始终不踏实;
- 成本:日常问答、文本整理这类简单任务,用云端大模型属于「高射炮打蚊子」,token 费纯属浪费;
- 可控:SaaS 说改版就改版、说限流就限流,自己的平台自己说了算。
但纯本地也有硬伤:小模型跑复杂推理(比如长文分析、多步规划)能力明显不够。所以我的答案是——不二选一,两条通道都要。
二、总体架构:一张图看懂
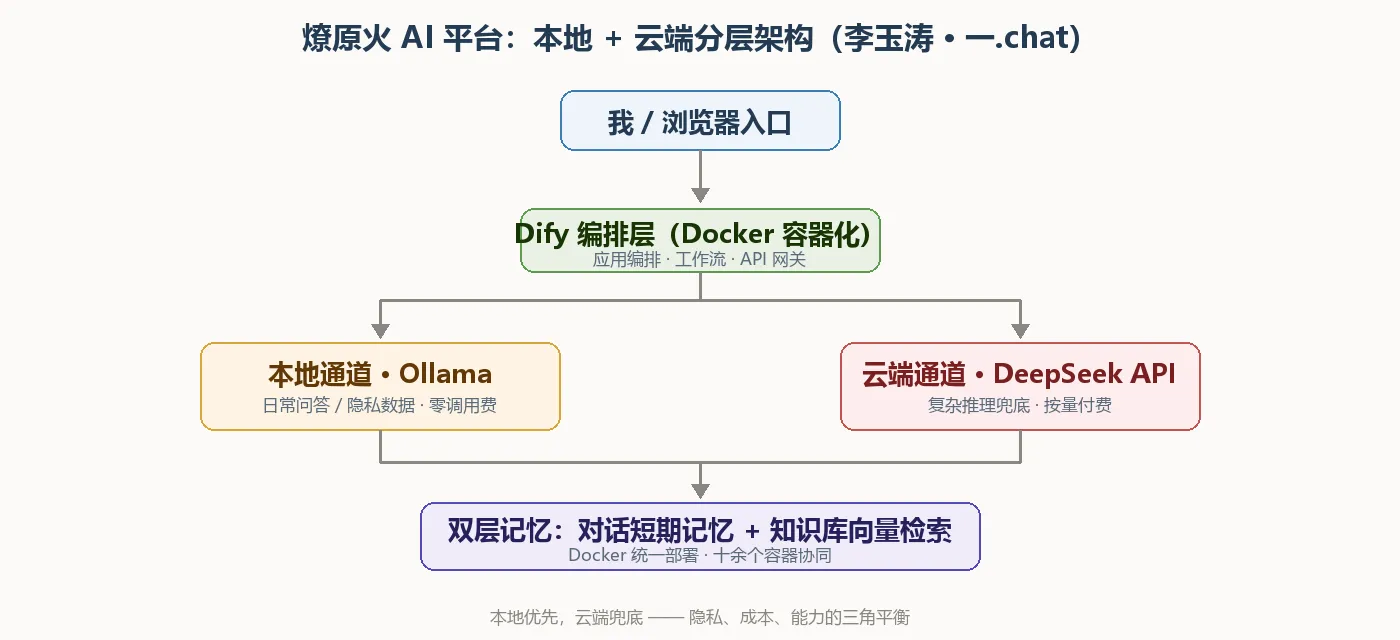
整个平台分四层:
- 用户入口层:统一的对话界面,用户只管提问,不感知后端用了哪个模型;
- Dify 编排层:整个平台的「大脑」,负责工作流编排、Prompt 管理、模型路由,全部容器化部署;
- 双通道执行层:本地通道(Ollama)+ 云端通道(DeepSeek API),按任务复杂度自动分流;
- 双层记忆层:对话短期记忆 + 向量检索长期记忆,让 AI 记得住上下文、也翻得动历史资料。
三、双通道设计:本地优先,云端兜底
这是整套架构里最核心的一个决策。分流逻辑如下:
| 维度 | 本地通道 · Ollama | 云端通道 · DeepSeek API |
|---|---|---|
| 成本 | 电费,约等于零 | 按 token 计费 |
| 隐私 | 数据不出本机 | 出网到第三方 |
| 延迟 | 无网络往返,首 token 快 | 受网络波动影响 |
| 能力上限 | 小模型,复杂推理吃力 | 强推理,长文本稳 |
| 适合任务 | 日常问答 / 文本整理 / 格式化 | 深度分析 / 多步规划 / 代码生成 |
分流原则一句话:简单任务本地跑满,复杂任务才交给云端。 这样一来,90% 的日常请求成本归零,API 费只花在刀刃上。
四、双层记忆:短期会话 + 长期向量
只用聊天记录做上下文,AI 是「金鱼记忆」;只做向量检索,AI 又「失忆」于当前对话。所以做了双层:
- 第一层 · 对话短期记忆:当前会话的滚动窗口,保证多轮对话连贯;
- 第二层 · 向量长期记忆:历史资料、往期对话切片后向量化,检索时按语义相关性召回。
两层叠加的效果是:AI 既知道「我们刚才聊到哪」,也知道「你上周让我准备过什么」。
五、部署踩坑实录(都是真实坑)
坑 1:Ollama 模型用完即卸载
本地模型默认推理完就释放显存/内存,下一轮对话要重新加载,延迟暴涨。解法是设置 OLLAMA_KEEP_ALIVE 让模型常驻,代价是常驻内存占用——我按机器配置做了权衡。
坑 2:输出长度被截断
num_predict 参数没调,长回答总是半途而废。这个参数控制最大生成 token 数,默认值偏保守,做长文任务必须显式调大。
坑 3:Docker 容器编排
Dify 全家桶 + Ollama + 向量库 + 中间件,最终跑起来 15 个容器。一开始没理清依赖关系,容器启动顺序错乱导致服务起不来,后来靠 depends_on + 健康检查理顺。
六、写在最后
这套平台的真正价值不在技术多炫,而在于想清楚了一个平衡:
隐私、成本、能力,三者不必全选,分层即可兼得。
- 平台演示:一.chat
- 代码与项目:GitHub · Leo-Li638
如果这篇文章对你有帮助,点赞收藏是最大的支持。有问题欢迎评论区交流。


