
做过几套中小制造数字化项目,踩过坑,也跑通过云MES + 边缘网关 + 金蝶/用友 + OPC UA/Modbus 的集成。
一、为什么很多中小厂MES项目做着做着就黄了?
不是MES功能不够强,而是边界没划清:
• ERP想让MES去管设备控制
• MES想让PLC去管业务状态流转
• 实施方把工单、工序、报工、设备点检全塞进一张大宽表
• 接口一改,ERP/MES/SCADA全线报错
其实ISA-95标准早就说清楚了,各层各管一摊:
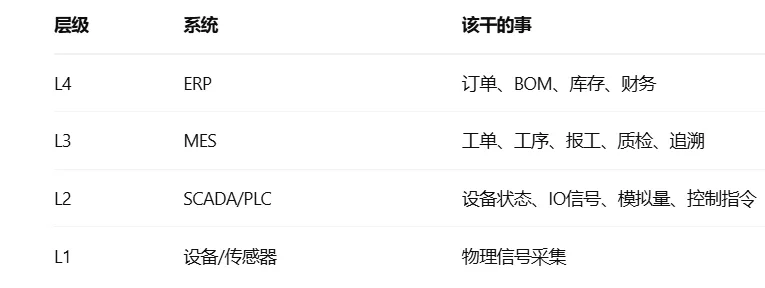
MES不该替代PLC做PID调节,也不该替代ERP做MRP运算。
它的核心价值就一件事:把设备数据翻译成业务语言,把业务指令翻译成设备动作。
二、整体架构长什么样?
[PLC / CNC / DCS]
↑ Modbus / OPC UA / MQTT
[边缘网关 / 采集服务] ← 车间本地,断网也能缓存
↑ JSON over MQTT / HTTPS
[云MES]
↑ REST API / 中间表
[ERP:金蝶云星空 / 用友U8]
三个关键设计原则:
- 工业协议在车间本地终结——不让OPC UA直接穿透公网,安全且稳定
- 边缘侧做协议解析 + 断网缓存——车间网络没你想的那么可靠
- 云MES只处理业务对象——工单、工序、报工、检验、设备状态,不碰底层控制
三、向下接PLC:核心是把"地址"变成"业务"
1. 协议怎么选?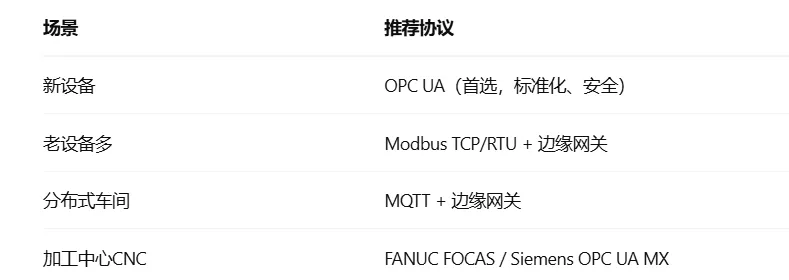
2. 地址到业务字段的映射
PLC里看到的是 DB100.DBW2 = 3050,但MES需要的是:
{
"workOrderNo": "WO-20260928-001",
"operationNo": "OP10",
"deviceCode": "CNC-03",
"status": "RUNNING",
"spindleLoad": 62.5,
"ts": "2026-09-28T17:55:00+08:00"
}
边缘网关实际干三件事:
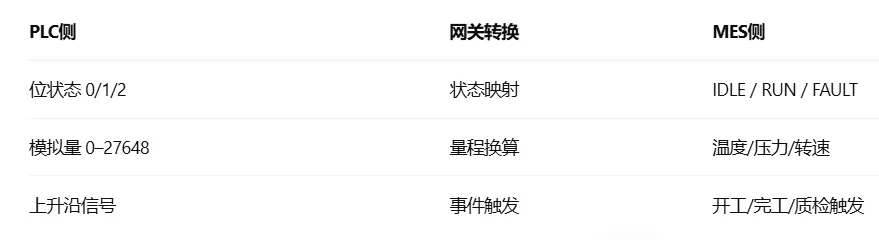
3. 断网了怎么办?
车间网络不稳定是常态,所以边缘侧必须有本地缓存:
def on_plc_event(payload):
payload["ts"] = device_clock() # 用设备时间,别用云端时间
if cloud_reachable():
mqtt_publish("mes/event", payload)
else:
local_sqlite.insert("offline_queue", payload)
def flush_offline():
# 网络恢复后,按时间顺序补传
for row in local_sqlite.query("offline_queue ORDER BY ts"):
    if mqtt_publish("mes/event", row):
        local_sqlite.delete("offline_queue", row.id)
踩坑经验:时间戳一定用设备端时间,别用云端接收时间。否则追溯时事件顺序会乱。
四、向上接ERP:别一上来做200个接口
很多项目死在"接口太多、全量同步、双向耦合"。其实先跑通三个核心接口就够了:
ERP → MES(下发)
• 生产工单
• BOM / 工艺路线
• 物料主数据
MES → ERP(回写)
• 报工结果
• 完工入库单
• 物料消耗 / 不良数量
状态回写
• 工单状态:已下发 → 开工 → 完工 → 入库
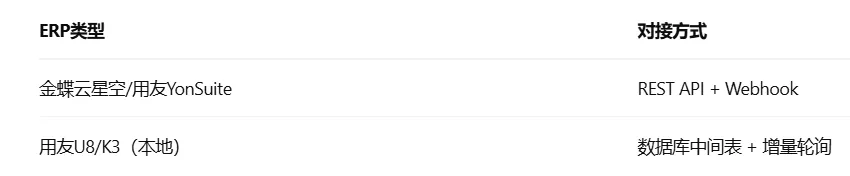
金蝶/用友的对接方式:
ERP类型 对接方式
报工回写示例:
@PostMapping("/api/erp/work-report")
public ResponseEntity<?> reportToErp(@RequestBody WorkReport report) {
// 1. 校验ERP工单是否存在
ErpWorkOrder order = erpClient.getOrder(report.getErpOrderNo());
if (order == null) return BAD_REQUEST;
// 2. 构造报工数据并回写ERP
erpClient.postProductionFeedback(ProductionFeedback.builder()
    .workOrderNo(report.getErpOrderNo())
    .operationNo(report.getOperationNo())
    .qtyGood(report.getQtyGood())
    .qtyScrap(report.getQtyScrap())
    .reportTime(report.getTs())
    .build());

// 3. 标记MES侧已回写
mesService.markReported(report.getId());
return OK;
}
五、数据模型别偷懒(这是最容易翻车的地方)
中小厂MES最常见的错误:把"工单号+工序+报工+设备"写成一张大宽表。
后面做OEE、追溯、返工全废。
最小可用模型就三张表:
-- 生产工单
production_order(
order_no PK,
erp_order_no, -- ERP来的单号
product_code,
plan_qty,
status
);
-- 工序
operation(
op_id PK,
order_no FK, -- 关联工单
op_no, -- 工序号
device_code,
plan_start,
plan_end
);
-- 报工记录
work_report(
report_id PK,
op_id FK, -- 关联工序
worker_code,
qty_good,
qty_scrap,
report_ts
);
关系很清楚:工单 → 工序(一对多)→ 报工(一对多)。
别偷懒合并,后面你会感谢自己的。
六、云和本地,怎么选?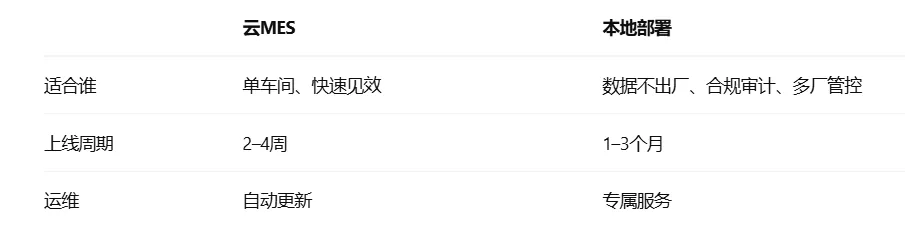
正确路径是:先云后本地。
云版把执行层流程跑通、数据模型验证OK之后,如果有合规要求再迁本地。底层模型一致,不用推倒重来。
这也是万界星空这类厂商在做的事:云版跑执行层闭环,行业模板(机加工/漆包线/化工/锂电)解决行业模型问题,本地部署解决数据主权问题。
七、给开发/集成商的6条建议
- 先画数据流,再拖页面——很多人一上来就画UI,后面接口全返工
- 接口先跑3个:工单下发、报工回写、物料消耗,其他后面再加
- PLC采集先跑1台设备,别一上来接整条线
- MES里别写PID控制逻辑,那是PLC的事
- ERP里别存工序级报工明细,那是MES的事
- 边缘侧必须能断网缓存,车间网络永远没你想的稳
八、一句话总结
云MES的价值不是"上云",而是:
用一套业务模型,把PLC的工业数据和ERP的计划数据接起来。
中小制造数字化,别先谈数字孪生,别先谈AI排产。先把这四件事做扎实:
• 工单下得来
• 报工报得准
• 设备状态看得见
• ERP账能对上
有了这个底座,后面接AI-APS、预测性维护、质量分析,才有数据可喂。


