晚上七点四十分,你把质量报告发进发布审批群。十分钟后,群里有人回了个『收到』,有人回了句『辛苦了』,上线照旧。三天后回滚通知弹进群,有人翻回你那份报告,问了一句:『报告里提过这个点吗?』你打开自己写的东西看了半天,答不上来——报告写了通过率、写了缺陷数,但它从来没写:这次上线谁放的行、依据哪一条、出了错找谁。
成绩单式报告陈述的是已经发生的事;放行决策件陈述的是接下来怎么办、谁来拍板、拍板有效到什么时候。这个差距不是补数据能补上的,它是个结构问题,而结构可以钉死在五个字段上。
还有一个反直觉的事实,先说白:报告的数据越全,往往越没人引用;反而五行长度的记分卡,会得到『选A』这样的回复。
一、先回答『成绩单为什么不够』
结论:读者打开报告的任务是做一个决定——放行、有条件放行、还是拦截。成绩单给不出这个决定的抓手,于是报告发出去只有『收到』,上线时没人引用它,回滚时也没人引用它:一份不被引用的报告,就是复核成本最高的报告。
| 对照维度 | 成绩单式报告 | 放行决策件式记分卡 |
|---|---|---|
| 放行效率 | 拍板人逐项私聊『这块到底行不行』,口头确认不留痕 | 判定字段直接给出三态与理由,评审会上一句话:同意记分卡,或反对第X条 |
| 追责链 | 『当时提示过』成了纪要里一行死无对证的字 | 判定、签名、到期日三点成链,复盘能还原当时信息下为何选A |
| 复核成本 | 每条结论要开三个系统、再问两个人 | 每条结论挂一个可点开的编号,溯源以分钟计 |
| 读者体验 | 读者自己从数据里总结结论,顺便自己承担风险 | 报告替读者完成总结,读者只对决策负责 |
把它锚回你熟悉的东西:很多团队开过发布评审会,会上有人拿着检查清单逐项过嘴。记分卡就是那场会的结构化版本——清单念完就散了,记分卡留下,而且出事时能指着它说清当初哪一格是绿的、哪一格本来就该是红的。
报告被忽略还有个更直白的原因:它回答的是『测试干得怎么样』,而拍板人要回答的是『能不能放』。这两道题的词汇表只重叠一小截,剩下全要读者自己翻译——翻译要力气,力气背后是责任,于是拍板人最省力的动作变成『先过吧,出问题看监控』。五字段的价值,就是把这段翻译过程提前替你写完,并且落成白纸黑字。
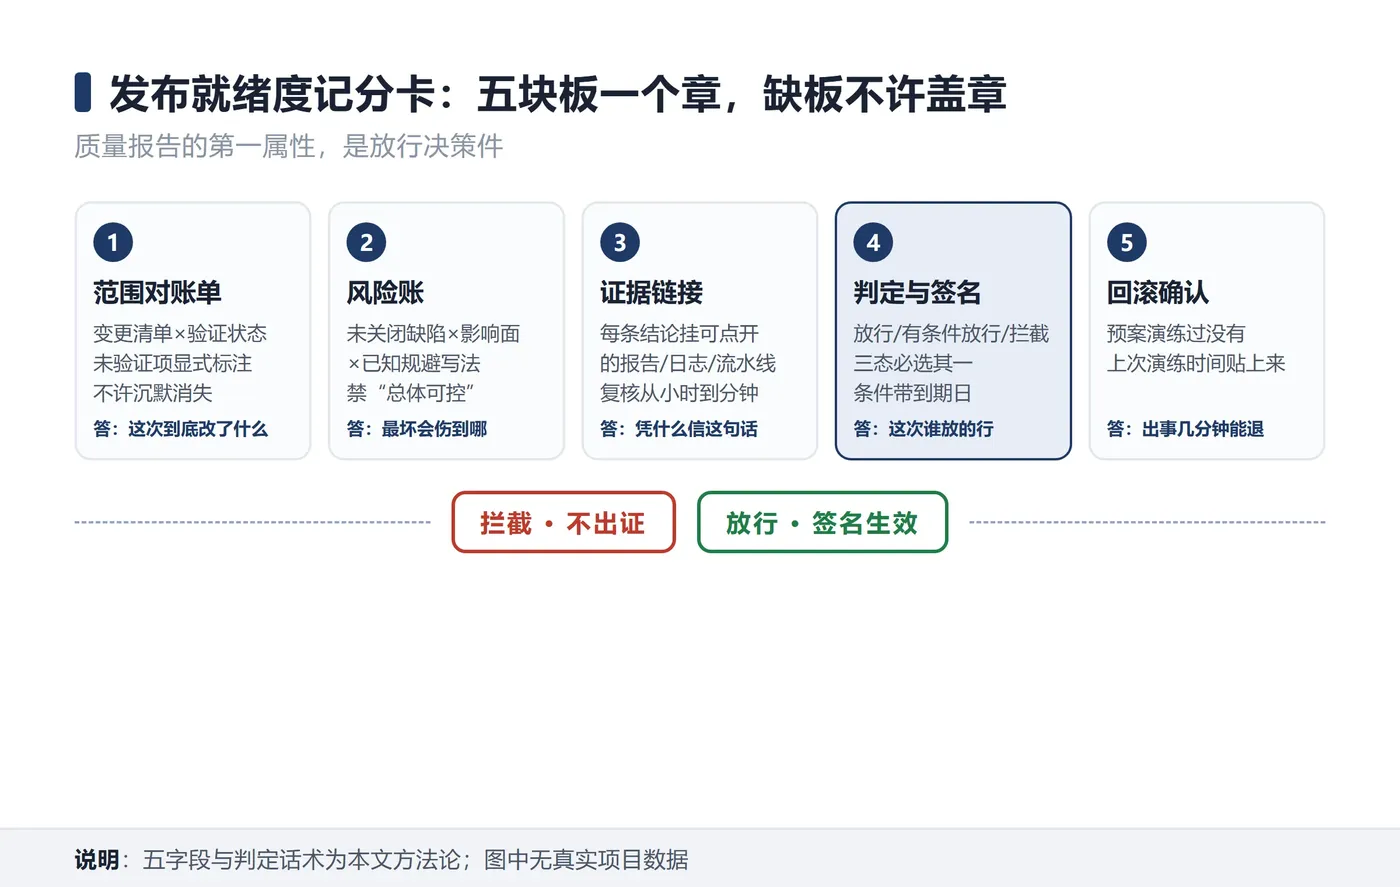
二、五字段:每个回答一个问题,防一种误放行
结论:范围、风险、证据、判定、回滚,五格各答各的问题;缺哪一格,就解锁哪一种特定的误放行姿势。
| 字段 | 回答的问题 | 缺了会发生哪种误放行 |
|---|---|---|
| ①范围对账单 | 本次发布的每项变更都验证过了吗?没有的那项在哪? | 没测的变更从表里『安静消失』,读者默认没写=没问题 |
| ②风险账 | 还有什么没关?能不能绕?拖到什么时候? | 『总体风险可控』一句话掩护所有未关闭缺陷一起上线 |
| ③证据链接 | 每条结论的出处是什么?点开要多久? | 结论靠口头背书,事故复盘时谁也指认不了谁 |
| ④判定与签名 | 放不放行?带什么条件?谁签字? | 『有条件放行』退化成『放行』——条件是啥没人记得 |
| ⑤回滚预案确认 | 出了问题退得回去吗?退路验证过吗? | 预案平日躺在wiki里,事故当天第一问是『回滚脚本谁有权限』 |
五格里最容易失守的是范围对账单里的『未验证』:成绩单只在有结果可秀的时候才写验证状态,没验证的那行悄悄消失,空白是沉默的,而沉默的空白就是明天的事故位。记分卡反过来——每项变更的状态必须是『已验证/验证未过/未验证』三选一,第三种必须占一行、必须被高亮,高亮到你没法假装没看见。风险账同理:『可控』不是判据,每条未关闭缺陷写三样——影响面、已知规避、到期日。判定字段三态里,有条件放行必须带条件清单和到期日,过期自动升格为拦截。回滚确认最诚实:没演练过的预案不能写成『预案齐备』,这个字段只接受三个事实——有没有预案、上次演练时间、演练结论。
每个字段都可以配一个走夜路的画面。范围对账单栽过的坑:一处『纯文案改动』蹭上发布列车,没人觉得它需要回归,后来才发现那句文案是从字段拼出来的,字段改名把页面拼崩了——这类窟窿不在风险账里,在第一格的空白里。风险账栽的坑是『总体风险可控』这六个字:它是报告里最不可能出错的句子,也是出了错之后最没用的句子。证据链接栽的坑:结论全对,但原始运行记录再也找不出来,复盘时只能靠回忆还原现场。判定与签名栽的坑最伤:『有条件放行』的条件在群里口头说过一遍,两个迭代之后没人认账,条件就成了薛定谔的条件。
三、跑一遍:junit.xml 和缺陷表直接生成记分卡
结论:记分卡的三份输入,你的流水线今天就已经存在——junit 结果、发布单、缺陷导出,缺的只是装配。下面脚本纯标准库、开箱即跑,首次运行自动构造样例文件,换上真实产物即原样可用。
# -*- coding: utf-8 -*-
"""readiness_card.py —— 发布就绪度记分卡生成器(纯标准库,开箱即跑)

用法:python readiness_card.py
首次运行自动构造 junit.xml / changes.csv / defects.csv 三个样例,
换成流水线的真实产物,脚本原样可用。
"""
import csv
import os
import xml.etree.ElementTree as ET
from datetime import date

JUNIT = """<?xml version="1.0" encoding="UTF-8"?>
<testsuites name="release-2026.09.23">
  <testsuite name="CH-101" tests="42" failures="0" errors="0" skipped="1"/>
  <testsuite name="CH-102" tests="18" failures="2" errors="0" skipped="0"/>
  <testsuite name="CH-104" tests="7" failures="0" errors="0" skipped="0"/>
</testsuites>
"""

CHANGES = """id,描述,负责人,流水线,回归套件
CH-101,订单按仓拆单,李某,#4471,CH-101
CH-102,优惠券叠加规则,王某,#4471,CH-102
CH-103,对账定时任务改造,康某,#4473,CH-103
CH-104,物流详情页文案,赵某,#4472,CH-104
"""

DEFECTS = """编号,级别,状态,影响面,已知规避,关联变更
B-207,major,未关闭,特定券组合下金额算少,无稳定规避,CH-102
B-208,general,未关闭,物流详情文案错别字,配置侧人工订正,CH-104
B-199,general,已关闭,—,—,CH-101
"""

ROLLBACK = {
   "预案文档": "ops/rollback-2026.09.md", "上次演练": date(2026, 5, 30), "演练有效期天数": 90}


def ensure_samples():
    for name, text in (("junit.xml", JUNIT), ("changes.csv", CHANGES), ("defects.csv", DEFECTS)):
        if not os.path.exists(name):
            with open(name, "w", encoding="utf-8") as f:
                f.write(text.strip() + "\n")


def read_csv(name):
    with open(name, encoding="utf-8") as f:
        return list(csv.DictReader(f))


def suite_stats():
    root = ET.parse("junit.xml").getroot()
    return {
   s.get("name"): {
   "tests": int(s.get("tests", 0)),
                            "failed": int(s.get("failures", 0)) + int(s.get("errors", 0))}
            for s in root.iter("testsuite")}


def verify_status(changes, suites):
    rows = []
    for c in changes:
        s = suites.get(c["回归套件"])
        if s is None:
            state = "**【未验证】**"          # 空白不许沉默,显式挂旗
        elif s["failed"] > 0:
            state = f"验证未过({s['failed']} 条失败)"
        else:
            state = f"已验证({s['tests']} 条通过)"
        rows.append((c["id"], c["描述"], c["负责人"], c["流水线"], state))
    return rows


def verdict(rows, defects):
    open_d = [d for d in defects if d["状态"] == "未关闭"]
    blockers = [d for d in open_d if d["级别"] in ("blocker", "critical", "fatal")]
    unverified = [r for r in rows if "未验证" in r[4]]
    failed = [r for r in rows if "验证未过" in r[4]]
    reasons = []
    if unverified:
        reasons.append("存在未验证变更:" + "、".join(r[0] for r in unverified))
    if failed:
        reasons.append("回归未过:" + "、".join(r[0] for r in failed))
    if blockers:
        reasons.append("致命缺陷未关闭:" + "、".join(d["编号"] for d in blockers))
    if reasons:
        return "拦截", reasons, open_d
    if open_d:
        cond = ";".join(f"{d['编号']} 规避有效,{d['关联变更']} 补丁到期日前修复" for d in open_d)
        return "有条件放行", [f"条件:{cond}"], open_d
    return "放行", ["五字段全绿"], []


def rollback_line(meta, today):
    days = (today - meta["上次演练"]).days
    mark = "有效" if days <= meta["演练有效期天数"] else "**超期**"
    return (f"预案:{meta['预案文档']}|上次演练 {meta['上次演练']}({days} 天前)"
            f"|按 {meta['演练有效期天数']} 天有效期判定:{mark},"
            f"{'安排本迭代内演练一次' if mark != '有效' else '随发布窗口复验'}")


def main():
    ensure_samples()
    rows = verify_status(read_csv("changes.csv"), suite_stats())
    defects = read_csv("defects.csv")
    v, reasons, open_d = verdict(rows, defects)
    today = date(2026, 9, 23)

    out = ["# 发布就绪度记分卡(release-2026.09.23)", "",
           "## ① 范围对账单", "| 变更 | 描述 | 负责人 | 证据 | 验证状态 |", "|---|---|---|---|---|"]
    out += [f"| {r[0]} | {r[1]} | {r[2]} | junit.xml×{r[3]} | {r[4]} |" for r in rows]
    out += ["", "## ② 风险账", "| 缺陷 | 级别 | 影响面 | 已知规避 | 关联变更 |", "|---|---|---|---|---|"]
    out += [f"| {d['编号']} | {d['级别']} | {d['影响面']} | {d['已知规避']} | {d['关联变更']} |"
            for d in defects if d["状态"] == "未关闭"]
    out += ["", "## ③ 证据链接", "每条结论可点开:junit.xml(套件级计数)、defects.csv(缺陷单导出)、"
            "changes.csv(发布单),流水线 #4471—#4473。", "",
            "## ④ 判定与签名", f"**判定:{v}**", *[f"- {r}" for r in reasons],
            "- 执笔:测试负责人___ 产品确认:___ 值班交接:___", "",
            "## ⑤ 回滚预案确认", "- " + rollback_line(ROLLBACK, today), ""]
    print("\n".join(out))


if __name__ == "__main__":
    main()
为什么这么写,两个刻意的『不聪明』。其一,verify_status 按 changes.csv 里显式的『回归套件』列去查结果,查不到时默认值不是『已验证』而是【未验证】——映射关系可以粗糙,兜底方向不能反,反了记分卡就成了橡皮图章;也别拿套件名和变更描述做模糊匹配,改名那天就是证据断链那天。其二,verdict 的三态判断故意写得很硬:有未验证项、有回归未过项,一律拦截,不给『综合判断』留口子——判定是函数,人讨价还价的空间应该留给签名栏,不该藏在代码里。样例跑出来的结果是拦截:CH-103 在 junit 里没有对应套件,CH-102 有失败用例,两条理由白纸黑字,拍板人想放行就得先解决这两行。
把样例往回推一步还能看到另外两个状态:给 CH-103 补一个通过的套件、把 CH-102 的两条失败转成已闭环的缺陷,判定就自动落到『有条件放行』,条件行会写成『B-207 规避有效、补丁在到期日前修复』——这句话的分量全在到期日:到了日期没人动,有条件放行自动变回拦截,条件不许永远漂着。三态能被机械判出来,签名栏才是真责任:人签的是『我同意偏离记分卡』这件事,每次偏离都在报告里多出一行可追责的字,而不是少掉一行。
四、挂进CI:报告正文只剩一行判定
结论:记分卡要挂在流水线末尾,不能指望发布评审前有人手动去跑——依赖自觉的流程,早晚输给加班。
pytest 出 junit 结果只要两行(GitHub Actions 示意):
- run: pytest --junitxml=report.xml
- run: python readiness_card.py >> $GITHUB_STEP_SUMMARY
从此你的质量报告正文可以缩到一句话:本次记分卡判定为哪一态、理由几条、链接在此。报告写的不再是『测试干得怎么样』,而是『这次上线放不放、凭什么放、放到什么时候为止』。
还有一条分工建议值得写进团队约定:记分卡可以也应该由流水线生成,但签名必须留给人工动作——机器负责让『现在是什么状态』不可伪造,人负责让『谁接了这个风险』不可伪造,两种不可伪造钉在一起,这份报告才第一次具备了被追溯的资格。
一份质量报告的段位,不体现在通过率好不好看,体现在读者不@你的时候,也能从报告里读出:这次放行是谁、依据哪条、授权有效期到几点。