AI Agent 事故复盘的十维度归因写法:从指令完整性到执行完整性,每维都产出一条可回归用例
arxiv 编号 2609.09875 的 AgentAudit 论文(v1 提交于 2026-09-09,标题《AgentAudit: An Open, Extensible Framework for Full-Lifecycle Trust Evaluation of AI Agents》)提出一套可接入现有 LLM Agent 的全生命周期可信评估框架,通过读取 Agent 执行轨迹完成可信评估、行为分类与失败定位;摘要口径覆盖 10 个维度:指令完整性、规划器、记忆、工具选择、工具调用、工具正确性、对齐、工具忠实性、安全、执行完整性。多数人会关注它跑了什么模型、得了多少分——那是评测圈的热闹;对做 AI Agent 应用测试的工程师真正有借鉴意义的是这 10 个维度本身,尤其是把它搬进事故复盘报告的写法里。
复盘现场是这样的:AI Agent 线上出了一次事故——用户问「帮我改地址」,Agent 调了「取消订单」工具,用户炸了。复盘会开完,报告结论写一句「模型理解偏差,已优化 Prompt」。三个月后同类事故再出一次,报告结论还是「模型理解偏差」。这篇以质量审计报告体,给出一份用十维度做归因、能让每次事故沉淀成可回归用例的复盘报告写法。
一、审计结论摘要
审计对象是这份 Agent 线上事故的复盘报告结构,三条发现按风险从高到低。
第一,根因从未被真正定位。「模型理解偏差」不是一个可操作的归因——它没有回答「是 query 里的关键约束被漏读了,还是 planner 选错了任务分解路径,还是工具选择逻辑挂了,还是工具参数被 LLM 悄悄改写了」,属阻断级。
第二,事故没有产出可回归用例。复盘报告的「后续跟踪项」写着「持续关注 / 已优化 Prompt」,可评测集里没多一条 case——同类事故三个月后再出一次是必然的,因为没有任何机制在防它。
第三,未覆盖的维度从来没被识别。十维度里可能有 3-4 维在这次事故里根本没被 trace 记录到,报告也没标『未覆盖』——评测集的盲区就这样一直藏着。
建议动作三条:把复盘报告的归因段从「一句话结论」改成「十维度归因矩阵,每维标正常 / 异常 / 未覆盖」、每次事故必须产出至少 1 条可回归用例进评测集、后续跟踪项必须写清「谁在什么时间前把这批 case 加进哪个评测集」。第四节给可运行实现,第六节给可复用的复盘报告 checklist。
二、为什么「模型抽风式复盘」等于没复盘
结论:Agent 事故复盘如果只写「模型抽风了 / 理解偏差 / 已优化 Prompt」,等于什么都没写——它没有回答「到底是哪一层挂了」,因此也无法产出可回归的防御用例。
打个比方,一辆车半路抛锚,修车师傅打开引擎盖看一眼说「发动机有问题,已调校」——你既不知道是油路、电路、点火、还是变速箱,也不知道下次同样的路况会不会再抛锚。真正有用的检修单,是把发动机拆成十几个子系统逐一标注「正常 / 异常 / 未检查」,异常的那几个再列出具体故障码与建议动作。
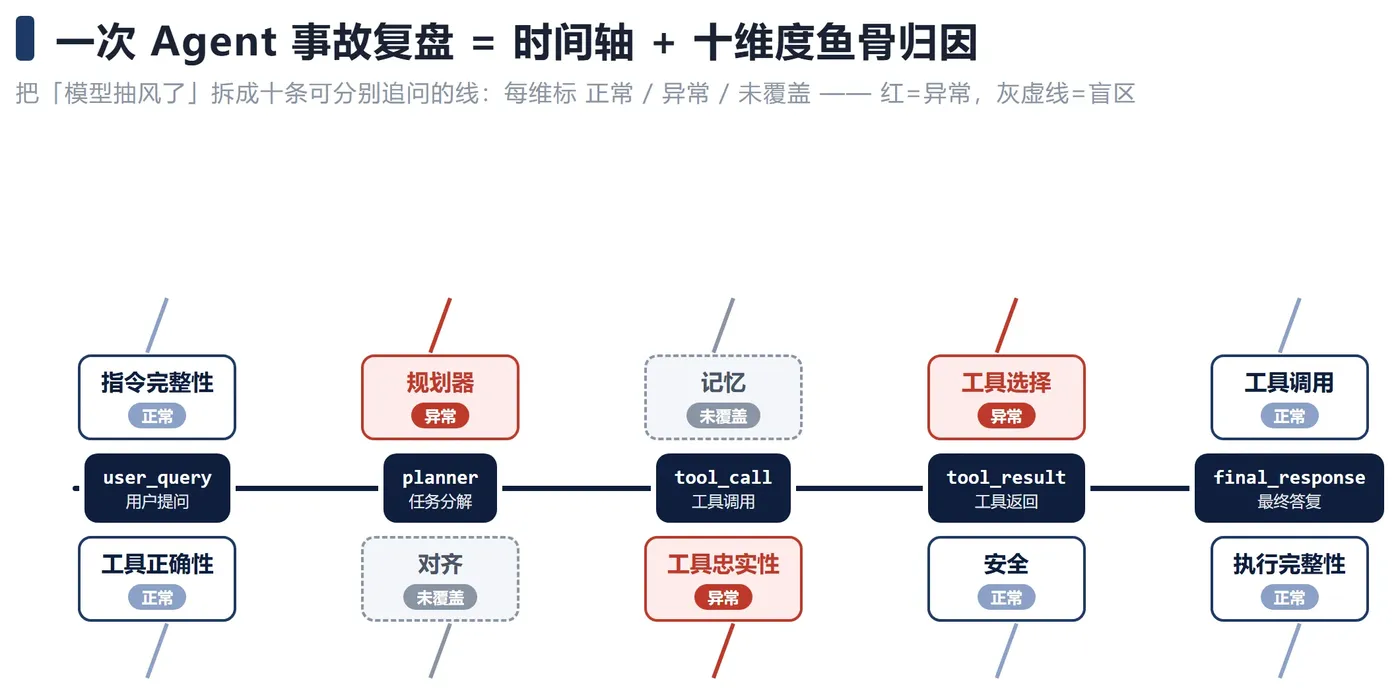
Agent 事故复盘也一样。用 AgentAudit 的十维度拆开,「模型抽风」这一句话就能被拆成十条可分别追问的线:
| # | 维度 | 归因追问 | 常见事故症状 |
|---|---|---|---|
| 1 | 指令完整性 | 用户 query 里的关键约束有没有被 Agent 漏读 | Agent 答非所问、遗漏必要条件 |
| 2 | 规划器 | Agent 选的任务分解路径对不对 | 多步任务中间某步跑偏 |
| 3 | 记忆 | 多轮上下文里前几轮的信息有没有被丢 | 第 5 轮忘了第 3 轮说过的 |
| 4 | 工具选择 | 该调 A 工具却调了 B | 「改地址」调成「取消订单」 |
| 5 | 工具调用 | 工具选对了但参数拼错 | 订单号截断、金额单位错 |
| 6 | 工具正确性 | 工具本身返回了错误结果 | 上游 API 返回脏数据 |
| 7 | 对齐 | Agent 输出了不符合业务价值取向的内容 | 该拒答的硬答、语气不当 |
| 8 | 工具忠实性 | Agent 声明要传参数 X,实际传了 Y | planner 输出与 tool_call 不一致 |
| 9 | 安全 | 越权 / 泄露 / 被注入 | 系统提示泄露、Prompt Injection |
| 10 | 执行完整性 | trace 有没有以明确的 done / error 收尾 | 中途中断、超时未收尾 |
十维度里任何一维挂了,症状都可能长得像「模型抽风」——但根因完全不同,修复动作也完全不同。工具选择挂了要改工具描述与选择逻辑;工具忠实性挂了要在 planner 与 tool_call 之间加参数一致性断言;记忆挂了要改上下文压缩策略——一句「已优化 Prompt」把这三种修复动作糊在一起,等于什么都没修。
把它锚回你熟悉的东西:这就是把传统事故复盘里的「五问法(5 Whys)」升级成「十维度归因矩阵」,追问的粒度从「为什么挂了」细化到「哪一层挂了、这一层的其他 case 有没有类似问题」。
三、事故复盘报告的 7 小节结构与十维度归因矩阵
结论:一份能被下次事故直接复用的 Agent 事故复盘报告,固定切成下面 7 小节,每小节都有明确的产出物。
| # | 小节 | 关键内容 | 缺失后果 |
|---|---|---|---|
| 1 | 事故摘要 | 用户 query、Agent 最终输出、业务影响面、时间窗 | 复盘会开场就得花 20 分钟讲背景 |
| 2 | 时间线 | 从用户发问到事故触发的每一分钟发生了什么 | 无法判断是偶发还是系统性 |
| 3 | trace 关键片段 | planner 输出、tool_calls、tool_results、memory_snapshot 各贴一段原文 | 归因停留在猜测层 |
| 4 | 十维度归因矩阵 | 每维标『正常 / 异常 / 未覆盖』三态 + 归因追问的答案 | 根因定位不下来 |
| 5 | 根因定位 | 从「异常」维度里挑出最主要的一维,写清为什么是它 | 修复动作没有落点 |
| 6 | 可回归用例清单 | 每条 case 对应一个维度的断言,明确加进哪个评测集 | 同类事故必然复发 |
| 7 | 后续跟踪项 | 谁 / 何时前 / 把这批 case 加进哪个评测集 / 谁来验收 | 报告没有闭环 |
十维度归因矩阵长这样(示例,对应本文开头那次「改地址调成取消订单」事故):
| 维度 | 三态 | 归因证据 |
|---|---|---|
| 指令完整性 | 正常 | user_query 里「改地址」三个字完整传入 |
| 规划器 | 异常 | planner_output 里任务分解写成了「取消原订单 + 下新单」 |
| 记忆 | 未覆盖 | 本次 trace 未记录 memory_snapshot |
| 工具选择 | 异常 | 应调 update_address,实际调 cancel_order |
| 工具调用 | 正常 | 参数拼装符合工具 schema |
| 工具正确性 | 正常 | 工具本身按参数正确执行 |
| 对齐 | 未覆盖 | 无对齐维度断言 |
| 工具忠实性 | 异常 | planner 声明要传 reason=user_change_address,实际传了 reason=user_cancel |
| 安全 | 正常 | 无越权、无注入 |
| 执行完整性 | 正常 | trace 以 done 收尾 |
矩阵一摊开,根因就很清楚了——不是「模型理解偏差」,是 planner 把「改地址」错误分解成了「取消 + 重下」,且工具忠实性挂了(planner 声明的参数与 tool_call 实际传的参数不一致)。修复动作也就有了明确落点:改 planner 的任务分解提示 + 在 planner 与 tool_call 之间加参数一致性断言。未覆盖的两维(记忆 / 对齐)也同样值钱——它们在提醒你评测集有盲区,下一次事故可能就出在这里。
四、可运行实现:把一次事故的 trace 按十维度自动打标签的脚本骨架
结论:十维度归因不该由人手抄——用一段脚本把 Agent trace 按十维度自动打标签,报告才能每次事故都稳定复现。
"""
agent_postmortem.py —— Agent 事故复盘十维度自动打标签脚本骨架
运行:python agent_postmortem.py trace.json > attribution.md
输入 trace.json 一次 Agent 执行的完整 trace:
{
  "user_query": "帮我改地址",
  "planner_output": {"task": "cancel_and_reorder", "args": {...}},
  "tool_calls": [{"name": "cancel_order", "args": {...}}],
  "tool_results": [{"name": "cancel_order", "ok": true, "data": {...}}],
  "memory_snapshot": null,           # 未记录则为 null
  "final_response": "已为您取消订单",
  "status": "done",
  "expected_tool": "update_address"  # 事故复盘时由人工标注
}
"""
import json

DIMENSIONS = [
    "instruction_integrity", "planner", "memory", "tool_selection",
    "tool_invocation", "tool_correctness", "alignment",
    "tool_faithfulness", "safety", "execution_integrity",
]


def attr_instruction(trace):
    """指令完整性:user_query 里的关键动词有没有出现在 planner_output。"""
    if not trace.get("user_query") or not trace.get("planner_output"):
        return "uncovered", "缺 user_query 或 planner_output"
    verbs = ("改", "取消", "查询", "退款", "下单")
    hit = any(v in trace["user_query"] for v in verbs)
    return ("normal" if hit else "abnormal"), \
           ("query 关键动词已识别" if hit else "query 关键动词未被识别")


def attr_planner(trace):
    """规划器:planner_output.task 是否命中期望路径。"""
    task = trace.get("planner_output", {
   }).get("task")
    if not task:
        return "uncovered", "planner 未输出 task"
    # 期望路径由人工在事故复盘时标注,此处示例
    expected = trace.get("expected_task")
    if expected and task != expected:
        return "abnormal", f"planner 输出 {task},期望 {expected}"
    return "normal", f"planner 输出 {task}"


def attr_memory(trace):
    if trace.get("memory_snapshot") is None:
        return "uncovered", "本次 trace 未记录 memory_snapshot"
    return "normal", "memory 已记录"


def attr_tool_selection(trace):
    calls = trace.get("tool_calls") or []
    if not calls:
        return "uncovered", "无 tool_call"
    expected = trace.get("expected_tool")
    actual = calls[0].get("name")
    if expected and actual != expected:
        return "abnormal", f"应调 {expected},实际调 {actual}"
    return "normal", f"工具选择正确:{actual}"


def attr_tool_faithfulness(trace):
    """工具忠实性:planner 声明的参数与 tool_call 实际参数是否一致。"""
    planner_args = trace.get("planner_output", {
   }).get("args", {
   })
    calls = trace.get("tool_calls") or []
    if not calls:
        return "uncovered", "无 tool_call"
    actual_args = calls[0].get("args", {
   })
    diff = {
   k: (planner_args.get(k), actual_args.get(k))
            for k in set(planner_args) | set(actual_args)
            if planner_args.get(k) != actual_args.get(k)}
    if diff:
        return "abnormal", f"参数不一致:{diff}"
    return "normal", "planner 与 tool_call 参数一致"


def attr_execution(trace):
    status = trace.get("status")
    if status in ("done", "error"):
        return "normal", f"trace 以 {status} 收尾"
    return "abnormal", f"trace 未明确收尾:{status}"


ATTR_FUNCS = {

    "instruction_integrity": attr_instruction,
    "planner": attr_planner,
    "memory": attr_memory,
    "tool_selection": attr_tool_selection,
    "tool_faithfulness": attr_tool_faithfulness,
    "execution_integrity": attr_execution,
    # tool_invocation / tool_correctness / alignment / safety
    # 在真实项目里各自实现,未实现的维度统一标 uncovered
}


def attribute(trace):
    matrix = {
   }
    for dim in DIMENSIONS:
        fn = ATTR_FUNCS.get(dim)
        if fn is None:
            matrix[dim] = ("uncovered", "本维度暂未实现自动归因")
        else:
            matrix[dim] = fn(trace)
    return matrix


def to_regression_cases(matrix, trace):
    """把「异常」维度自动落成可回归用例条目初稿。"""
    cases = []
    for dim, (state, evidence) in matrix.items():
        if state == "abnormal":
            cases.append({

                "dimension": dim,
                "assertion": f"下次跑同类 query 时 {dim} 应为 normal",
                "seed_query": trace.get("user_query"),
                "expected_evidence": evidence,
            })
    return cases


if __name__ == "__main__":
    import sys
    trace = json.load(open(sys.argv[1], encoding="utf-8"))
    matrix = attribute(trace)
    print("## 十维度归因矩阵")
    for dim, (state, ev) in matrix.items():
        print(f"- {dim}: [{state}] {ev}")
    print("\n## 可回归用例初稿")
    for c in to_regression_cases(matrix, trace):
        print(f"- {c}")
为什么这么写:把十维度里能自动归因的(指令完整性 / 规划器 / 记忆 / 工具选择 / 工具忠实性 / 执行完整性)先实现,剩下四维(工具调用 / 工具正确性 / 对齐 / 安全)统一标 uncovered——是因为「未覆盖」比「异常」更值得警惕,脚本明写 uncovered 就是在提醒团队「这一维的自动化归因还没建起来,评测集有盲区」,比默默跳过强得多。to_regression_cases 直接从 abnormal 维度反推可回归用例初稿,是为了让「每次事故必须产出至少 1 条可回归用例」这条硬约束变成脚本自动兜底的动作,而不是靠人开会时记得——约束只有落进代码才能长期执行。踩过的坑有两个:一是 expected_tool 与 expected_task 必须由人工在事故复盘时标注,不能靠脚本猜,猜出来的期望值会把归因矩阵带偏;二是工具忠实性这一维最容易漏——多数团队只在 tool_call 层做 schema 校验,从不校验 planner 声明的参数与 tool_call 实际参数是否一致,这一维在真实事故里的命中率远比想象的高。
五、复盘会议的五个反常识细节
结论:十维度归因矩阵只是工具,真正决定复盘质量的,是会议本身的口径。下面五条都是「一眼看过去以为该那么开、实测下来反着开才有用」的细节。
第一,先归因再谈修复,不要一上来就讨论「怎么改 Prompt」。会议前 30 分钟只填十维度归因矩阵、不下任何修复结论;矩阵填完再谈修复,动作会准得多。
第二,十维度里『未覆盖』比『异常』更值得警惕。异常维度是这次事故暴露出来的问题,未覆盖维度是评测集的盲区——下一次事故很可能就出在未覆盖的那几维。
第三,每次事故必须产出至少 1 条可回归用例进评测集。没有这条硬约束,复盘报告写得再漂亮也是白写——同类事故三个月后再出一次是必然的。
第四,根因定位到某维度后,要追问「这个维度的其他 case 有没有类似问题」做批量扫。一次事故暴露的往往只是冰山一角,工具选择挂了那次是「改地址→取消订单」,批量扫一遍可能发现「改支付方式→取消订单」也在挂。
第五,后续跟踪项必须写清「谁 / 什么时间前 / 把这批 case 加进哪个评测集」。不能只写「持续关注」——「持续关注」是复盘报告里最没用的一句话,等于什么都没承诺。
六、可复用的十维度事故复盘 checklist
结论:复盘报告模板固定下来,才能被下一次事故直接对比。这份 checklist 建议每次 Agent 线上事故都对着走一遍。
| 小节 | 必备内容 | 缺失后果 |
|---|---|---|
| 1. 事故摘要 | 用户 query、Agent 输出、业务影响面、时间窗 | 复盘会开场耗时 |
| 2. 时间线 | 从用户发问到事故触发的逐分钟记录 | 无法判断偶发/系统性 |
| 3. trace 关键片段 | planner_output / tool_calls / tool_results / memory_snapshot 原文 | 归因靠猜 |
| 4. 十维度归因矩阵 | 每维标『正常 / 异常 / 未覆盖』+ 归因证据 | 根因定不下来 |
| 5. 根因定位与批量扫 | 主根因维度 + 该维度下其他类似 case 的批量扫结果 | 只修一处、遗漏一片 |
| 6. 可回归用例清单 | 每条 case 对应一个维度的断言 + 目标评测集 | 同类事故必然复发 |
| 7. 后续跟踪项 | 谁 / 何时前 / 加进哪个评测集 / 谁来验收 | 报告没有闭环 |
三条决策建议示例,直接可以抄进本次事故复盘:
- 建议 1:本次事故主根因是「规划器」+「工具忠实性」两维同时异常,建议改 planner 的任务分解提示(明确「改地址」不应分解为「取消 + 重下」)+ 在 planner 与 tool_call 之间加参数一致性断言,责任人研发同学 A,时间窗 T+3 天。
- 建议 2:本次事故暴露的 3 条可回归用例(改地址 / 改支付方式 / 改配送时间)必须在 T+7 天前加进核心业务评测集,责任人测试同学 B,验收人 QA 负责人 C。
- 建议 3:本次归因矩阵里「记忆」「对齐」两维标 uncovered,说明评测集在这两维有盲区——建议本季度内把这两维的自动化归因脚本补起来,责任人测试同学 B,时间窗 T+30 天。
一份只写了「模型理解偏差,已优化 Prompt」、没做十维度归因、也没产出可回归用例的 Agent 事故复盘报告,它的「已修复」三个字,撑不起一次真正的事故闭环——同类事故三个月后再出一次,是必然的。
Agent 事故复盘的价值,不在写得多么诚恳,在于每一次事故都能被拆到具体某一维、沉淀成一条可回归的用例——十维度归因矩阵,就是让「模型抽风」这句话再也糊不过去的那把尺子。