
DeepSeek官方正式落地Flash系列调价方案,deepseek-v4-flash、deepseek-v4-flash-vision-exp两款模型同步执行新定价,空闲时段缓存命中输入单价直接降至0.02元/百万Token,缓存命中项最高降幅达到60%,未命中输入、输出价格同步下调。整套缓存机制无需开发者改动接口、无需新增特殊参数,系统自动识别并计费,对于多轮对话、固定系统提示词、知识库检索增强场景,降本效果极其显著。
本文完整解析调价明细、峰谷计费规则、上下文缓存底层原理,附带curl、Python可直接运行调用代码,提供成本测算脚本,梳理缓存命中优化策略、适用业务场景与高频故障排查,帮助开发者在Agent、RAG、代码助手项目中最大化降低API调用成本。
一、调价明细与峰谷计费完整规则
新定价于北京时间9月10日12点正式生效,采用峰谷分时计费模式,高峰时段价格为空闲时段两倍。
高峰时段:工作日周一至周五 9:00-12:00,14:00-18:00;其余全部时间为空闲时段。
调价前后价格对比(单位:元/百万Token)
空闲时段旧价:缓存命中0.05,缓存未命中1.5,输出4.5;
空闲时段新价:缓存命中0.02,缓存未命中1,输出4;
降幅:缓存命中输入降幅60%,缓存未命中输入降幅约33.3%,输出降幅约11.1%。
高峰时段新定价:缓存命中0.04,缓存未命中2,输出8。
计费口径说明:
- 缓存命中输入Token:当请求输入前缀内容和历史请求完全一致,系统复用上下文缓存,无需重新做完整推理计算,这部分Token按照极低的缓存单价计费,也就是0.02元/百万Token(闲时)。缓存匹配要求从文本最开头前缀完全一致,中间片段重复不会触发缓存命中。
- 缓存未命中输入Token:全新文本、新增的对话内容、前缀发生变更,这部分输入需要完整推理,按照正常输入单价计费。
- 输出Token:模型新生成的回答内容,不存在缓存机制,统一按输出单价计费。详情👉访问阿里云百炼大模型服务平台页面 了解。
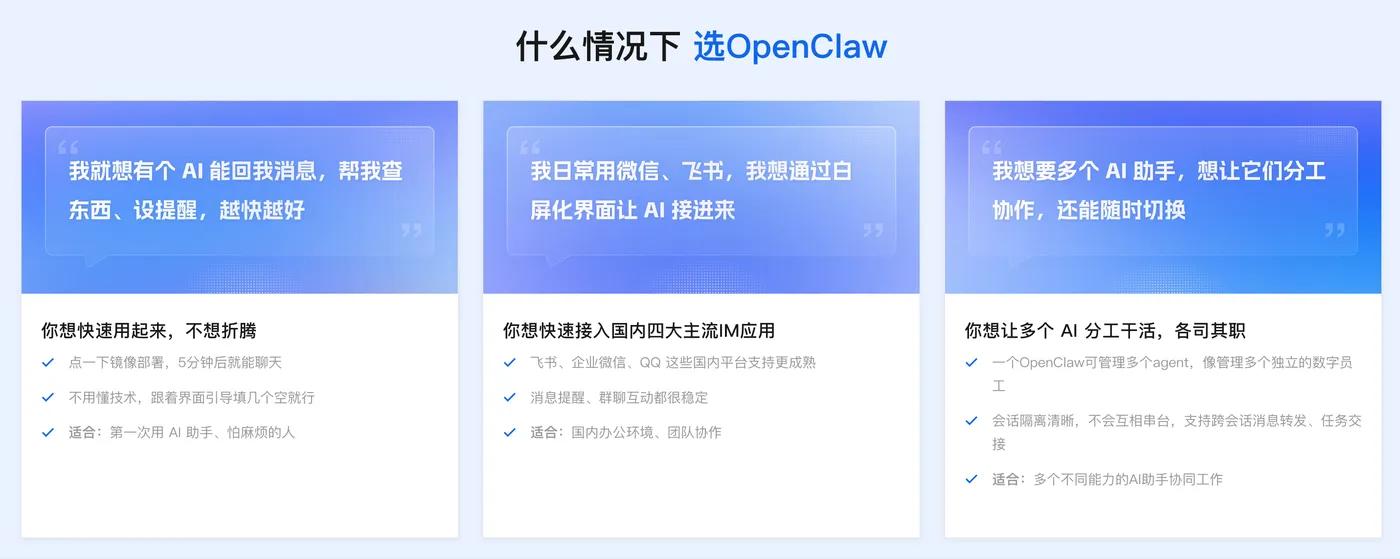
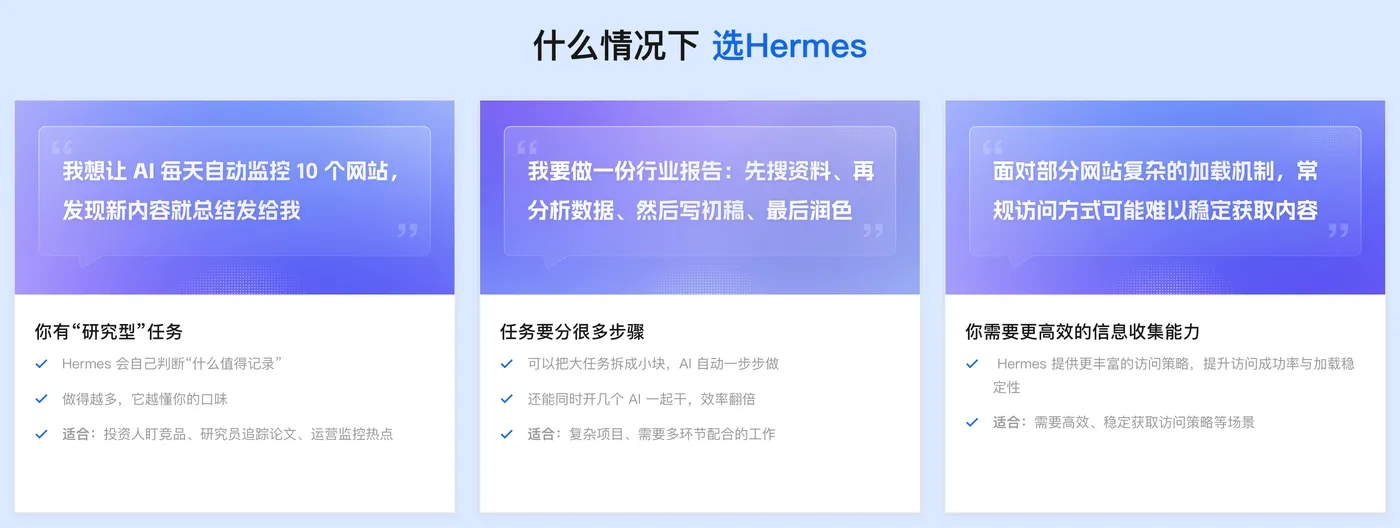
核心提示:缓存功能自动开启,不需要修改API接口地址,不需要新增请求参数,原有业务代码直接复用,平台后台自动统计命中、未命中Token用量,账单自动区分两类输入费用。适合Hermes Agent、OpenClaw、DeepSeek Harness这类多轮智能体项目,这类工具每轮对话都会携带完整历史上下文,是缓存降价最大受益场景。
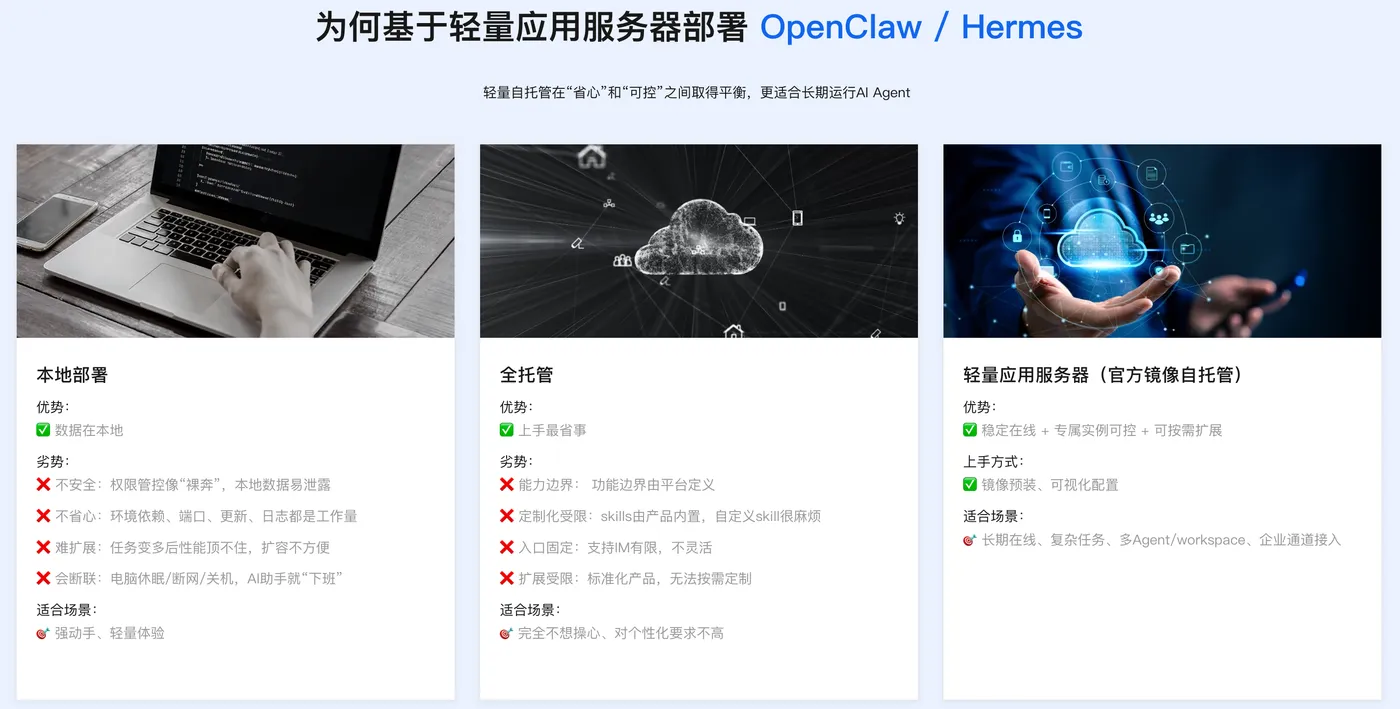
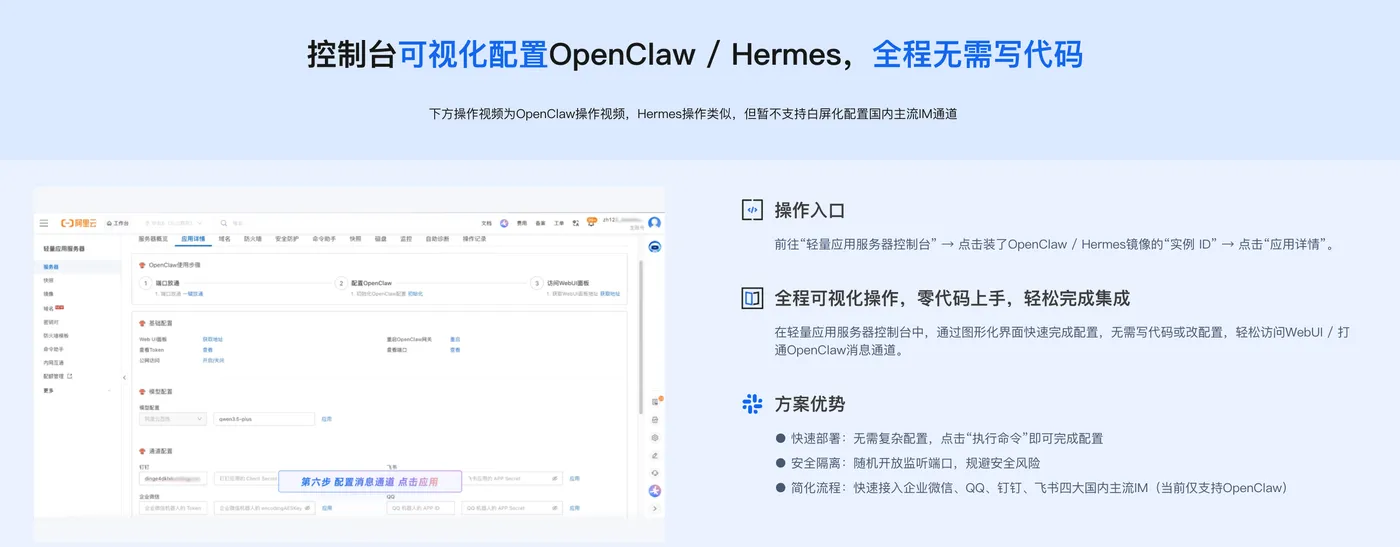
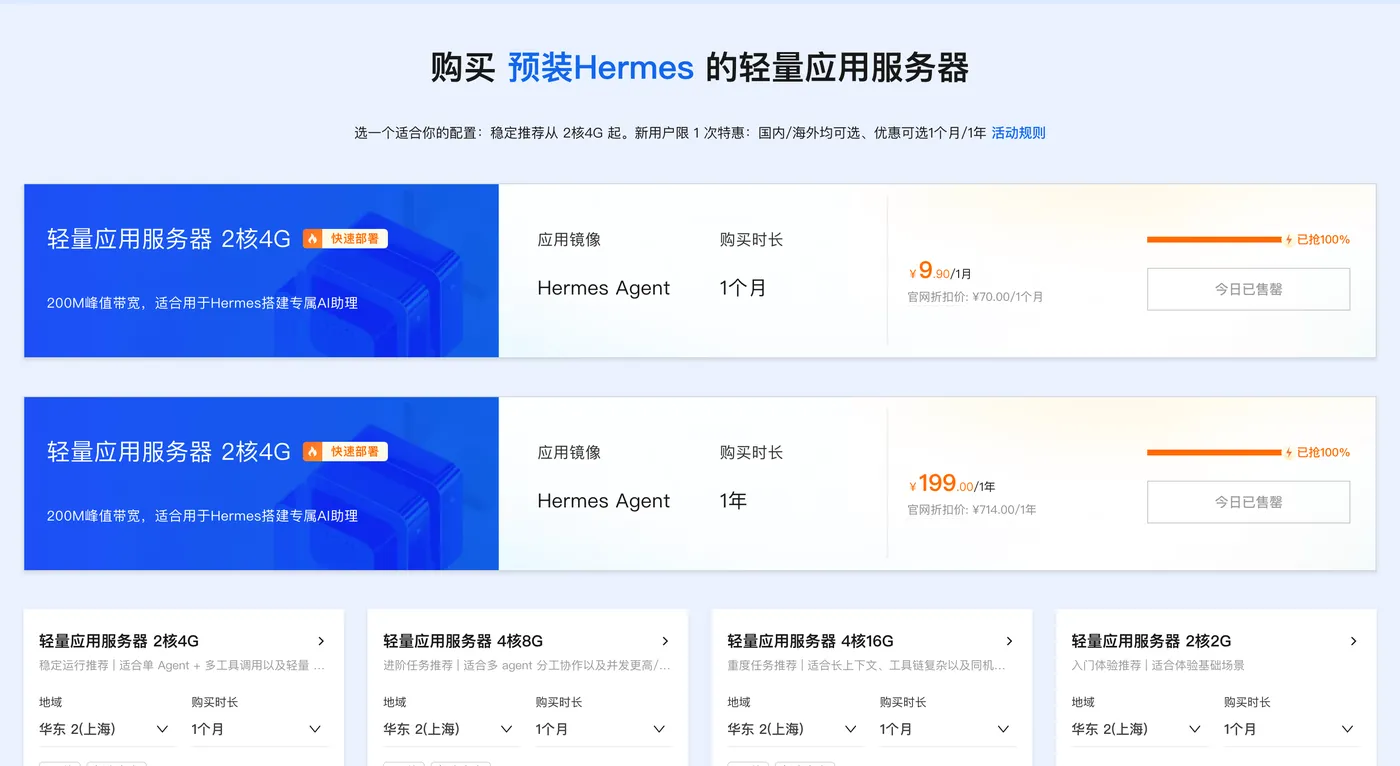
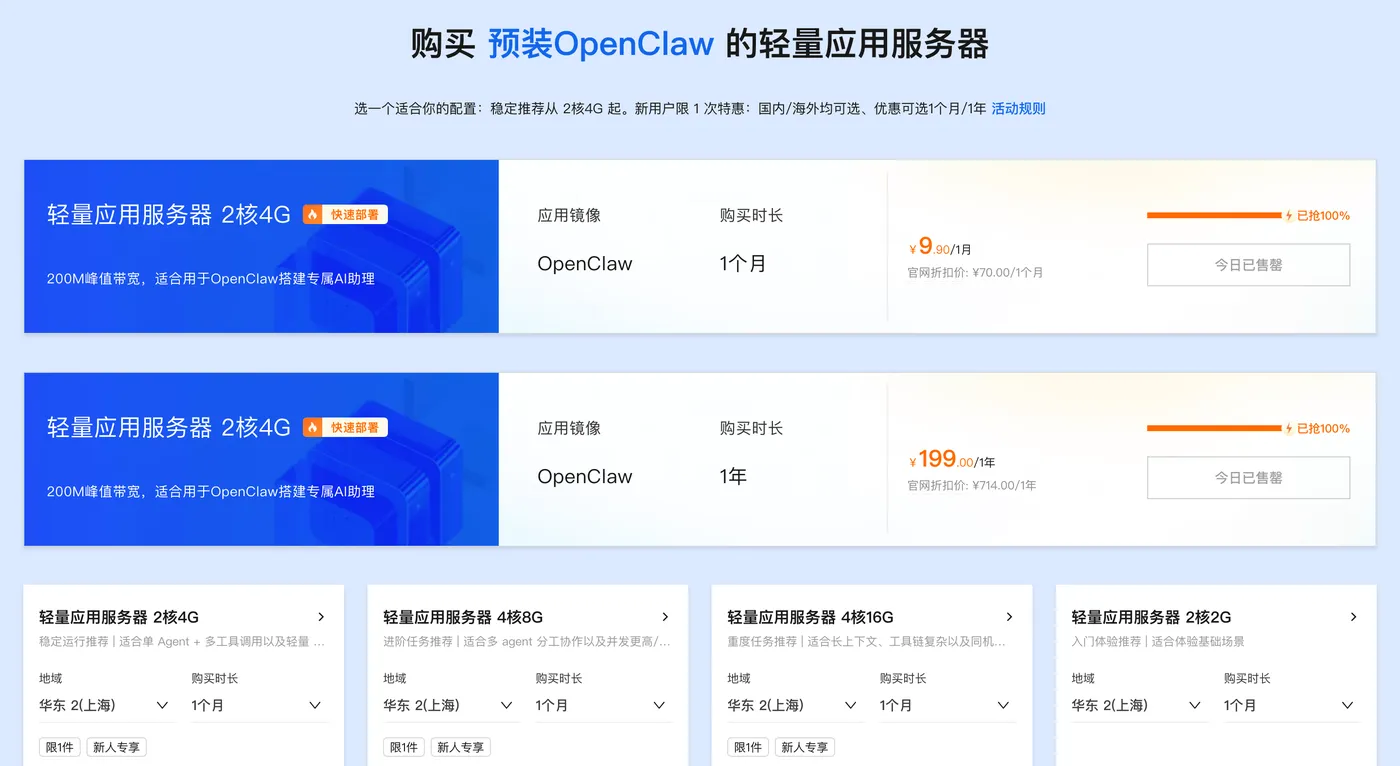
阿里云部署AI Agent:OpenClaw/Hermes Agent全网最简单,只需两步,详情👉访问阿里云OpenClaw/Hermes一键部署专题页面了解。
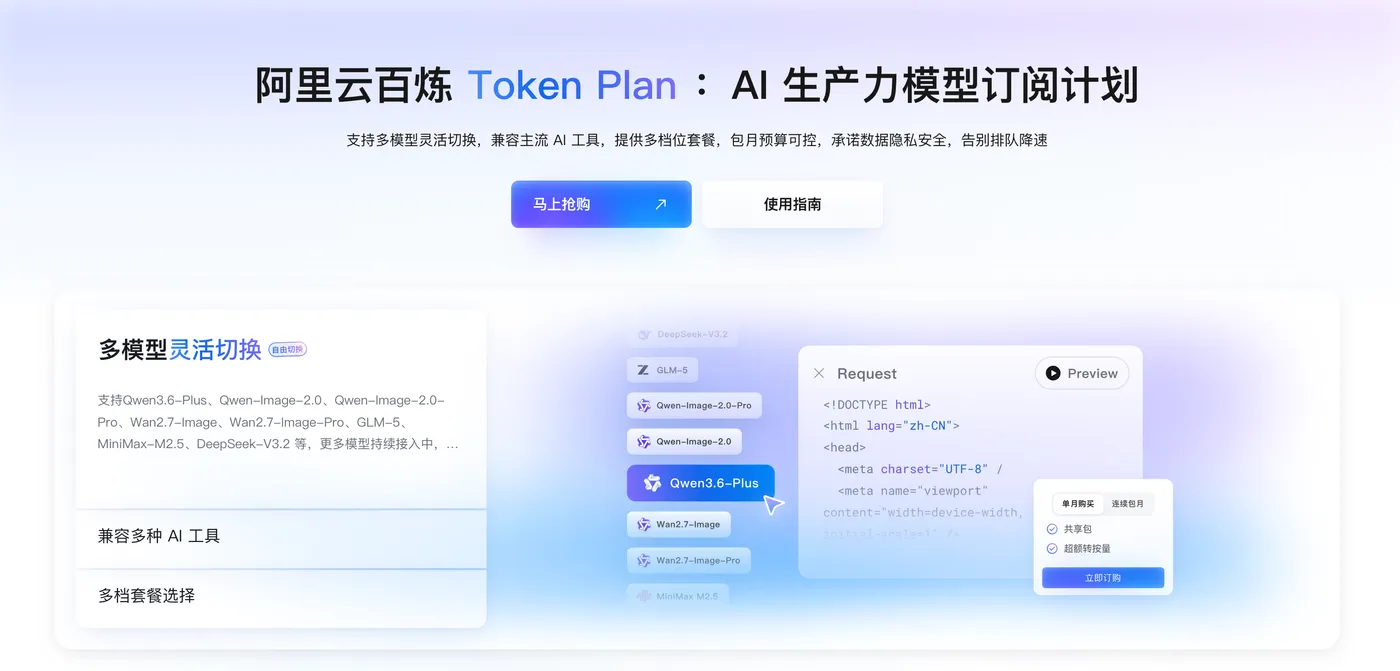
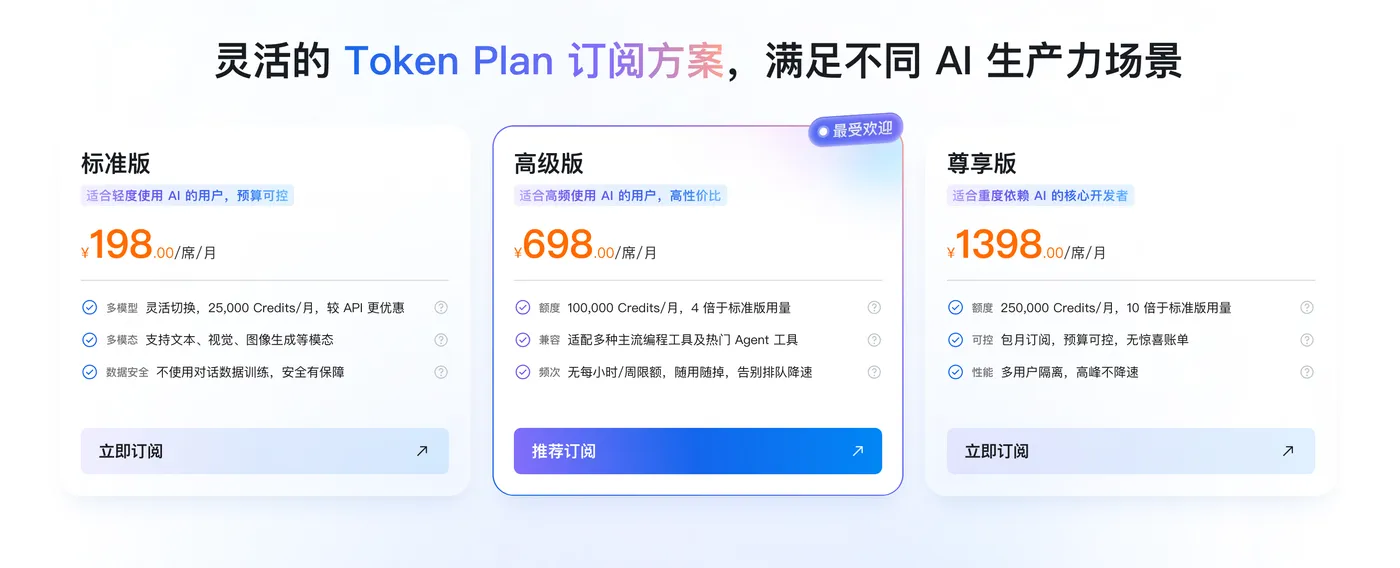
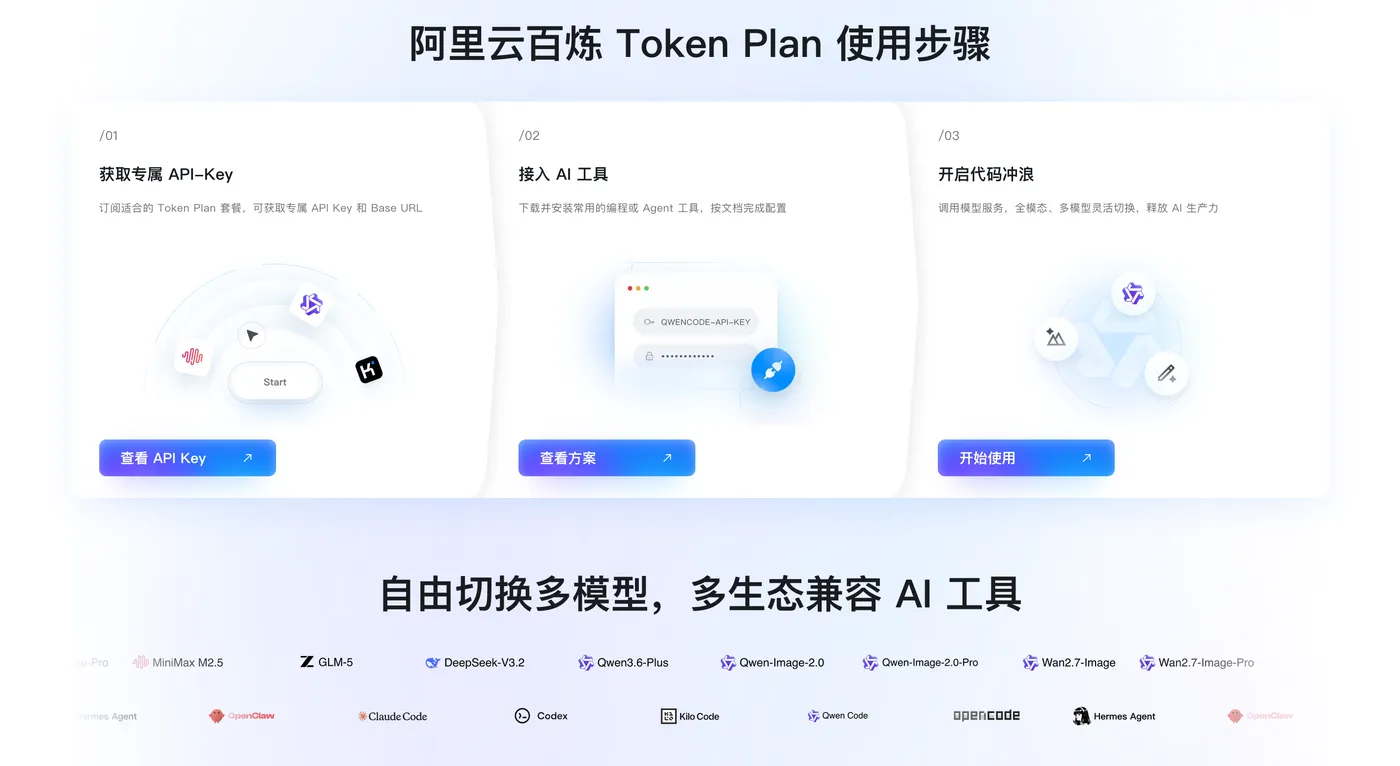
Token Plan Token 最便宜/支持多模型切换:👉访问订阅阿里云百炼Token Plan AI大模型服务 。支持多模型切换,用于多模态模型灵活调用,实现多模型、多工具、多场景下的额度共享与统一管理,兼顾灵活性、稳定性与安全性,大幅降低企业使用大模型的门槛与成本。二、上下文缓存底层原理,什么样的场景能拿到0.02元低价
很多开发者会误解缓存机制,认为只要内容重复就会触发缓存优惠,实际匹配规则有明确限制。DeepSeek采用分布式磁盘上下文缓存技术,会缓存请求消息列表的前缀文本。
举一个典型Agent对话流程:
第一轮请求:system系统提示词 + 用户问题A → 全部是新内容,缓存未命中。
第二轮请求:system系统提示词 + 第一轮完整对话历史 + 用户新问题B。
这里system提示词和第一轮历史对话属于请求前缀,和上一轮请求前缀完全一致,这部分大量Token会触发缓存命中,按0.02元计费;仅新增用户问题B属于未命中输入。详情👉访问阿里云百炼大模型服务平台页面 了解。
最适合发挥缓存降价优势场景:
- Agent智能体项目:固定system角色提示词,持续多轮交互,反复携带历史对话;
- RAG知识库问答:固定角色指令,每次请求附带知识库文档片段,文档内容长期不变;
- 代码助手:固定的代码评审、代码生成系统prompt,连续多轮调试代码;
- 批量文档处理:使用同一套固定前置指令,循环解析多篇文档。
收益有限场景:每次用户提问完全独立,请求前缀每次全部更换,没有固定system提示词,无法命中缓存,只能享受输入、输出基础降价。
三、API环境准备,配置密钥环境变量
调用前准备DeepSeek API Key,密钥以sk开头,OpenAI兼容接口地址:https://api.deepseek.com/v1。
Linux/macOS终端配置环境变量:
export DEEPSEEK_API_KEY="sk-替换为你的API密钥"
echo $DEEPSEEK_API_KEY
Windows PowerShell环境变量配置:
$env:DEEPSEEK_API_KEY="sk-替换为你的API密钥"
Python依赖安装:
pip install openai --upgrade
四、完整API调用代码示例,自动缓存生效
示例1:curl调用deepseek-v4-flash多轮对话,自动触发上下文缓存
curl https://api.deepseek.com/v1/chat/completions \
-H "Authorization: Bearer $DEEPSEEK_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model":"deepseek-v4-flash",
"messages":[
{"role":"system","content":"你是专业Python代码审计专家,检查代码漏洞,输出修改建议,输出简洁规范"},
{"role":"user","content":"分析下面Python代码安全风险:def login(user,pwd):return user==pwd"}
],
"temperature":0.6,
"max_tokens":2048
}'
再次发起第二轮对话,携带完整历史消息,前缀一致,自动命中缓存:
curl https://api.deepseek.com/v1/chat/completions \
-H "Authorization: Bearer $DEEPSEEK_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model":"deepseek-v4-flash",
"messages":[
{"role":"system","content":"你是专业Python代码审计专家,检查代码漏洞,输出修改建议,输出简洁规范"},
{"role":"user","content":"分析下面Python代码安全风险:def login(user,pwd):return user==pwd"},
{"role":"assistant","content":"该代码存在明文密码比对漏洞,容易被暴力破解。"},
{"role":"user","content":"请写出优化后的安全代码"}
],
"temperature":0.6,
"max_tokens":2048
}'
示例2:Python多轮对话,查看usage返回缓存统计数据
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get("DEEPSEEK_API_KEY"),
    base_url="https://api.deepseek.com/v1"
)

# 固定系统提示词,长文本,用于触发上下文缓存
SYSTEM_PROMPT = """你是企业内部RAG文档分析助手,严格根据参考文档回答用户问题,
禁止编造文档不存在的信息,回答引用文档段落来源,输出markdown格式。
如果文档没有对应信息,直接告知用户无法回答。"""

def chat_with_cache(user_message: str, history_messages: list):
    messages = [{
   "role":"system","content":SYSTEM_PROMPT}]
    messages.extend(history_messages)
    messages.append({
   "role":"user","content":user_message})
    resp = client.chat.completions.create(
        model="deepseek-v4-flash",
        messages=messages,
        temperature=0.7,
        max_tokens=4096
    )
    usage_info = resp.usage
    print("====Token用量统计====")
    print(f"缓存命中输入token:{usage_info.prompt_cache_hit_tokens}")
    print(f"缓存未命中输入token:{usage_info.prompt_cache_miss_tokens}")
    print(f"输出token:{usage_info.completion_tokens}")
    return resp.choices[0].message.content, messages

if __name__ == "__main__":
    history = []
    res1, history = chat_with_cache("请总结文档核心要点", history)
    print("第一轮回答:",res1)
    res2, history = chat_with_cache("提炼文档风险点", history)
    print("第二轮回答:",res2)
代码执行之后,返回的usage对象会返回prompt_cache_hit_tokens和prompt_cache_miss_tokens,可以实时观测缓存命中数量,评估降本效果。
示例3:Python成本测算脚本,自动预估调用费用
def calc_deepseek_cost(cache_hit_token:int, cache_miss_token:int, output_token:int,is_peak:bool=False):
    # 新定价,单位:元/百万token
    if is_peak:
        cache_hit_price = 0.04
        cache_miss_price = 2
        output_price = 8
    else:
        cache_hit_price = 0.02
        cache_miss_price = 1
        output_price = 4
    cost_hit = cache_hit_token / 1000000 * cache_hit_price
    cost_miss = cache_miss_token / 1000000 * cache_miss_price
    cost_output = output_token / 1000000 * output_price
    total = cost_hit + cost_miss + cost_output
    return {

        "cache_hit_cost":cost_hit,
        "cache_miss_cost":cost_miss,
        "output_cost":cost_output,
        "total_cost":total
    }

if __name__ == "__main__":
    # 模拟一次Agent调用,缓存命中90万token,未命中10万token,输出2万token,闲时调用
    result = calc_deepseek_cost(900000,100000,20000,is_peak=False)
    print(f"缓存命中费用:{result['cache_hit_cost']:.4f}元")
    print(f"缓存未命中费用:{result['cache_miss_cost']:.4f}元")
    print(f"输出费用:{result['output_cost']:.4f}元")
    print(f"本次总费用:{result['total_cost']:.4f}元")
运行脚本可以提前预估每轮对话费用,用来做项目预算评估、用量告警阈值设置。
五、Agent工具接入缓存优化配置(Hermes、OpenClaw、DeepSeek Harness)
主流Agent框架默认会完整携带历史对话,天然适配上下文缓存,只需要将模型切换为deepseek-v4-flash,无需额外修改代码。
Hermes Agent配置命令:
export LLM_BASE_URL="https://api.deepseek.com/v1"
export LLM_API_KEY="$DEEPSEEK_API_KEY"
hermes config set model.provider openai
hermes config set model.base_url $LLM_BASE_URL
hermes config set model.api_key $LLM_API_KEY
hermes config set model.default deepseek-v4-flash
hermes --tui
OpenClaw配置命令:
openclaw onboard --auth-choice openai-api-key
openclaw config llm set endpoint https://api.deepseek.com/v1
openclaw config llm set key $DEEPSEEK_API_KEY
openclaw config llm set model deepseek-v4-flash
openclaw models list
DeepSeek Harness在WebUI模型管理添加deepseek-v4-flash,开启多模态支持(vision-exp版本),系统自动使用上下文缓存。
六、最大化缓存命中率的工程优化策略
- 固定system提示词放在消息列表最前面,不要动态修改system内容,一旦system前缀变更,缓存直接失效,所有输入全部变为未命中计费。
- RAG知识库场景,把长期不变的知识库文档片段放置在消息前缀,用户动态问题放在末尾,最大化前缀复用。
- 会话隔离,同一个用户对话维持独立messages列表,不要频繁截断历史上下文;过早截断会丢失缓存前缀。
- 批量任务尽量闲时执行,闲时缓存单价0.02,高峰时段翻倍,大批量RAG文档解析、批量代码评审任务安排到非高峰时段,进一步降低成本。
- 监控缓存命中指标:业务代码读取usage中的
prompt_cache_hit_tokens,增加告警。如果缓存命中率持续偏低,排查是否每次请求前缀频繁变动。 - 区分模型选型:长对话、多轮Agent、RAG优先选择Flash系列;复杂深度推理、数学、硬核代码生成场景选择Pro版本。
七、常见问题与故障排查
账单没有出现缓存命中用量,缓存命中率为0
检查每次请求messages列表的前缀内容是否每次都发生改动。system提示词、前置文档内容一旦修改,前缀不一致,无法命中缓存。缓存只匹配从0位置开始的完整前缀,中间片段重复无效。高峰闲时价格区分,如何确认当前时段
高峰时段固定工作日9:00-12:00,14:00-18:00,其余为闲时,计费由服务端自动识别,开发者无需在代码标记时段。大批量任务尽量调度在闲时执行。升级SDK查看prompt_cache_hit_tokens字段,返回不存在
旧版本openai SDK不支持读取usage新增缓存字段,执行升级命令:pip install openai --upgradeAgent调用后,发现费用下降不明显
大概率是业务场景输出Token占比很高,缓存优化只针对输入部分,输出Token没有缓存优惠。如果业务以全新生成内容为主,降本幅度有限;长上下文多轮对话场景收益最高。缓存会不会永久保存上下文,存在数据安全风险
缓存为临时存储,会按照平台策略自动过期,不会永久保存用户业务数据,敏感业务仍然建议做好输入内容脱敏。deepseek-v4-flash和deepseek-v4-flash-vision-exp定价完全一致
vision版本额外支持图片多模态输入,缓存计费规则和纯文本Flash完全相同,多模态图片内容不计入上下文缓存,图片部分全部按未命中输入计费。
八、业务选型与成本评估建议
✅优先选用DeepSeek Flash调价后版本场景:
- AI Agent智能体,多轮持续对话,固定角色系统提示词;
- RAG知识库问答,大量静态参考文档,每次请求重复携带;
- 代码助手、批量文档摘要、合同审阅,固定前置指令循环调用;
- 中小流量线上业务,希望控制大模型API成本,同时保持推理速度。
❌不适合Flash场景:
- 单次独立提问,无任何上下文复用,每次请求全部内容全新;
- 超复杂数学推理、深度逻辑推演、长代码工程构建,推荐Pro版本;
- 超大并发压测,Flash有并发上限,压测会触发429限流报错。
落地实施建议:
第一步,在测试环境接入deepseek-v4-flash,接入成本统计代码,观测缓存命中率;第二步,优化提示词结构,固定system前缀,提升命中比例;第三步,调度大批量任务至闲时运行;第四步,设置用量告警,监控账单,防止用量突增;第五步,评估业务效果,如果推理能力无法满足需求,再切换Pro版本。详情👉访问阿里云百炼大模型服务平台页面 了解。
总结
DeepSeek Flash系列调价落地,空闲时段缓存输入价格降至0.02元/百万Token,最高降幅60%,极大降低了长上下文、Agent、RAG这类场景的输入成本。这套上下文缓存技术自动生效,业务代码无需改动,只要保持请求消息列表前缀一致,就可以自动触发缓存优惠。
调价之后,峰谷两套定价并行,闲时调用成本优势更突出。对于Hermes Agent、OpenClaw、DeepSeek Harness等智能体项目,这类工具天然携带完整多轮对话历史,是本次降价最大受益者。开发者只需要在代码中读取usage缓存统计字段,持续监控命中率,配合提示词工程优化,就能把长对话场景的API开销压缩到极低水平。
同时要明确边界:缓存优惠只针对输入前缀重复文本,模型生成输出部分不享受缓存折扣;多模态图片输入内容不参与缓存匹配。业务选型上,长对话知识库、智能体优先Flash,重度复杂推理场景选择Pro,结合峰谷时段调度,实现性能与成本的最佳平衡。


