9 月 20 日,阿里 Qwen 团队开源了 Qwen-Image-2.1。上一代 Qwen-Image 是 20B,这一代的图像生成部分缩到了 7B,还把原来单独发布的编辑模型合了进来:一个模型同时管文生图和改图,能直接出带透明通道的 PNG,一次最多吃 10 张参考图,默认输出 2K。在 Qwen 自家的 Qwen-Image-Bench 上,它拿了 60.28 分,高于 Nano Banana 2.0 的 59.82,也排在榜上所有开放权重模型前面。第三方的 GenAI Showdown 文生图测试里,它拿到 7/15,上一代 Qwen-Image 1.0 是 4/15。
需要说明的是,Qwen-Image-Bench 是 Qwen 自己的榜,榜上还有 6 个闭源模型分数更高,最高的 GPT Image 2.5 Sunburst 是 67.01。
模型确实强,很多人的第一个问题是:手里这张 16G 显卡能不能跑?答案是能,但有条件。下面把账算清楚。
1、7B 只是一半
很多地方把 Qwen-Image-2.1 叫做“7B 模型”,这个说法容易让人低估它的体量。
7B 指的只是负责画图的 DiT 部分。整条流程还要加载一个 Qwen3-VL 8B 文本编码器,负责把提示词和参考图变成模型能用的条件;再加一个 VAE,负责把潜空间结果还原成像素。显存里跑的不是一个 7B 模型,而是两个大模型加一个小组件。
OpenClaw 在 9 月 23 日通过 Hugging Face API 读取了 Comfy-Org 发布的文件表,各部分大小如下:
| 组件 | 格式 | 文件大小 |
|---|---|---|
| DiT 图像模型 | BF16 | 14.23 GB |
| DiT 图像模型 | INT8 ConvRot | 7.26 GB |
| 文本编码器 Qwen3-VL 8B | BF16 | 17.53 GB |
| 文本编码器 Qwen3-VL 8B | INT8 ConvRot | 9.35 GB |
| VAE | BF16 | 0.68 GB |
BF16 下,文本编码器 17.53 GB,比图像模型还大 23%。三样加起来是 32.44 GB。
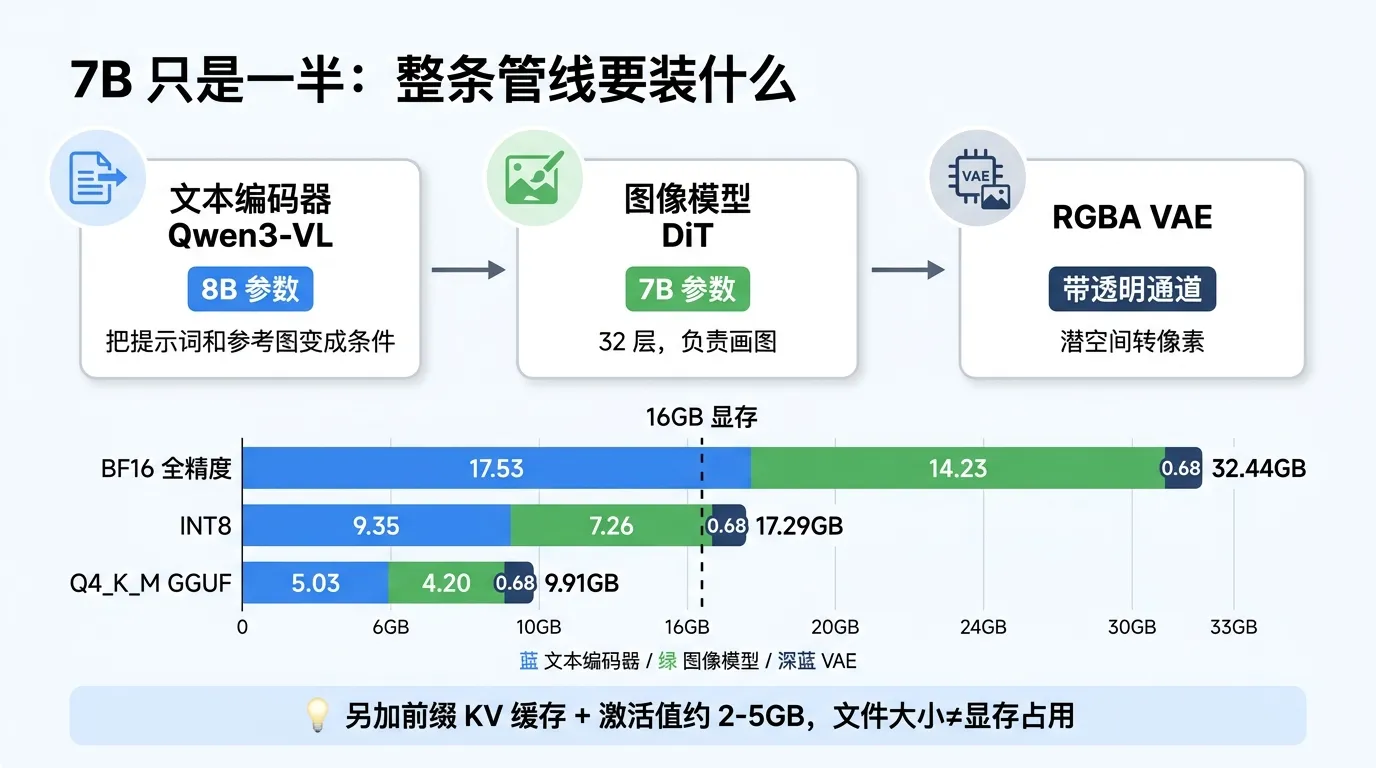
所以只按 7B 估算显存会出错。Spheron 的 GPU 推荐页写的是“约 16GB 显存可跑”,它只按 7.1B 参数算,没有算编码器。16G 卡用户照这个数字准备,启动时很可能直接爆显存。
还有一笔容易漏掉的开销:前缀 KV 缓存。
这个模型的提速思路是,把文本和参考图只在第一步计算一次,后面每个去噪步都复用这份结果,参考图越多省得越多。代价是这份缓存要占内存。按 stable-diffusion.cpp 文档的说法,一个 4096 token 的前缀在 FP32 下约占 4 GiB,而且每个条件各一份;CFG 大于 1 时,正负提示词各有一份。
参考图也会占显存。有人在 RTX 5090 上用 8-bit 跑,1024×1024 文生图峰值约 21.3 GB,加两张参考图做编辑,峰值涨到 25.6 GB。
2、16G 能走的几条路
先说结论:16G 能跑,但这里的“能跑”指的是 1024×1024。原生 2K 是另一回事。
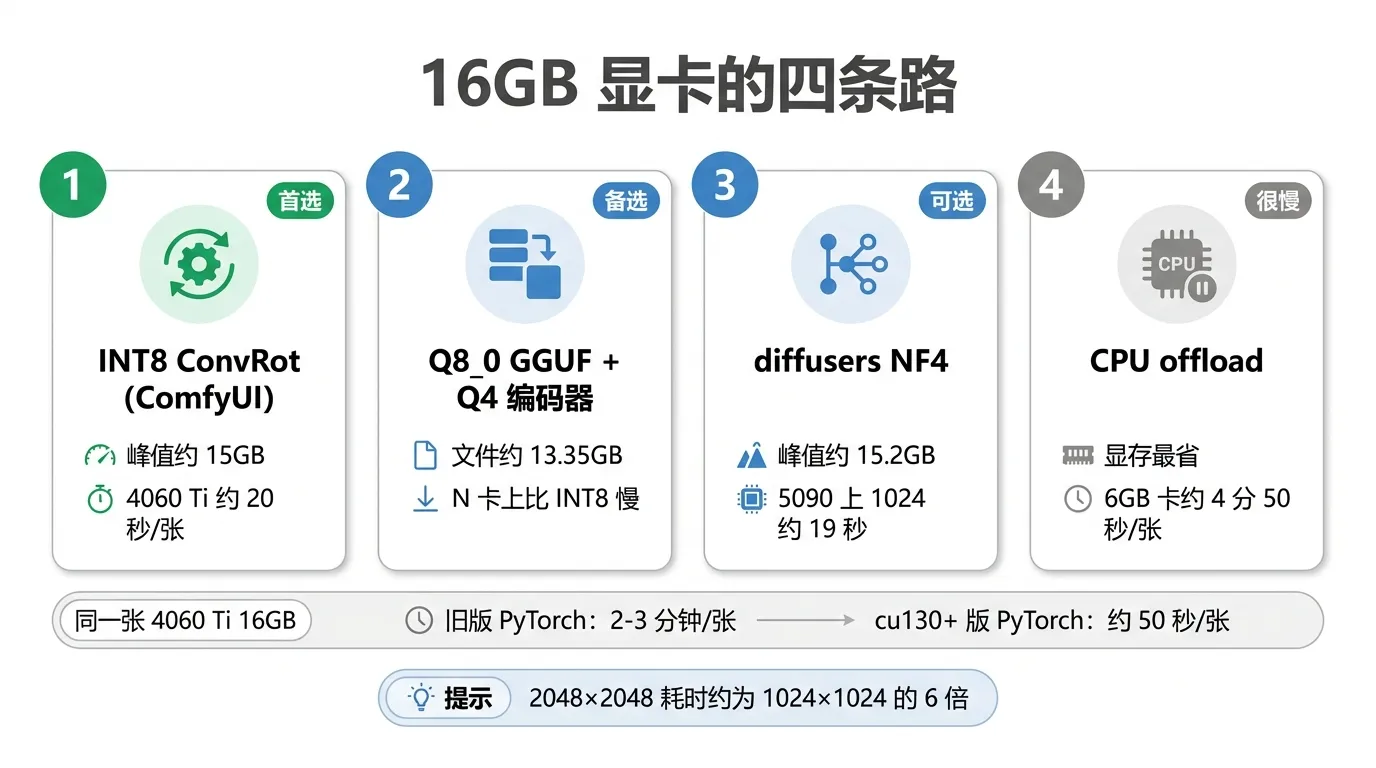
首选是 ComfyUI 的 INT8 ConvRot。 Hugging Face 讨论区有位 RTX 4060 Ti 16GB 用户报告:INT8 图像模型加 INT8 编码器加 BF16 VAE,没开 CPU offload,峰值显存约 15 GB,平时在 13 到 14 GB。单张图约 20 秒,多图编辑约 1 分钟。原帖没写分辨率和步数,速度只能当参考。
有个细节:INT8 这套文件加起来 17.29 GB,峰值却只有约 15 GB。OpenClaw 的推断是,ComfyUI 先跑文本编码器,再加载图像模型,两者不会同时完整地留在显存里。这是 OpenClaw 的推断,原帖作者没有这么说。
另一位用户用 RTX 5070 Ti 16GB 跑 1024×1024、20 步,约 25 秒一张,峰值 13.9 GB。他没说用的什么精度,但显存和速度与 4060 Ti 那条报告在同一个量级。
也有跑得很慢的例子。Reddit 上一位 4060 Ti 16GB 用户,用 INT8 ConvRot 图像模型加 W4A8 编码器,1MP、30 步,一张要 2 到 3 分钟,每步 6 到 7 秒。换成 cu130 版 PyTorch 之后,每步降到 1.5 秒,一张约 50 秒。同一张卡,软件版本不同,速度差了两三倍。
除了 ComfyUI INT8,还有几条路:
- Q8_0 GGUF 图像模型加 Q4_K_M 编码器加 VAE,文件合计约 13.35 GB。
- 编码器换成 W4A8 版本,编码器本身只有 6.31 GB。
- diffusers 的 NF4 方案,在 5090 上测得 1024 峰值约 15.2 GB,一张约 19 秒。
stable-diffusion.cpp 跑 Q8 时,运行时报告的总占用是 15645 MB:编码器 7669 MB,扩散模型 7331 MB,VAE 644 MB。编码器仍然是最大的一块。16G 卡跑这套配置,留给激活值的空间已经很少。
GGUF 比 INT8 慢。 Unsloth 团队成员的原话是,GGUF “naturally much slower and only meant for unified memory/CPU devices”,也就是天生慢得多,主要给统一内存或 CPU 设备用。OpenClaw 据此建议,NVIDIA 卡优先用 Comfy-Org 的 INT8 文件。
CPU offload 的代价,说法不一。 Unsloth 称 6GB 显存跑 FP8 加 offload,速度慢不到 2 倍。社区另一条实测是 RTX 3050 6GB,Q4_0 GGUF 加 offload,1184×1184、25 步,一张 4 分 50 秒。两者的精度、后端和分辨率都不同,没法直接比,但能看出 offload 的速度损失因场景差别很大。
还有一个容易误导人的数字。Unsloth 官方文档的内存表写着 INT8/FP8 建议 24GB 显存,24GB 卡上还只建议开 512×512。这和社区大量 16G 卡跑 INT8 的报告对不上。原因是 Unsloth 在表下注明了,这些是估算,不是实测下限。选卡时应以实测为准,不要只看厂商估算表。
3、16G 上跑顺的七条
第一,检查 PyTorch 版本。 前面那位 4060 Ti 用户从 2 分钟降到 50 秒,靠的就是换 cu130 版 PyTorch。ComfyUI 社区开发者 Kijai 也指出,要用 cu130 版才能用上 ComfyUI 的优化。
第二,ComfyUI 升到 v0.37.0 以上。 原生支持的 PR #16400 在 9 月 19 日合并,9 月 21 日随 v0.37.0 发布,官方有现成的文生图和编辑模板。
第三,CFG 设成 1。 CFG 大于 1 时,每一步要算两遍,正负提示词各一遍。设成 1 相当于关掉负提示词,速度翻倍,社区多数人是这么跑的。
第四,先跑 1024。 5090 上的实测,1024×1024 约 19.3 秒,2048×2048 要 115.7 秒。像素是 4 倍,时间是 6 倍。16G 卡先在 1024 把流程跑通,再考虑往上加。
第五,步数先用 20 到 25。 官方 diffusers 示例用 40 步,社区测试多用 20 到 25 步,速度快不少。
第六,先别加载提示词增强模型。 官方另外发布了两个提示词改写模型,是在 Qwen3.5-VL 9B 基础上微调的,能把短提示词扩写成长提示词,INT8 版本也有 9.47 GB。它不是必需品,16G 卡本来就紧,可以先不装。
第七,注意 GGUF 节点兼容性。 用 city96 的 ComfyUI-GGUF 节点加载 unsloth 或 leejet 的 GGUF,会报“Unknown model architecture”,因为这些文件按 stable-diffusion.cpp 的格式转换,缺少对应的架构元数据。可以换用保留了这项元数据的版本(比如 realrebelai 的 GGUF),或者直接用 stable-diffusion.cpp。另外,GGUF 做图片编辑还需要一个 1.16 GB 的 mmproj 文件。
4、量化的损失,和模型本身的毛病
画质问题要分两层看。
第一层是量化带来的损失。 Unsloth 公布了自家量化文件的 LPIPS(越低越接近原图):INT8 是 0.064,FP8 是 0.112,所以他们默认推荐 INT8。这是 Unsloth 自家文件的数据,不能直接套到 Comfy-Org 的 INT8 ConvRot 上。
编码器也一样。Unsloth 拿 UD-Q4_K_XL 编码器和普通 Q4_K_M 编码器对比,固定种子、图像模型和 VAE 不变,两者的 LPIPS 差距是 0.029,SSIM 0.959,文件 5.15 GB 对 5.03 GB,耗时 36.5 秒对 39.0 秒。UD 是 Unsloth 的动态量化,会把对精度敏感的层保留在更高精度。
GGUF 作者 realrebelai 称,通用的 Q4_K_M 转换在细部结构和人体解剖上有明显损失,所以他们做了混合精度版本。这是作者自己的 A/B 测试,对照组是 INT8 而不是 BF16,只能当参考。
第二层是模型本身的问题,和量化无关。 早期用户反馈主要有:画面偏黄、对比度偏高、有噪点,做修复类编辑时细节会被改掉,有时出现合成感很重的纹理。
文字渲染的评价不一。Hacker News 上有做网页设计工具的用户说,它的文字渲染比开放权重市场上其他模型好得多;也有人测到小字仍会拼错。
想知道量化对自己的场景影响多大,最直接的办法是:同一张卡、同样的参数,分别用 INT8 和更高精度各出一张图对比。看不出差别,INT8 就够用。
5、分档对照表
下表综合了 OpenClaw 的整理和各方实测。
| 显存 | 推荐配置 | 实测或估算 | 需要注意 |
|---|---|---|---|
| 6-8GB | Q4_0 / Q4_K_M GGUF + Q4 编码器 + CPU offload | 3050 6GB 实测约 4 分 50 秒/张(1184px、25 步) | 很慢,适合验证流程 |
| 12GB | Q4_K_M GGUF + Q4 编码器,文件约 10 GB | 估算可跑 1024,缺公开速度数据 | 余量很小 |
| 16GB | INT8 ConvRot 图像模型 + INT8 编码器 | 4060 Ti 峰值约 15 GB,约 20 秒/张 | 1024 可行,2K 很紧 |
| 24GB | 8-bit 全部常驻显存 | 5090 上实测 1024 峰值 21.3 GB | 两张参考图编辑会到 25.6 GB,超过 24GB |
| 32GB 以上 | BF16 图像模型 + INT8 编码器 | 全 BF16 文件共 32.44 GB | 32GB 跑全 BF16 仍要 offload,48GB 才宽裕 |
16G 这一档,默认说的是 1024×1024。2K 可以试,但很容易撞上显存上限,速度也会明显变慢。如果主要需求就是 2K 出图,24GB 卡会更从容。
12G 这一档目前主要是按文件大小推算的,还没有公开的 3060 12G 速度报告。
6、许可证:能下载,不等于能随便用
最后是许可证,这一关比显存更硬。
Qwen-Image-2.1 用的是 Qwen Research License。许可证原文写明仅限非商业用途(“FOR NON-COMMERCIAL PURPOSES ONLY”),而非商业的定义是“for research or evaluation purposes only”,即只用于研究或评估。
按字面理解,个人娱乐也不在这个定义里。实际被追究的风险不大,但严格说并不在许可范围内。
商业用途需要单独申请授权,许可证里给了申请邮箱:model-business@notice.qwencloud.com。Hacker News 上有人转述,团队可能考虑设营收门槛、给小创作者免费商用授权,目前没有官方确认,只能当传闻。
衍生模型还有两条要求:基于它训练或微调的模型如果对外分发,文档里要标注“Built with Qwen”或“Improved using Qwen”;衍生品不能用“Qwen”做主名称。
对老用户来说,落差在于上一代 Qwen-Image 1.0 用的是宽松的 Apache 2.0。Hugging Face 讨论区已经有不少人要求放宽许可证,目前看不出官方有改的迹象。
总结一下:16G 显卡用 INT8 ConvRot 跑 1024 分辨率,技术上没问题,20 秒左右一张。个人研究和测试可以放心装;要用在商业项目里,先把授权谈下来,再考虑怎么调参数。