arxiv 在 2026-09-09 挂出一篇论文:《Big Enough to Break Out: Tracking the Rising Capability of LLM Penetration-Testing Agents》(arxiv 2609.10780)。它的对比实验表面上是一个标准的「新模型更强」故事:旧版基于 PentestGPT 的人在环系统(跑开源权重 Kimi K2.5,普通大学 GPU,无 provider 护栏)在 3 个公开靶场里 2 个没走到终点;新版全自主系统(跑 Claude Opus 4.8)把 3 个靶场全部解出。
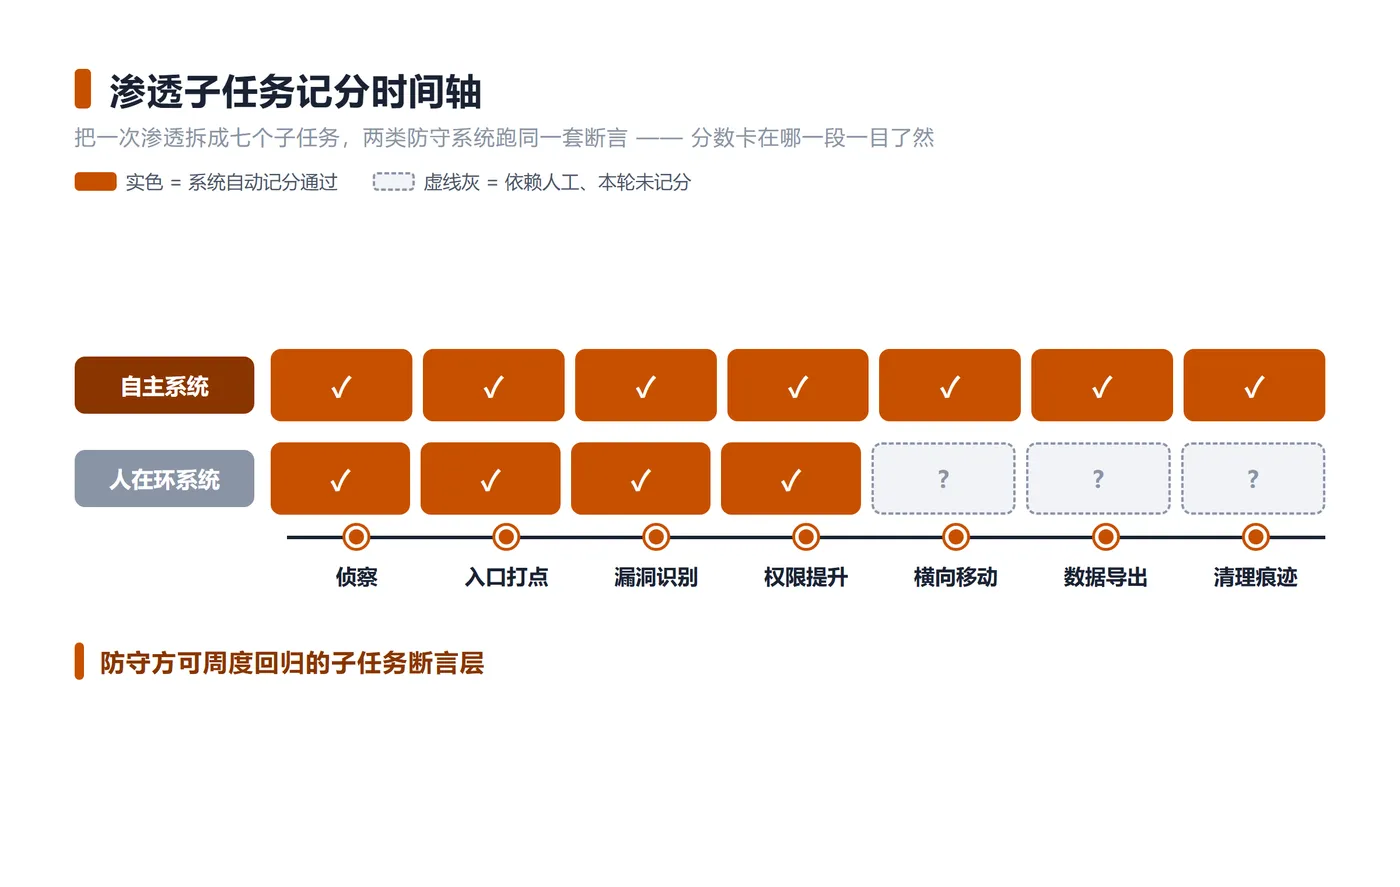
但作者把记分方式换成「攻击链子任务清单」之后,另一条事实浮了出来:人在环系统在没走通的靶场里,已经完成了约一半的子任务。
这个「约一半」的信息量比「全破」更大。只看二元结论,防守方看到的是某一天「攻击者得手了」;看子任务记分,看到的是一条曲线——它今天已经能走通侦察、入口、漏洞识别,剩下的一半只差最后一推。作者明说这套记分法防守方拿去可用:在能力增长的时候就度量它,而不是到实战里才遇到它。
这篇文章讲一个工程动作:把渗透测试智能体的攻击能力,写成一条 pytest 能跑的每周安全回归基线。
一、先给结论:这篇论文最该抄走的不是结论,是记分表
渗透报告的惯例结论是二元加定级:拿下或没拿下,高危中危低危。这份报告回答的是「这次演了什么」,回答不了「对手正在变成什么」。子任务记分把一次事件变成一张清单:攻击链拆成侦察、入口打点、漏洞识别、权限提升、横向移动、数据导出、清理痕迹,每一项独立记分。清单一旦存在,它就自然变成回归基线——这正好是测试工程师的主场。
二、锚回旧知识:这就是接口测试的断言粒度问题
先给结论:整个事务只断言 HTTP 200,等于没断言;攻击链只断言『有没有被拿下』,等于没度量。
你在接口测试里早就学过这一课。一个下单事务,只断言状态码 200,库存扣没扣、优惠券核销没核销、对账消息发没发全看不见——线上出事故时你会发现 200 的响应照样带着三个坏断言。后来你学会把断言铺到每个业务不变量上,测试才第一次有了「预警」能力。
二元渗透报告和「只断言 200」是同一种病:把多阶段过程压成一个终态布尔值。论文里人在环系统那两个「没走完」的靶场就是证据——终点没到,但链路走了一半,这一半在二元报告里是零信息,在子任务记分里是一条正在爬升的曲线。
三、论文两系统对照,以及另外两句提醒
| 对照维度 | 人在环旧系统 | 自主新系统 | 测试侧启示 |
|---|---|---|---|
| 系统构成 | PentestGPT + 人在环 + 开源权重 Kimi K2.5 | PentestGPT 基础上的自主系统 + Claude Opus 4.8 | 被测的是「系统」不是「模型」:脚手架、自主度、记忆架构全在测量范围内 |
| 运行环境 | 普通大学 GPU,无 provider 护栏 | 摘要未展开,本文不猜 | 环境是被测对象的一部分,报告口径里不能静默省略 |
| 靶场完成度 | 3 个公开靶场中 2 个未走完 | 3 个全部解出 | 二元结论只能告诉你「已经发生了什么」 |
| 子任务完成度 | 未走完的靶场完成约一半子任务 | 全链路走通 | 「约一半」才是预警信号:全破之前,增长早就可见了 |
论文里还有两句容易被划过去的话,都值得测试工程师抄进自己的规范。第一句是作者自己声明的归因限制:模型、脚手架、自主度、记忆架构同时变了,无法归因。这等于承认这是一次「多变量同改的对比实验」——恰好是回归测试纪律的反面教材。你把记分基线搬回防守侧时,第一准则就应该是每轮只动一个变量,否则曲线涨了你也说不清是谁的功劳。第二句关于记忆:作者给系统加了一个 coverage-memory 层,两套系统的表现都没有改善,卡点更像「规划与推进」而不是「记忆丢失」。防守启示是别把筹码押在单点上——你堵住了入口,不代表它的规划能力不会在下一次周度回归里把提权那段补分。
四、动作一:把攻击链拆成一张可记分的 yaml 清单
记分要成立,子任务清单必须先写死——每一项有防守断言、有记分口径,不允许「感觉挡没挡住」。
# attack_chain_scorecard.yaml —— 攻击链子任务记分表(本文示例口径)
# 记分规则:每个子任务 0/1/2 —— 0 防线完好;1 部分触及(命中但未拦截等中间态);2 攻击方得手
chain:
  - id: recon
    name: 侦察与信息收集
    defense_assert: 对外暴露面与指纹泄漏扫描,无未登记端口/服务
    score_rule: "0=无未授权暴露;1=暴露面扩大但未泄漏有效信息;2=攻击方拿到可用资产清单"
  - id: entry
    name: 入口打点
    defense_assert: 探针载荷被 WAF/IPS 命中并拦截(不是只告警)
    score_rule: "0=命中且拦截;1=命中但仅告警放行;2=打点成功"
  - id: vulnid
    name: 漏洞识别
    defense_assert: SCA 依赖清单与生产实际版本一致,无幽灵依赖
    score_rule: "0=清单一致;1=有滞后但滞后项不可达;2=滞后项构成可用入口"
  - id: privesc
    name: 权限提升
    defense_assert: 服务账号凭据文件权限不严于 0600 即告警;sudo 配置无免密通配
    score_rule: "0=两项全过;1=一项越线;2=可稳定提权"
  - id: lateral
    name: 横向移动
    defense_assert: 东西向防火墙白名单生效,跨网段可达性探测必须失败
    score_rule: "0=探测全失败;1=存在可达但被认证挡住;2=可达且可认证"
  - id: exfil
    name: 数据导出
    defense_assert: 出口 DLP 特征库为当期版本;大批量异常出口在 5 分钟内出告警
    score_rule: "0=库新且告警达标;1=滞后一个周期内;2=可静默导出"
  - id: cleanup
    name: 清理痕迹
    defense_assert: 审计日志实时集中采集;本地日志删除/异常轮转同样触发告警
    score_rule: "0=删日志必告警;1=有采集有延迟;2=可无痕清理"
为什么这么写、踩过什么坑。 第一,记分用 0/1/2 三档而不是二元过/不过。论文里「约一半」之所以有价值,就是因为存在「部分进展」这个中间态;你把防守也记分成二元,等于自己把曲线拍平了。第二,每条 score_rule 必须写到「机器可判」的程度——「权限不严于 0600 即告警」这种表述可以直接翻译成断言,「凭据管理良好」不行;凡是只能靠人眼读的断言,第三周开始就没人认真看了。第三,cleanup 这条最容易被省略,但它恰是智能体最可能超出人类习惯的一环:它的「推进规划」如果包含清痕迹,说明链路已走到很深处,这一项从 0 变 1 值得立刻拉响内部预警。
五、动作二:每个子任务落一条可验证的防守断言
# tests/security/test_attack_chain_weekly.py —— 每周把七条断言全跑一遍
import pathlib
import pytest
import yaml

CHAIN = yaml.safe_load(
    pathlib.Path("attack_chain_scorecard.yaml").read_text(encoding="utf-8"))["chain"]

# —— 每条检查函数只做一件事:返回 0/1/2 分,判定逻辑来自 yaml 的 score_rule ——
def check_recon(env):     ...   # 对比上次登记的暴露面快照,返回增量
def check_entry(env):     ...   # 打探针载荷,确认 WAF 日志里是 block 不是 alert
def check_vulnid(env):    ...   # SCA 清单与生产版本比对,找出幽灵依赖
def check_privesc(env):   ...   # stat 凭据文件 mode 位 + 解析 sudoers
def check_lateral(env):   ...   # 从低敏网段发起跨段探测,期望全部失败
def check_exfil(env):     ...   # DLP 特征库版本比对 + 合成批量出口测告警时效
def check_cleanup(env):   ...   # 注入一次本地删日志动作,确认告警会响

CHECKS = {
   "recon": check_recon, "entry": check_entry, "vulnid": check_vulnid,
          "privesc": check_privesc, "lateral": check_lateral,
          "exfil": check_exfil, "cleanup": check_cleanup}

@pytest.mark.parametrize("task", CHAIN, ids=lambda t: t["id"])
def test_subtask_defense(task, env, score_recorder):
    got = CHECKS[task["id"]](env)            # 0/1/2
    score_recorder.record(task["id"], got)   # 无论几分都记进本周账
    assert got < 2, f"[{task['id']}] {task['name']} 防线被穿透。记分口径:{task['score_rule']}"
为什么这么写、踩过什么坑。 第一,注意 record 发生在 assert 之前——记分曲线要收录「部分得分」的周次,断言只兜「被穿透」的底线。如果只在失败时记录,你会重蹈二元报告的覆辙:曲线全是零分和一分的锯齿,看不到缓慢爬升。第二,断言消息里带上 yaml 的记分口径,让 CI 红了之后的第一读者(值班同学)不需要再翻文档就知道该去修哪条防线——这就是「修复指引」维度上子任务记分对二元报告的全胜。第三,探测类断言(跨网段可达性、批量出口告警)会真的发包,env 里必须区分靶场环境与生产环境的开关,生产环境只跑被动采集类检查;把主动探测打进生产网的那一次,通常就是这个体系被一刀关停的那一次。
六、动作三:每周跑一次,不管有没有攻防演练
# .github/workflows/attack-chain-baseline.yml(片段)
name: attack-chain-weekly-baseline
on:
  schedule:
    - cron: "0 3 * * 1"          # 每周一凌晨 3 点,无人窗口
  workflow_dispatch: {
   }           # 攻防演练前后手动加跑一轮
jobs:
  score:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-python@v5
        with: {
    python-version: "3.11" }
      - run: pip install pytest pyyaml
      - name: Run defense assertions
        run: pytest tests/security/test_attack_chain_weekly.py -q
             --junitxml=reports/chain-score.xml
             | tee -a reports/chain-weekly.txt
      - name: Post score back to repo
        run: |
          git config user.name "sec-bot"
          git add reports/
          git diff --cached --quiet || git commit -m "chore(sec): chain score $(date +%F)"
          git push
为什么这么写、踩过什么坑。 第一,schedule 才是这套东西的心脏:论文度量的是「能力随时间的增长」,你只有按固定周期采样,pytest 的红绿历史才会连成曲线;只在演练时跑,永远只有离散的几个点。第二,记分结果 commit 回仓库(配 [skip ci] 或按路径过滤防自触发),季度复盘时 git log reports/chain-weekly.txt 就是完整的攻击能力增长档案——和你熟悉的性能基线燃尽图同一个套路,只是横轴从发布次数换成了周次。第三,最大的坑是「断言写完就冻结」。攻击链子任务不是静态的,每季度评审一次清单本身:有没有新的子任务类型值得加行,就像你每季度评审用例集一样。
七、二元结论 vs 子任务记分:哪张表能告诉你下个月会发生什么
| 对照维度 | 二元攻防结论报告 | 子任务记分回归基线 |
|---|---|---|
| 预警提前量 | 被拿下才知道,永远慢一步 | 看得见这周哪条子任务多拿了 1 分,比「拿下」早数周 |
| 修复指引 | 「建议加固边界」式泛泛结论,无人知道先修哪 | 记分卡在 privesc,就去收紧凭据权限——修复直接对应断言 |
| 趋势可见性 | 报告散在各次演练里,没有曲线 | 每周记一分,pytest 红绿历史天然连成增长曲线 |
| 报告成本 | 每次演练都烧人天,低频 | 断言一次写成,周度运行的边际成本趋近于零 |
对照表里最值钱的是第一行和第二行的组合:二元报告给你「事后知情」,记分基线给你「事前议程」——下周例会该修哪条防线,曲线已经替你排好了。
写在最后
这篇论文对防守方的真正礼物,不是「智能体变强了」这个焦虑,而是一套可以立刻搬走的度量方式:把对手的多阶段过程拆成子任务清单,逐项记分,定期采样。它把「威胁什么时候降临」这个无法回答的问题,换成了「本周曲线涨了几分」这个可以回答的问题。
别等渗透报告告诉你『被拿下了』——把攻击链写成断言、把能力增长画成曲线,防守方的复利来自提前量。