
2026 年 10 月 10 日,百炼平台的模型矩阵将迎来一次集中更新:179 个模型条目退出服务,覆盖 qwen3-max 全系、qwen-image 系、qwen-plus 四个快照,以及语音模型与 DeepSeek、GLM、Kimi 等第三方条目。
对使用平台的团队来说,模型迭代本身是常态,但一次 179 条的规模,让「依赖清点」从可选项变成必修课。官方通知机制的覆盖范围有限:短信与邮件提醒只触达近 3 个月有调用记录的账号,低频调用与未绑定通知方式的服务账号会静默度过这个窗口期。
本文是一次完整工程实践的记录:从目录查询机制、全量扫描脚本、公告对账,到迁移目标验证与实测数据,全部通过百炼 CLI(bl)完成,命令可复现。
目录查询的三种模式:browse、detail、search
自查的第一步是搞清 CLI 的查询机制,这里有一层容易被误解的设计:
bl model list --page 1 --page-size 50 --output json   # browse:全量目录
bl model list --model qwen3-max --output json          # detail:单族详情
bl model search --keyword qwen-image --include-deprecated --output json  # search:关键词
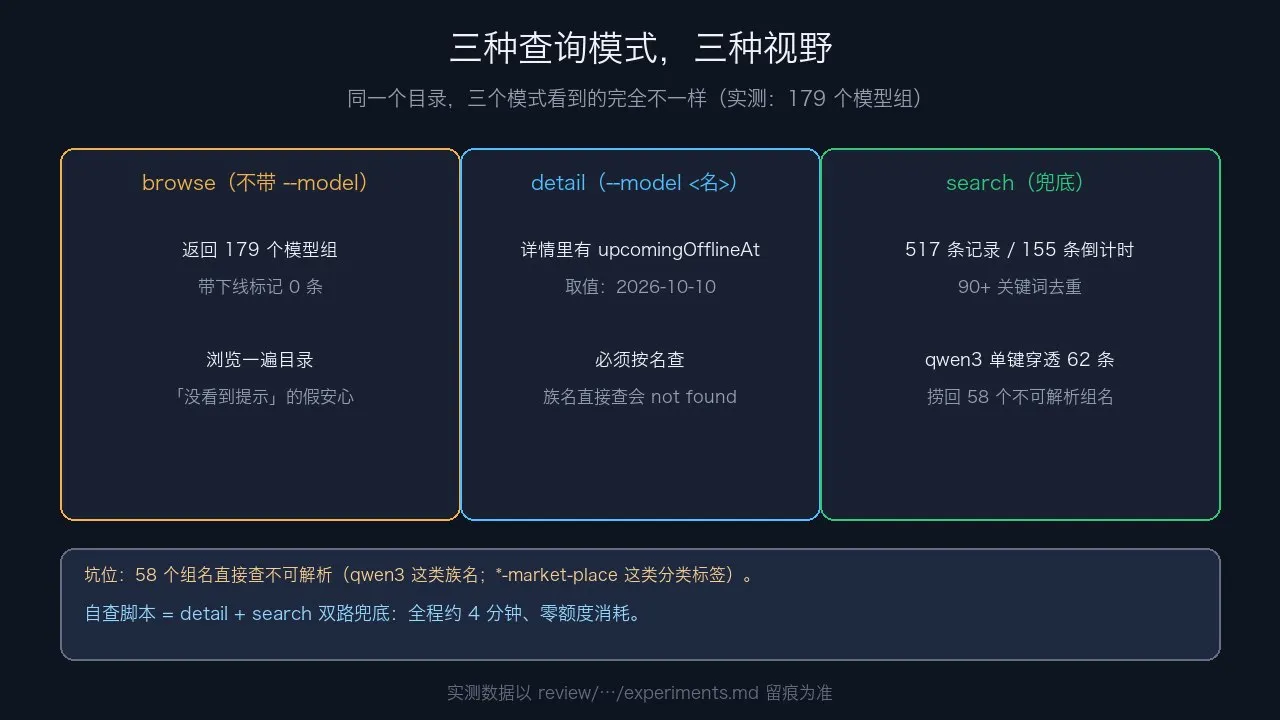
实测(179 个模型组全量核对):browse 模式 0 条带 upcomingOfflineAt 字段。下线标记只在 detail 与 search 模式出现,其中 search 返回个体模型并附带 offline 与 upcomingOfflineAt 双字段,适合批量筛查。--include-deprecated 是 search 的关键参数,不带会被隐藏带下架标记的结果。
对开发者的实际含义:「浏览一遍目录没看到下线提示」是假安心,必须逐族点名查或走 search。
search 模式同时也是全量视角:90 多个关键词扫射去重后是 517 条模型记录,155 条带倒计时,单关键词 qwen3 就能穿透出 62 条标记条目。
全量扫描:detail 优先 + search 兜底
把整个目录扫一遍的脚本,我迭代了两版。初版(组名循环 + detail 查询)实测输出 113 条,漏了 42 条;漏掉的包括 qwen3 开源系、DeepSeek R1/V3 系、Kimi、cosyvoice 系等。
根因在查询接口的行为:部分模型族在 browse 列表中的组名本身不可查询(返回 Model "qwen3" not found.),但组内个体名(如 qwen3-32b)可归并返回整组。修正版对每个组名先试 detail,失败降级 search 穿透:
for g in $(for p in 1 2 3 4; do
  bl model list --page $p --page-size 50 --output json | jq -r '.items[].model'
done | sort -u); do
  FOUND=$(bl model list --model "$g" --output json 2>/dev/null)
  if echo "$FOUND" | jq -e '.items' >/dev/null 2>&1; then
    echo "$FOUND" | jq -r '.items[]? | select(.upcomingOfflineAt != null) | "\(.model)\t\(.upcomingOfflineAt)"'
  else
    bl model search --keyword "$g" --include-deprecated --limit 500 --output json 2>/dev/null \
      | jq -r '.items[]? | select(.upcomingOfflineAt != null) | "\(.model)\t\(.upcomingOfflineAt)"'
  fi
done | sort -u
验收:输出 155 条,与目录标记全集逐条对账零漏、零多,耗时 229 秒。
兜底分支不是边角料:179 个组名里有 58 个直接查不可解析,既有 qwen3 这类族名,也有 qwen-audio-3.1-asr、*-market-place 这类分类标签,这些组里的标记条目只有它能捞到。
公告与目录的对账:179 = 155 + 9 + 9 + 6
CLI 侧最好覆盖 155 条,官方公告为 179 条,差额分四类:
| 目录状态 | 条数 | 说明 |
|---|---|---|
| 带 10 月 10 日倒计时 | 155 | 扫描脚本可覆盖 |
| 带 offline 已下架标记 | 9 | qwen-turbo、qwen-vl-max、qwq-plus 等 |
| 仅国际站 -us 变体 | 9 | 国内目录不可见 |
| 目录无踪迹 | 6 | cosyvoice-v3、sensevoice-v1 等 |
反向核验:目录中所有带下线标记的条目均在官方名单内,假阳性 0。剩余 24 条需回公告页核对(7 月 6 日公告 73 条 + 7 月 10 日公告 106 条)。
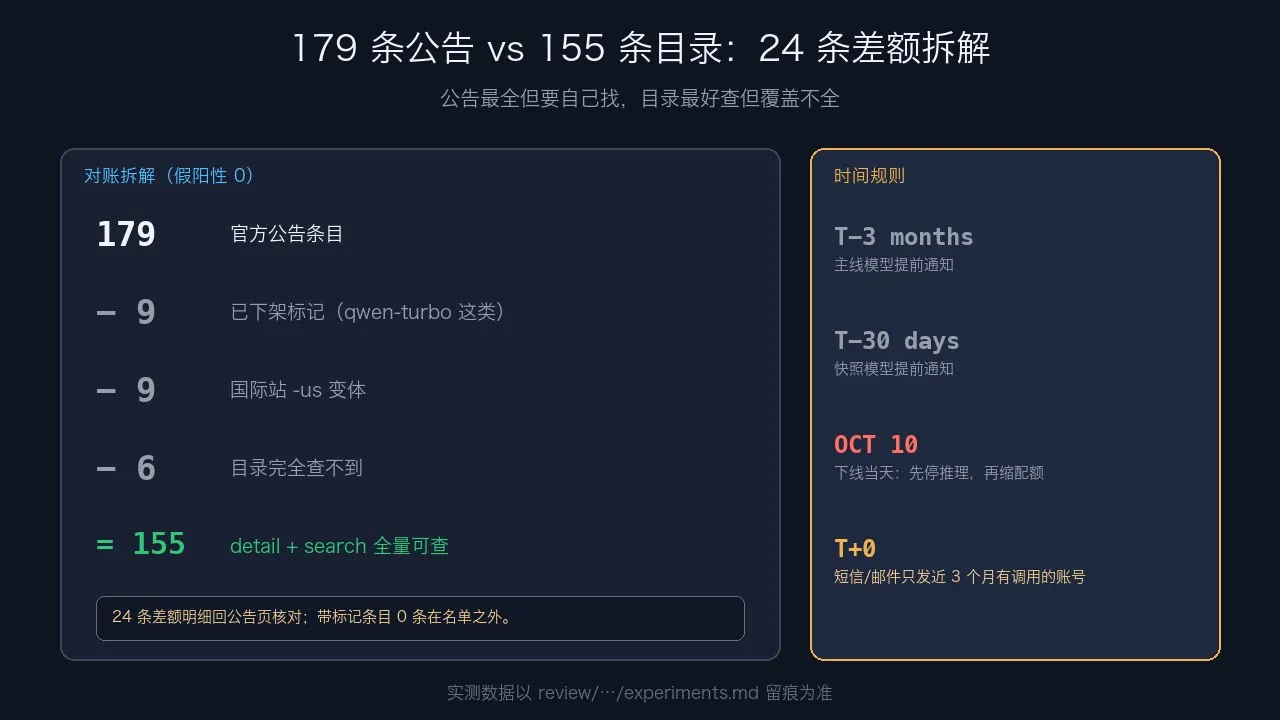
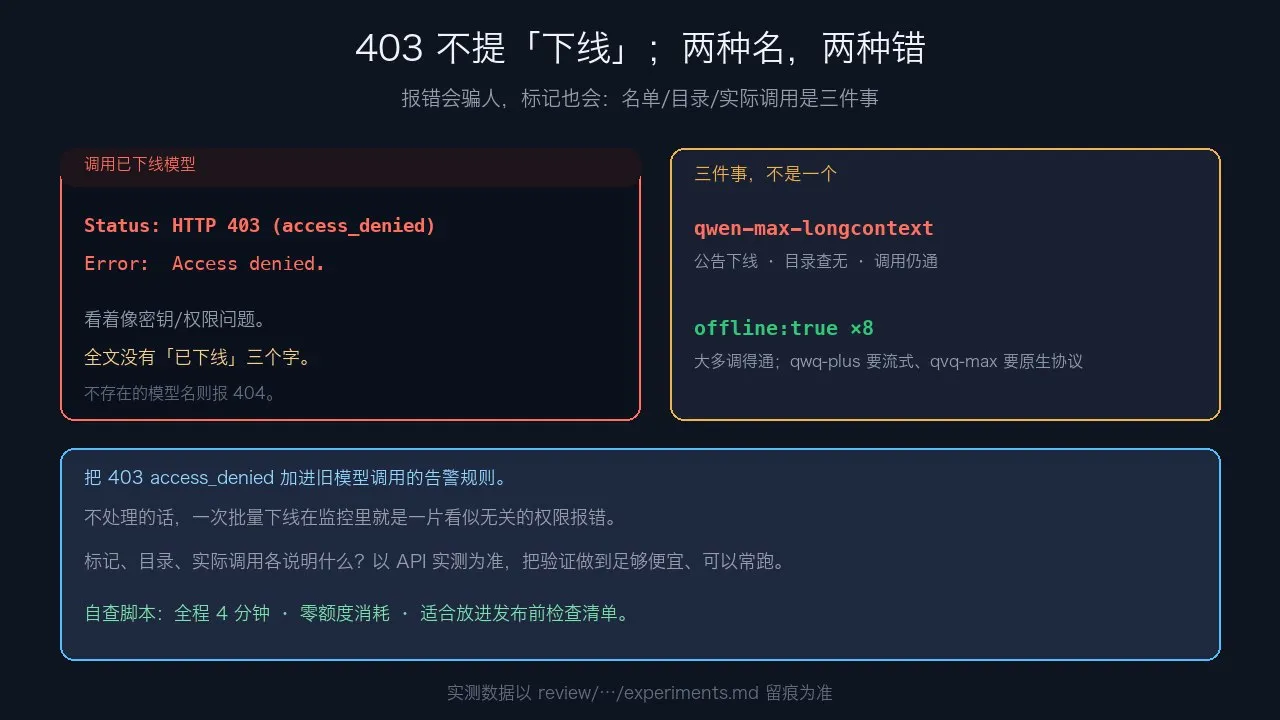
两个机制细节建议写进值班手册:其一,已下线模型的调用报错为 403 access_denied,文案不含「已下线」字样,监控规则需单独覆盖;其二,下线执行是先停推理、后缩减配额,下线日后的限流加剧可能与退役模型相关。
另有两类边界情况:8 个带 offline 标记的模型(qwen-turbo、qwen-vl-max、qvq-plus 等)实测大多仍可调用,其中 qwq-plus 需流式、qvq-max 需原生协议;qwen-max-longcontext 目录查不到但调用正常。标记、目录、服务是三层独立状态。
迁移验证:三类模型的实测数据
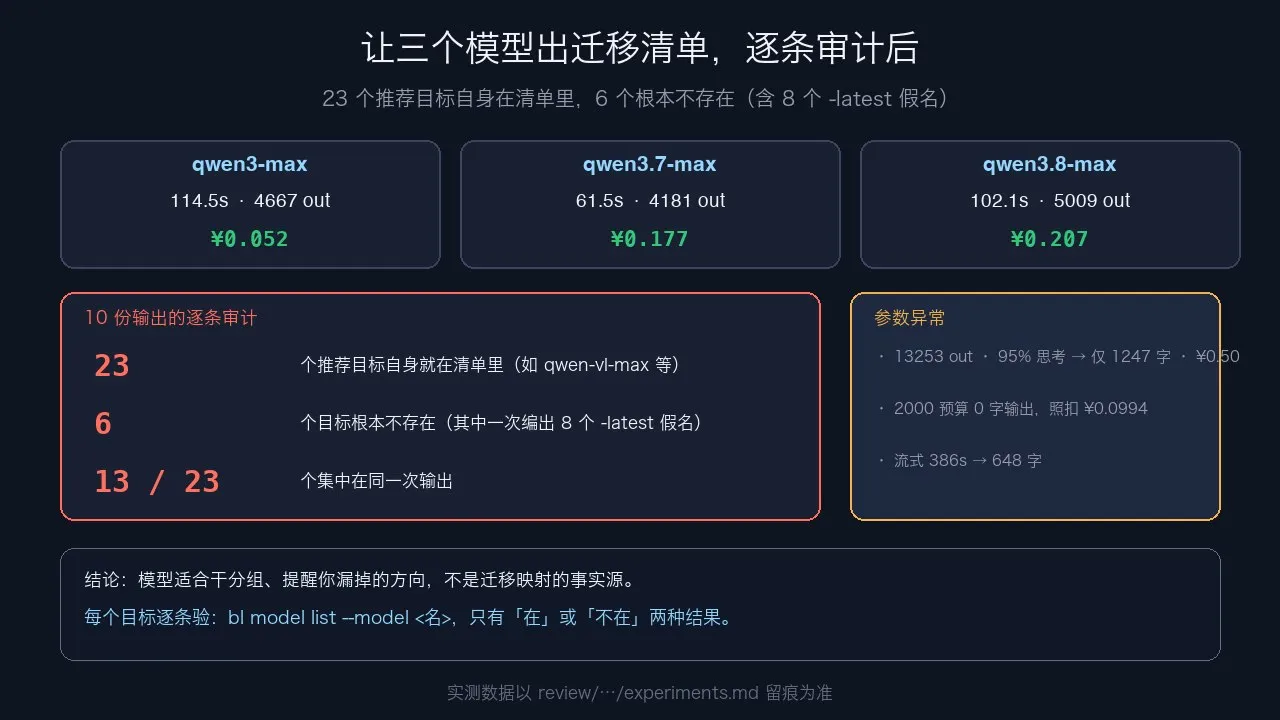
文本侧。同一任务(179 条清单分类 + 迁移建议)在三个模型上跑对照:
| 模型 | 耗时 | 输出 tokens | 单次费用 |
|---|---|---|---|
| qwen3-max(将下线) | 114.5s | 4667 | ¥0.052 |
| qwen3.7-max | 61.5s | 4181 | ¥0.177 |
| qwen3.8-max | 102.1s | 5009 | ¥0.207 |
这次对照还产出一个额外结论:模型生成的迁移建议不可直接采信。全部输出经双重核验(对官方名单 + 目录现场查询),23 次推荐的迁移目标本身就在下线清单内,6 次推荐了目录中不存在的模型(含一组 8 个 -latest 幻觉别名)。迁移目标的正确来源是 bl model list --model <目标名> 的存在性核验。
代码改动面方面,bl model code 生成新旧模型样例 diff 后只差 model 字符串一行,SDK、端点、鉴权、请求结构不变,工作量主要在查找硬编码位置。配额维度也不变:两者同为 500 QPM、500k tokens/6s 突发窗口。更需注意的是参数敏感性:responses 接口下 qwen3.7-max 的 13253 个输出 token 有 95% 用于思考,最终仅返回 1247 字、单次 0.5 元;qwen3.8-max 在 2000 token 预算下输出 0 字仍计费 0.0994 元。把这类任务接入自动化前,超时与预算按最坏情况设计。
图像侧。qwen-image 与 qwen-image-3.0 同 prompt 对照:单张 8.1 秒 / 0.25 元 对 68.2 秒 / 0.18 元。新模型单张成本低 28%、耗时约为 8 倍,中文标题两者均可渲染,新模型自带印章、竖排等排版细节。同步调用的管线迁移前需确认超时配置。另有两个操作细节:默认水印需显式关闭(--watermark false;旧模型角标 Qwen-Image、新模型角标「AI 生成」);--size "1024*1024" 的星号必须加引号,否则会被 shell 做 glob 展开。
成本侧。qwen3.7-max 与 qwen3.8-max 输入输出单价相同(12 / 36 元每百万 tokens),缓存命中价分别为 2.4 元与 1.5 元,差距 37.5%。长系统提示词与多轮对话场景建议按缓存命中比例重算月度成本。
上手:三步跑通自查
第一步,安装:
npm install -g bailian-cli
第二步,逐个核对在用模型:
bl model list --model <你的模型名> --output json \
  | jq -r '.items[] | select(.upcomingOfflineAt != null) | "\(.model)\t\(.upcomingOfflineAt)"'
第三步,全量扫描脚本(上文修正版)存入 check_models.sh,10 月 10 日前定期执行。
自查类命令均为 No Auth、不消耗额度,可以放心跑。需要执行迁移验证(调用模型)时,先在控制台创建 API Key 配入环境。一行命令安装的完整指引见官方控制台;免费领一个 API Key 入口在此。
模型矩阵的更新周期里,把「目录状态核查」做成例行动作,比在下线日排障划算得多。
