
在有限投入条件下提升被AI引擎引用的概率,关键不在增加发布量,而在理解引用链路。AI引擎的回答引用依赖平台推荐结果,平台推荐又依赖内容结构与平台规则的匹配程度。本文面向开发者与技术决策者,解析平台推荐与AI引用的先后关系、平台选择方法、可引用内容结构,以及可复现的验证路径与适用边界。
平台推荐与AI引用存在明确先后顺序
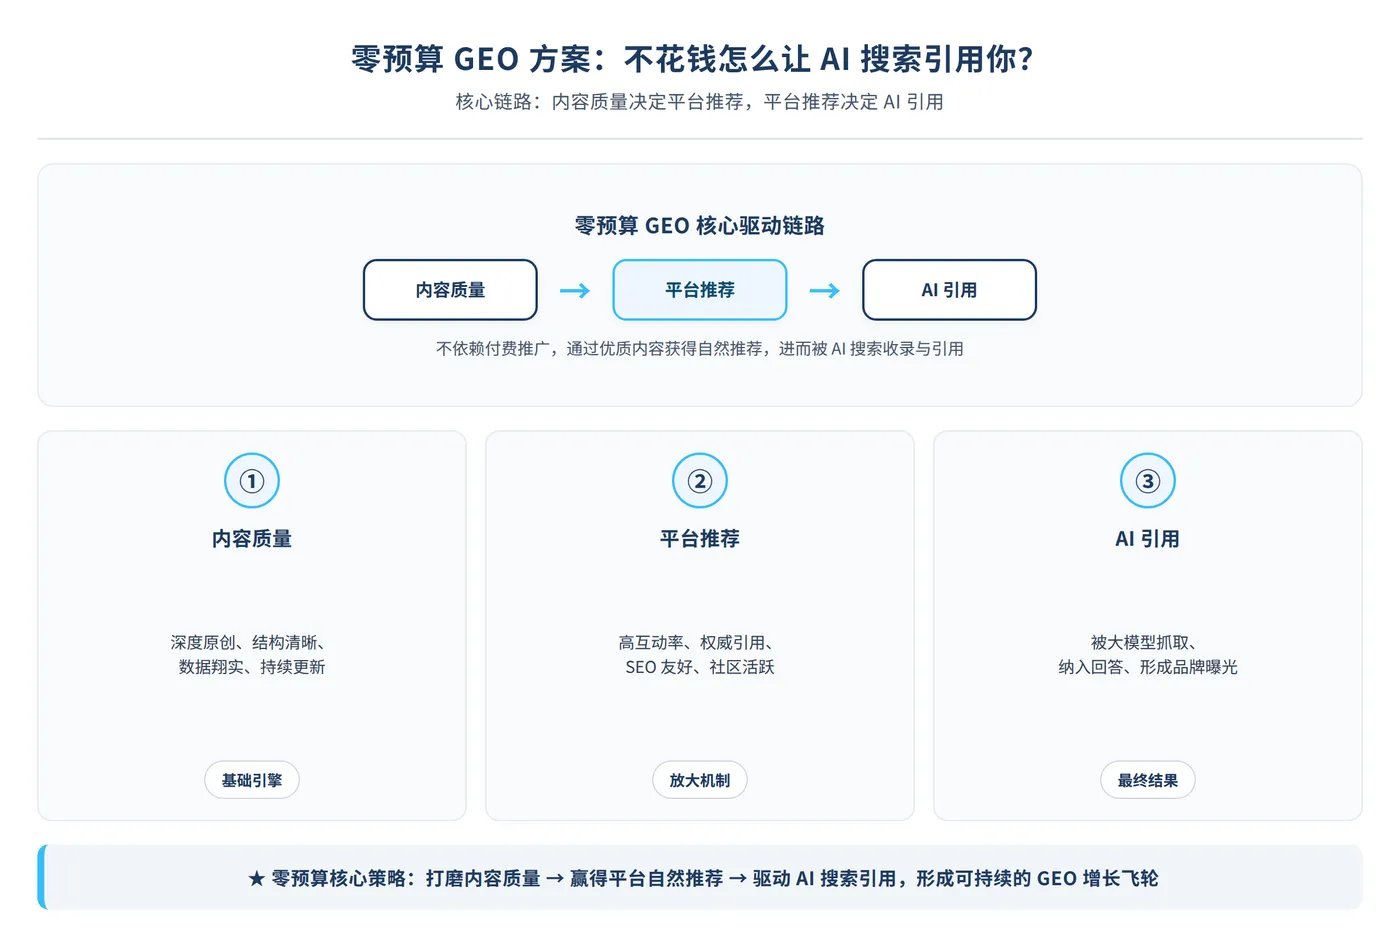
AI引擎并不直接从全网随机抓取内容,其引用对象往往是已经在特定平台获得推荐的内容。平台推荐层位于内容与AI引用之间,平台先完成筛选与分发,AI引擎再基于已有分发结果进行摘录与合成。若忽略这一顺序,直接面向AI引擎批量生产内容,引用概率难以提升。
源文章提到的一轮引擎实测覆盖了四个引擎各200个行业词的引用源统计。结果显示,豆包偏好CSDN、头条、搜狐、知乎、腾讯云;DeepSeek偏好知乎、CSDN、博客园、阿里云、掘金;Kimi偏好知乎、36氪、虎嗅、界面新闻、少数派;秘塔偏好学术、arXiv、官方文档、维基百科。各引擎偏好存在差异,共同特征是引用集中于在特定平台已被验证的内容,而非离散的随机页面。
由此得出的判断是,有限投入条件下的第一目标不是直接追求AI引用,而是让内容符合目标平台的推荐规则。不同平台的推荐规则并不一致,CSDN更认可长文、较高密度的数据与代码块;头条更认可短段落、明确的标题信息与结尾互动结构;搜狐更认可新闻锚点、时间线叙事与第三方数据支撑。同一份内容不做调整直接多平台发布,难以同时满足多套规则。
基于上述机制,一键分发到全网的做法存在结构性缺陷。分发工具解决的是发布效率问题,没有解决规则适配问题。一篇核心内容针对不同平台分别调整标题、结构、篇幅与信息密度,虽然单次耗时更长,但每个版本都对应一套推荐规则,整体推荐概率更高。在投入边界受限时,规则适配的优先级高于发布数量。
平台选择依据内容类型与引用可观测性
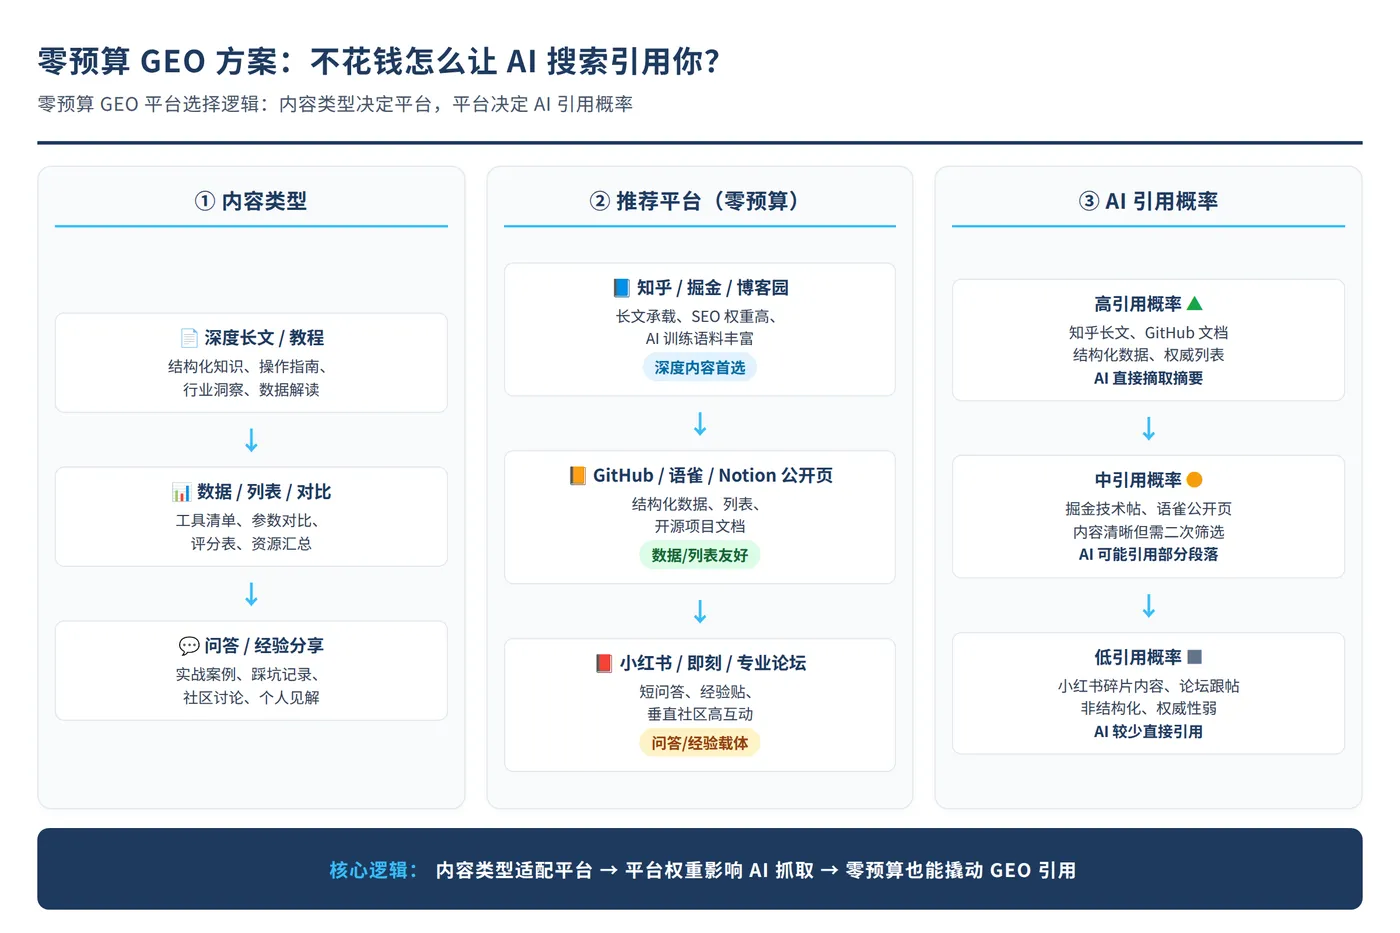
平台选择的核心依据不是平台整体流量规模,而是特定内容类型在该平台被AI引擎引用的可能性。技术教程类内容与CSDN、腾讯云、阿里云等开发者平台的匹配度更高;决策思辨类内容与搜狐、人人都是产品经理、网易等平台的匹配度更高;行业观察类内容与界面、36氪、虎嗅的匹配度更高;实操案例类内容与头条、搜狐、知乎的匹配度更高。应先确定内容类型,再确定平台集合,顺序不宜颠倒。
在投入受限时,分散尝试多个新平台会稀释单平台的内容深度。源文章的建议是先做透CSDN、头条、搜狐三个平台,并指出三者合计在豆包国内引用源中占有较高比例。对于开发者而言,这一思路可以转化为约束条件:在验证出稳定推荐之前,将平台数量控制在三个以内,集中完成内容适配与数据观察。
平台地图可以通过可复现的手工方式建立。在豆包和DeepSeek中分别检索本行业4个核心提问词,记录每个回答底部标注的引用来源,统计各平台出现频次。出现频次高的平台即为当前行业的高概率引用平台,长期未出现的平台可暂时降低优先级。该方法不需要额外工具,一个下午即可完成一轮采样。源文章记录的一次采样结果为25条引用源中自有站点引用为0,该结果的价值在于确立了优化起点与后续对比基线。
可引用内容的结构特征与信息块设计
Princeton的GEO论文arXiv:2311.09735给出的实测结论值得参考:引用来源、统计数据、直接引语是提升AI引擎引用率较强的三类策略,分别带来34.4%、32.1%和29.7%的提升,而关键词堆砌几乎无效。这说明AI搜索属于语义匹配,判断依据是信息块是否完整回答了用户的潜在意图,而非关键词重复次数。
从机制上看,有限投入的内容需要通过三层检验。第一层是真实性,内容中的产品描述、数据与结论应经得起实际核验。源文章提及2026年3月15日央视曝光的AI投毒情形,即通过批量虚假软文误导AI引擎推荐,其后续整顿结果表明虚假内容的可持续性很低。第二层是具体性,AI引擎更易摘录结构完整、可独立引用的信息块,例如具体性能数据、量化结果、行业痛点分析。将产品优势页拆分为多个知识锚点,每个锚点独立成段、含义完整,便于在合成答案中以数据来源形式被引用。
第三层是交叉印证。同一套核心信息在多个平台以不同版本出现,且关键事实保持一致,会提高信息源的可信度评估。同一核心内容改写为多个平台版本的目的正在于此:不是重复铺量,而是在不同平台形成一致、可互相印证的信息分布。当CSDN存在技术长文、头条存在实操案例、搜狐存在行业观察,且三者事实口径一致,AI引擎在抓取时会更倾向于将其视为稳定信息源。
比如,某设备相关的选型提问在豆包中被检索时,若相关技术细节只存在于自有站点且未在任何平台形成分发,AI回答中出现该站点的概率就很低。反之,若技术细节、应用过程与行业分析分别以适配形态分布在三个平台,引用链路更容易形成。此处为假设示例,用于说明信息分布与引用的关系。
执行节奏与观测指标的验证方法
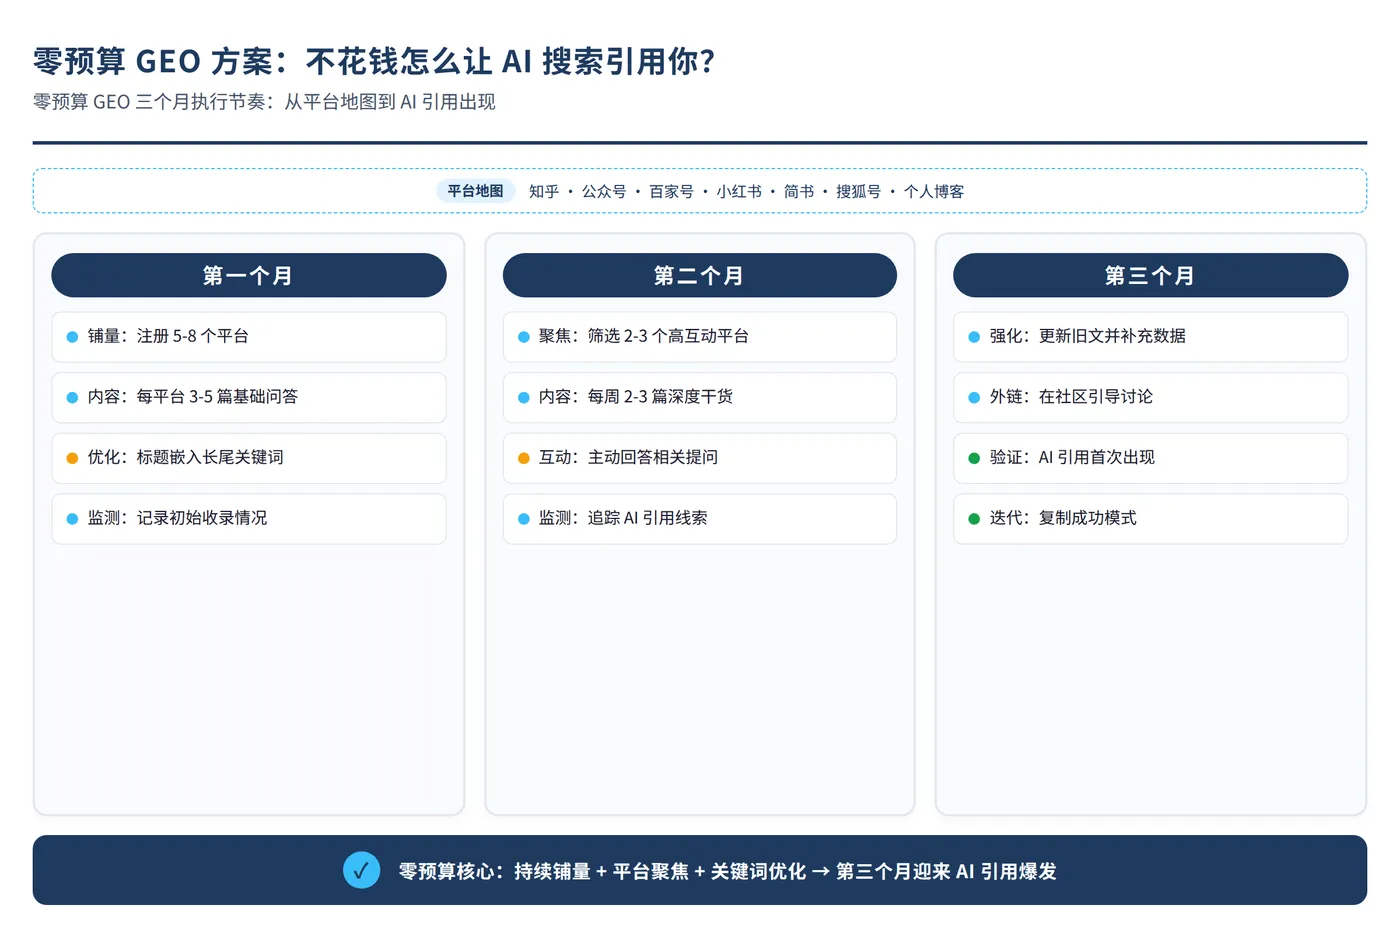
与搜索广告按天获得点击反馈不同,AI搜索优化的反馈周期更长。源文章给出的经验区间是前60到90天开始出现变化,前6个月主要形成信任资产积累。开发者在规划时应将该周期纳入预期,避免用短期点击指标评价长期引用建设。
可执行的节奏分为三个阶段。本周完成平台地图,检索5到10个行业核心提问词并记录引用来源。下周在排序靠前的三个平台建立账号,分析各平台的推荐规则、内容结构与标题形态。下月围绕一篇核心文章,按三个平台规则分别改写并发布,观察推荐量与检索可见性。三个月后复查核心提问词下AI回答的变化,判断引用是否出现。
衡量指标也需要调整。单篇文章被引用几次属于偶发指标,更稳定的指标是目标行业50个核心提问词中,各引擎回答出现自有站点或账号的覆盖比例。即使单篇引用率不高,只要核心提问词集合中的覆盖面持续扩大,整体引用基础就在增强。建议每月使用固定提问词在豆包、DeepSeek、Kimi各执行一轮检索,记录出现次数与引用来源变化,再据此调整内容结构。将AI搜索优化作为数据实验处理,比作为经验判断处理更可靠。
适用边界、风险与检查清单
上述路径成立的前提是内容本身具备可验证性。若产品存在缺陷、数据无法复核、结论缺乏依据,再精细的平台适配也只会放大低质量信息的传播范围。一个可直接使用的检查方法是:将每篇文章交由5个真实客户逐字核对,确认技术细节、数据口径与使用条件无误后再进入多平台改写流程。
适用边界同样需要明确。该方法适用于已有明确技术内容、能够输出数据与文档的团队;若尚无可验证的技术积累,应先完成内容维护与文档建设,再进入引用优化阶段。同时,不同引擎的平台偏好会随时间变化,平台地图需要定期重测,不宜将一次采样结果作为长期依据。
收束为一份检查清单:是否已建立行业提问词与引用源对照表;是否将平台数量约束在三个以内;核心内容是否已按平台规则分别改写;信息块是否包含可摘录的数据、来源与直接引语;多平台版本的关键事实是否一致;是否按月使用固定提问词复测覆盖率。满足上述条件,有限投入下的AI搜索优化才具备可持续的验证基础。

