
先回答一个反问:为什么不能 Excel 加个相册就搞定?
每次和家族组织聊数字化,几乎都会听到同一个方案:建一个 Excel 表,每人一行,再加个网盘相册放老照片。听起来低成本、零学习门槛,为什么还要一套定制平台?
问题出在 Excel 的"表格模型"上。族谱的核心不是一张平面的名单,而是一张立体的网:人与人之间有父子、夫妻、过继、承祧多重关系,这些关系本身是数据,而且会随新成员出生不断生长。Excel 能存"张三,生于 1932 年",却存不好"张三的次子过继给张三的堂兄"——你没法让一个单元格同时指向另一行,更没法据此自动画出宝塔式世系图。相册解决了照片存放,解决不了"这张照片属于哪个人、可见范围是谁、老谱哪一页扫出来待点校"这串管理问题。
把这些问题翻译成技术语言,就是三个层次的分工:数据存什么、关系怎么算、界面怎么呈现。这正是行业通用的三层架构。理解它最省力的类比是图书馆:书库负责藏书(数据层),编目检索系统负责让书被找到、被关联(逻辑层),阅览室负责让读者舒服地看书(展现层)。下面逐层拆。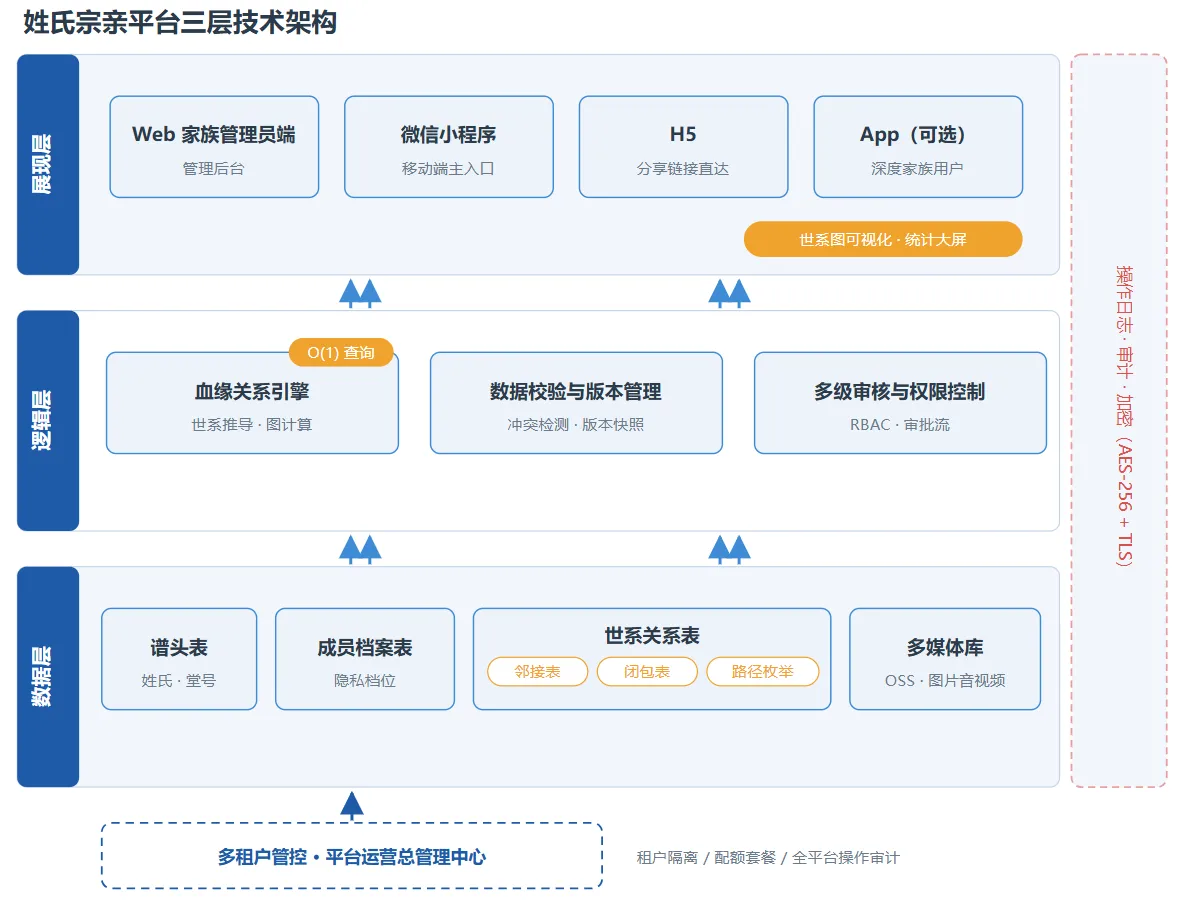
数据层到底存什么?
书库的原则是分类上架、账目清楚,数据层同理。姓氏宗亲平台的数据层在行业实践中通常拆成四类表。
第一类是谱头信息表:家族名称、堂号、郡望、始祖信息、谱序、凡例——相当于一本书的书名页和版权页,一个家族一条主记录。
第二类是成员档案表,这是数据量最大的部分。行业通用的字段设计包含生卒年月、字号、性别、排行、学历、职业、婚配、葬地、现居地经纬度等二十余个字段,并配隐私分级字段(公开/族人/近亲/仅自己四档)。存储安全上采用 AES-256 加密,传输环节走 TLS,这是涉及大量个人信息的系统必须具备的底线配置。
第三类是世系关系表,也就是 Excel 做不到的部分。主流方案有三种,各有取舍:闭包表把任意两个成员之间的祖先关系预先存下来,查询"某人的所有后代"是 O(1) 级的快,代价是新增成员时要补写多条关系记录;路径枚举给每个成员存一条从始祖下来的路径字段(类似"1-3-17-52"),查整条支系像翻路径地图,直观但改结构时要批量更新路径;邻接表只存"每个人的父亲是谁",结构最简单,查询靠数据库的递归 CTE 一层层往下追。实际项目中常见组合用法:日常维护用邻接表,高频查询场景用闭包表加速。选哪种,取决于家族规模和查询频率,没有唯一答案。
第四类是多媒体库:老谱扫描件、照片、口述历史音视频,存放在 OSS 对象存储而非数据库里,数据库只存索引和归属关系。这和图书馆"书在架上、卡片在柜里"是同一个道理——大对象和元数据分离,各自用最合适的存储方式。
逻辑层凭什么比 Excel 聪明?
编目系统不只登记书名,还负责判断"这本书和那本是同一版吗""这条索书号是不是写错了"。逻辑层在数据层之上做三件事。
第一件是血缘关系引擎。给定任意两个成员,系统能回答他们是什么关系、隔几代、共同祖先是谁——这就是字辈自动匹配和寻根检索的底层能力。寻根检索支持姓氏、字辈、祖籍三个维度的组合查询,本质是在成员档案表和关系表上做多条件索引检索。为了撑住大家族的并发查询,行业通行做法是用 Redis 把字辈表和热点家族树缓存起来,避免每次都穿透到数据库。
第二件是校验与数据质量。录入是最容易出错的环节,所以校验规则前移到提交时点:父龄小于子龄、生卒年月互相矛盾、字辈与已录支系对不上,系统当场拦截并提示。老谱 OCR 接入的数据同样走这道关——民国木刻本识别率约 85% 以上、手写体约 70%,AI 引擎虽可更高,但识别结果必须经人工点校,点校提交后进入审核。
第三件是版本管理,这里体现的是谱学传统与技术手段的结合。"信以传信,疑以传疑"是老谱学的治谱原则:存疑的内容不轻率删改。技术上对应的是版本追溯机制——一条记录的每次修订都保留版本快照,争议信息不覆盖原记录而是并存标注,由编委裁定。Excel 的"最后一次保存获胜"在这里是行不通的。
展现层如何把数据变成"看得懂的族谱"?
阅览室不藏书,只负责让书好用。展现层把逻辑层算好的关系渲染成人能读的形态,典型输出有四种。
其一是世系图可视化:欧式、苏式、宝塔式等传统体例在前端以图谱形式还原,支持缩放拖拽,从始祖下钻到本人或反向追溯,把"翻页查谱"变成"缩放看谱"。其二是成员详情页:聚合档案、照片、口述视频、隐私可见范围内的关联人。其三是统计大屏:人口分布、年龄结构、迁徙分析,供家族管理员在 Web 端查看。其四是多端形态:家族管理员端是 Web 页面,族人用户端是微信小程序加 H5,App 为可选——UniApp 加 Vue3 的前端技术组合在行业里被广泛用于一套代码覆盖多端。
多端能并存的前提是数据同步机制可靠。通行做法是"一份云端数据源,各端读写同一库":小程序端弱网下本地暂存、联网后回传;批量导入老谱数据时任务异步化,处理进度通过推送通知到端上,避免提交后干等。族人在手机上补录的信息,族长在电脑 Web 端审核时看到的是同一份数据——这就是三层架构里"所有端共享一个逻辑层"的直接体现。
一次"新增族人"的完整旅程:三层如何协同
把三层串起来看一个具体场景。某地族人张女士在小程序上为新出生的孩子提交入谱申请(展现层收集输入),系统先跑数据校验:父亲年龄大于孩子出生日期、字辈符合该支系字辈表(逻辑层校验),通过后记录写入成员档案表与世系关系表,采用邻接表挂接到其父亲节点下(数据层存储),照片同步上传 OSS。提交物进入审核队列,由房长初审、编委复核、族长生效——多级审核、驳回需附补资料意见、族人端可见状态流转,形成闭环响应。生效后,Redis 中的家族树缓存刷新,全部五类角色(平台运营管理员、家族管理员、编委/房长、普通族人、游客)按各自权限在各自端上看到新成员。整个过程由操作日志全程留痕,谁在何时提交、谁在何时审核,均可追溯;平台运营总管理中心在后台做多租户隔离管控,家族之间的数据互不可见。
这个旅程也回答了开头的反问:Excel 缺的不是"电子化",而是数据层的关系建模、逻辑层的校验与版本、展现层的多端协同——以及横跨三层的那套权限与风控底座。
