
快递地址解析接口接入实战:参数设计、调用示例与常见问题
一、技术简介
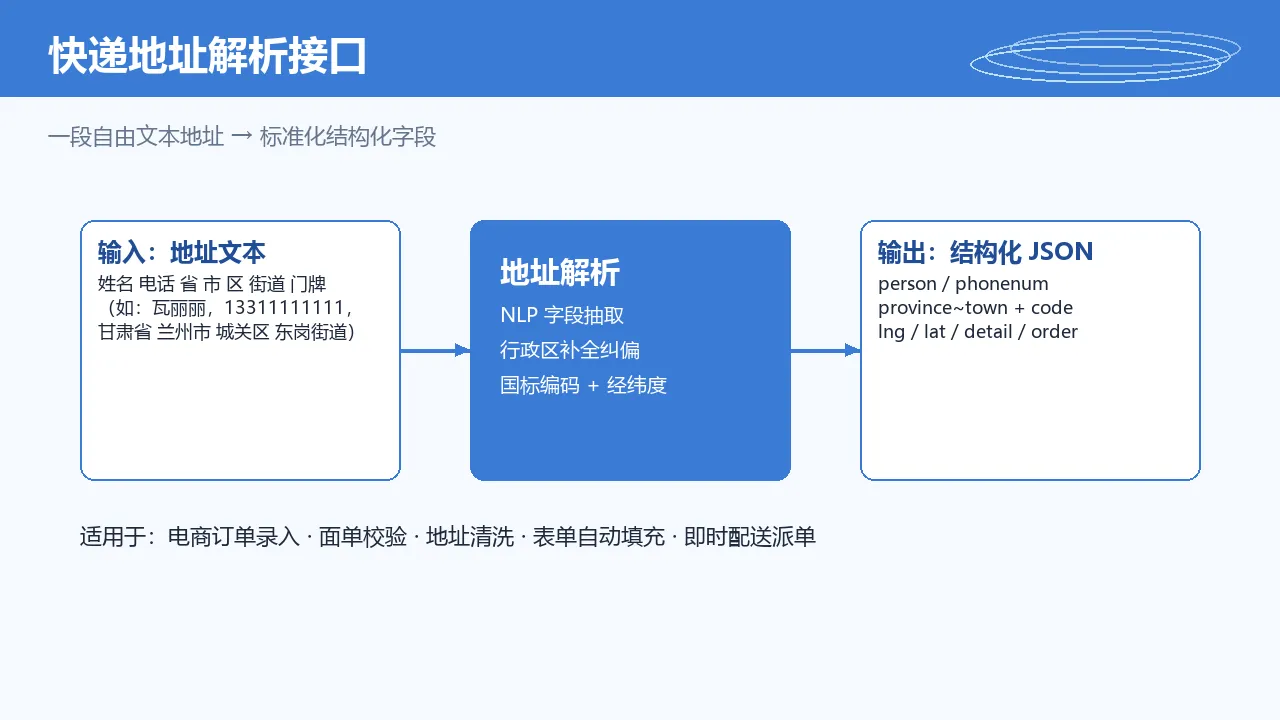
快递地址识别解析与填充服务是一个基于自然语言处理(NLP)的地址结构化能力接口。输入一段快递填单文本(通常包含姓名、电话、省市区县街道门牌等信息),接口将其切分为标准字段,并对缺失的行政区域做自动补全与纠正,最终输出结构化的姓名、电话、省、市、区、街道、经纬度及各层级国标行政编码。该接口面向快递物流、电商订单、外卖配送等需要批量处理地址文本的系统,提供稳定的字段抽取与归一能力,可作为单据自动化录入、地址校验与数据清洗链路中的一环。
二、能力概览
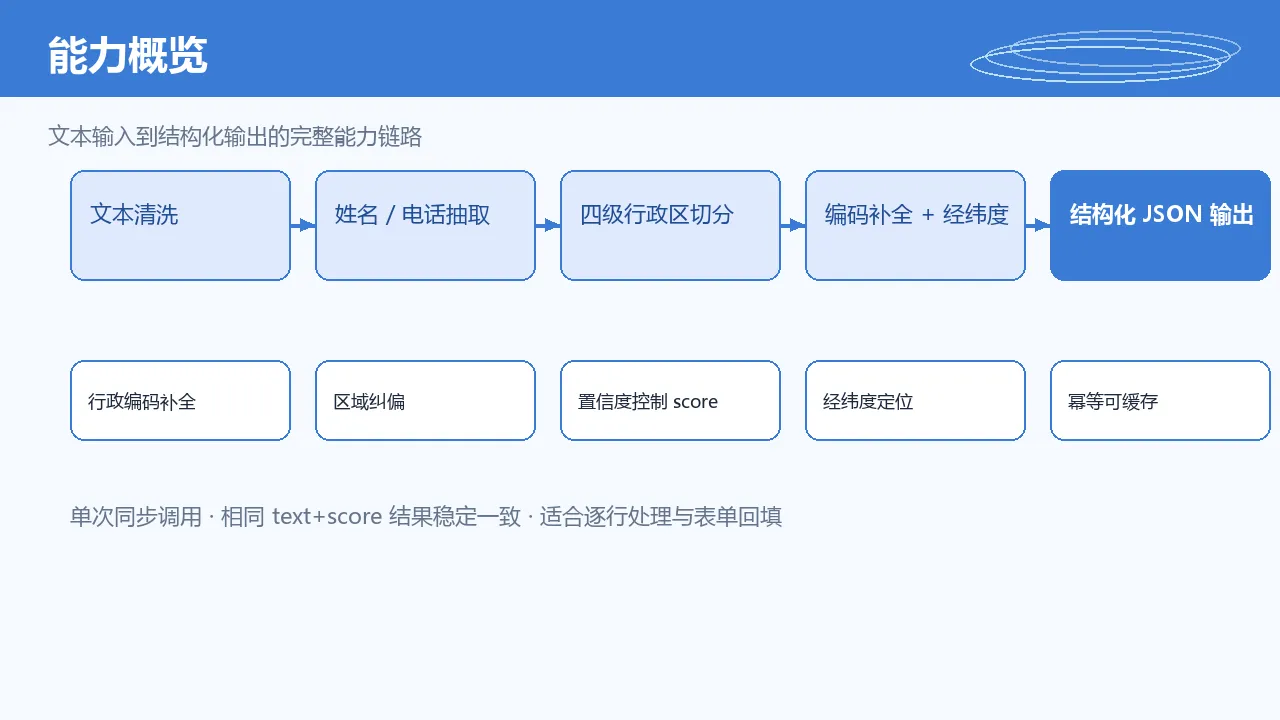
| 能力项 | 说明 |
|---|---|
| 姓名抽取 | 从自由文本中识别收件人姓名 |
| 电话识别 | 抽取手机号,支持常见分号 / 空格分隔 |
| 行政区划解析 | 省、市、区(县)、街道(乡 / 镇)四级切分 |
| 行政编码补全 | 输出省 / 市 / 区县 / 街道国标行政编码 |
| 经纬度定位 | 返回地址对应的经度、纬度 |
| 区域补全纠正 | 对不完整的地址做行政区级别补全与纠偏 |
| 置信度控制 | 通过 score 参数调节结果阈值 |
| 结构化输出 | 标准 JSON 字段,便于直接入库或校验 |
接口为同步调用,单次请求返回一段文本的解析结果,适合作为单据逐行处理或表单自动填充的数据源。
三、适用场景
- 电商 / 物流订单录入:将客户提交的自由文本地址自动拆分入库,减少人工录入。
- 快递面单识别后的字段校验:OCR 出文本后,用该接口做结构化归一与行政区纠错。
- 外卖 / 即时配送地址解析:把用户手填地址切分为省市区街道门牌,用于派单与距离估算。
- 数据清洗与地址标准化:存量地址库批量重解析,补齐国标编码与经纬度。
- 表单自动填充:在录入页根据一段完整地址自动回填多个输入框。
四、接入流程
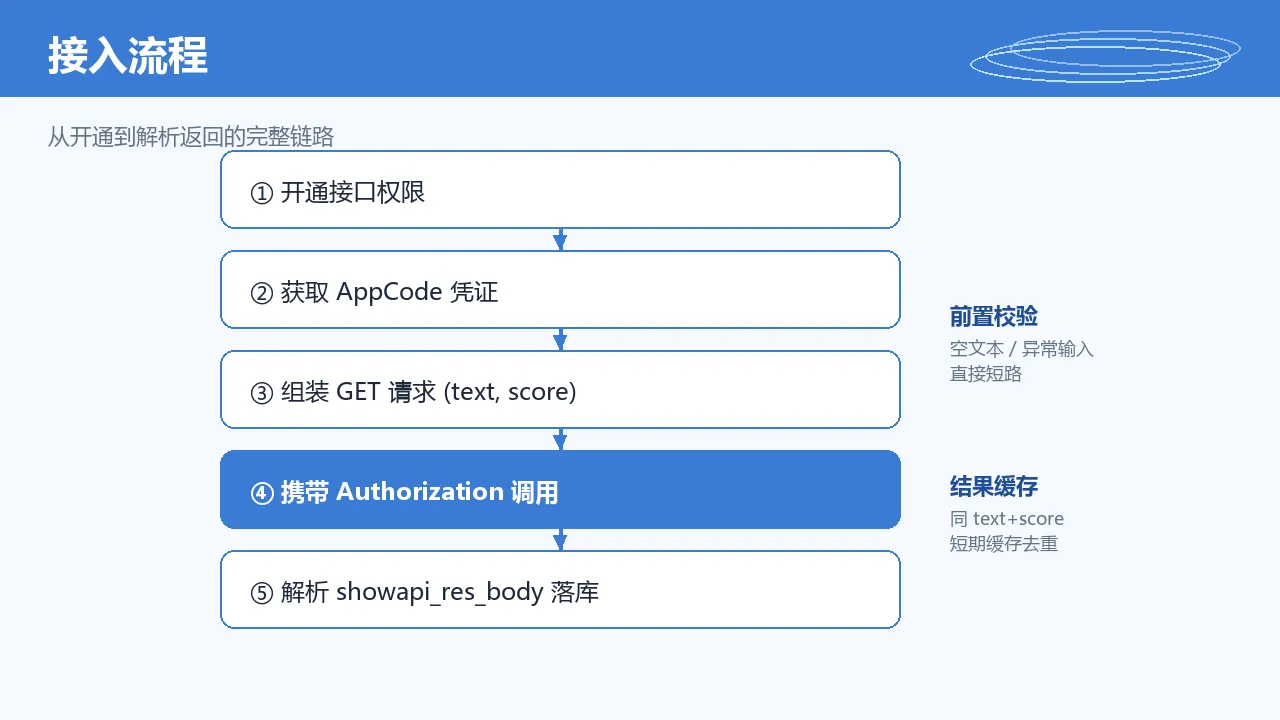
整体接入路径为:开通接口权限 → 获取调用凭证 → 组装请求 → 发起调用 → 解析返回。
开通接口
   │
   ▼
获取 AppCode(或 AppKey/AppSecret)
   │
   ▼
组装 GET 请求(Query: text, score)
   │
   ▼
携带 Authorization 头发起调用
   │
   ▼
解析 showapi_res_body,落库 / 回填
调用前建议先做一次前置校验:空文本、明显格式异常的输入直接短路,避免无效请求。生产环境应对同一 text 做结果缓存,降低重复解析成本。
五、调用示例与返回结构
请求说明
- 请求方式:
GET - 请求路径:
/address/analysis - 调用地址与鉴权方式:见控制台接口文档
- 鉴权:在请求头携带
Authorization: APPCODE <appcode>(简单身份认证方式;签名认证方式可用 AppKey & AppSecret)
Query 参数
| 字段 | 类型 | 必填 | 说明 |
|---|---|---|---|
text |
string | 是 | 详细地址文本,内容越完整,解析越准确 |
score |
string | 否 | 结果置信度,取值 0–100。数值越高,返回结果越精确,但对输入完整度要求也越高,建议按自身场景实测后调整 |
Java 示例
public static void main(String[] args) {

    String host = "https://<your-endpoint>.alicloudapi.com";
    String path = "/address/analysis";
    String method = "GET";
    String appcode = "YOUR_APPCODE";

    Map<String, String> headers = new HashMap<>();
    headers.put("Authorization", "APPCODE " + appcode);

    Map<String, String> querys = new HashMap<>();
    querys.put("text", "瓦丽丽,13311111111,甘肃省 兰州市 城关区 东岗街道向阳街道");
    querys.put("score", "75");

    try {

        HttpResponse response = HttpUtils.doGet(host, path, method, headers, querys);
        System.out.println(response.toString());
    } catch (Exception e) {

        e.printStackTrace();
    }
}
Python 示例
import requests

resp = requests.get(
    "https://<your-endpoint>.alicloudapi.com/address/analysis",
    params={

        "text": "瓦丽丽,13311111111,甘肃省 兰州市 城关区 东岗街道向阳街道",
        "score": "75",
    },
    headers={
   "Authorization": "APPCODE YOUR_APPCODE"},
    timeout=10,
)
print(resp.json())
返回结构
顶层为网关通用结构,业务字段位于 showapi_res_body:
{

  "showapi_res_error": "",
  "showapi_res_code": 0,
  "showapi_res_id": "608bc5a58d57bab77d55f7b9",
  "showapi_res_body": {

    "person": "瓦丽丽",
    "phonenum": "13311111111",
    "province": "甘肃省",
    "province_code": "620000",
    "city": "兰州市",
    "city_code": "620100",
    "county": "城关区",
    "county_code": "620102",
    "town": "东岗街道",
    "town_code": "620102015",
    "detail": "其他信息",
    "lng": "103.91963",
    "lat": "36.053326",
    "text": "瓦丽丽,13311111111,甘肃省 兰州市 城关区 东岗街道向阳街道",
    "order": "1388054004281376768",
    "ret_code": 0
  }
}
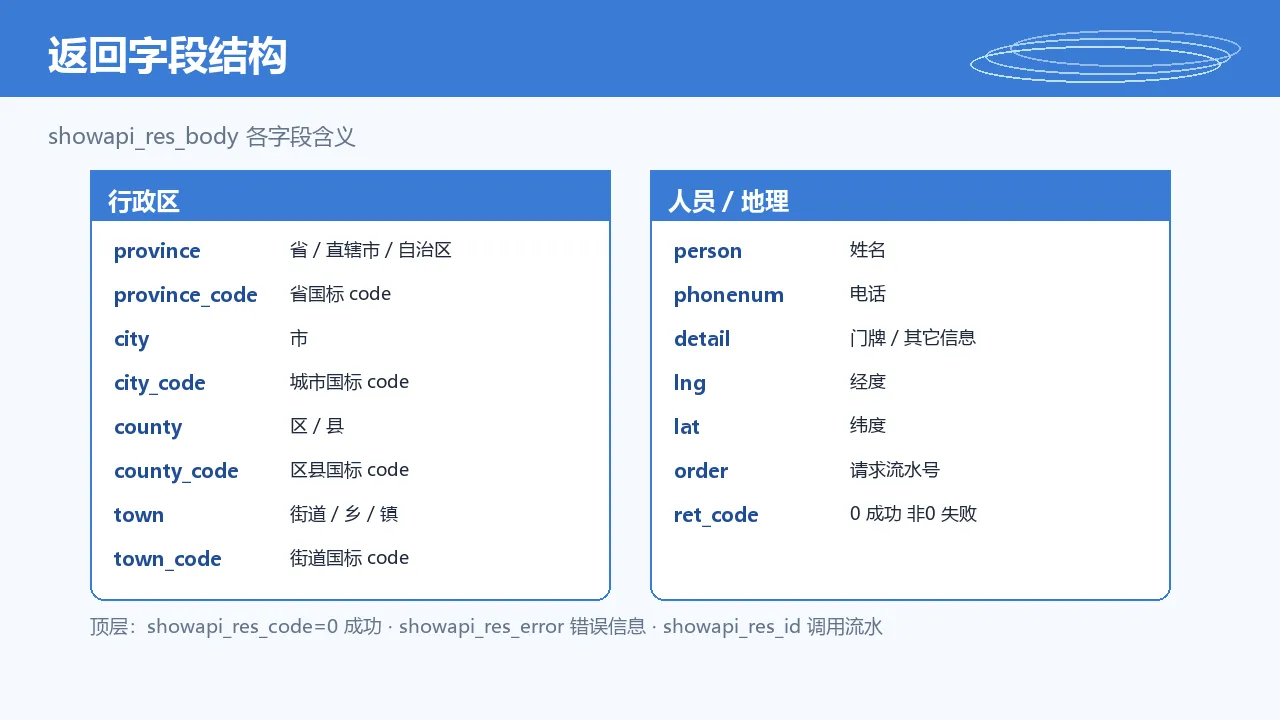
字段说明:province/city/county/town 为四级行政区名称,对应 _code 为国标行政编码;detail 为门牌 / 其它补充信息;lng/lat 为经纬度;order 为请求流水号;ret_code 为 0 表示成功,非 0 表示失败。
六、在线调试实录
以「甘肃省 兰州市 城关区 东岗街道向阳街道」为示例输入,score 取 75。请求返回后,showapi_res_body 中省 / 市 / 区县 / 街道四级字段均被完整识别,国标编码与经纬度同步产出。当输入仅含「甘肃省 兰州市」等不完整信息时,接口会在 town、detail 等字段做补全或留空,ret_code 仍为 0;当文本无法解析出有效地址时,顶层 showapi_res_code 会非 0 并给出错误信息。
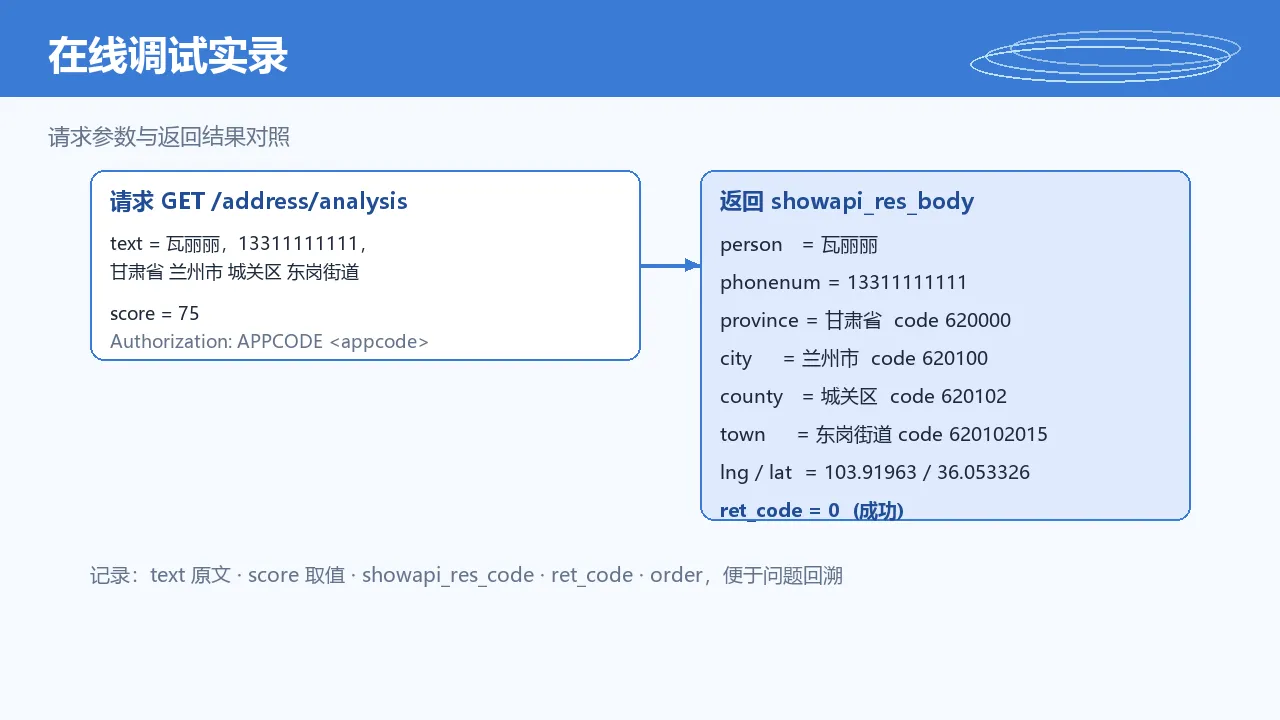
调试时建议同时记录:请求 text 原文、score 取值、showapi_res_code 与 ret_code,用于后续问题定位。
七、调用限制与规范
- 扣费规则:仅当 HTTP 状态码为 200 时计数扣减,非 200 响应不扣费;具体扣费口径以控制台实时规则为准。
- 请求方式:
GET,text与score通过 Query 传递,无 Header 业务参数、无 Body。 - 输入规范:
text越完整,字段越准确;建议传入含省市区街道门牌的完整文本。 - 结果置信度:
score影响解析阈值,建议结合目标场景做 A/B 实测后再固定取值。 - 幂等与缓存:接口为纯函数式解析,相同
text+score结果一致,可对同输入做短期结果缓存。 - 合规:涉及个人信息(姓名、电话)时遵循最小必要原则,传输加密,日志脱敏,避免长期留存原始文本。
八、能力边界与免责
- 支持:中文地址文本的结构化抽取、行政区划补全、经纬度定位、国标编码输出。
- 不支持 / 边界:港澳台及境外地址的行政编码体系与国内国标不一致,解析能力受限;非地址类文本(纯营销文案、无地理信息)无法给出有效结构化结果。
- 数据说明:接口输出为解析结果,字段可能随输入完整度变化;经纬度为估算值,非精确定位。
- 免责:解析结果仅供参考,业务方应结合自身校验逻辑与人工抽检使用,不对基于该结果的业务决策承担责任。
九、错误码排查
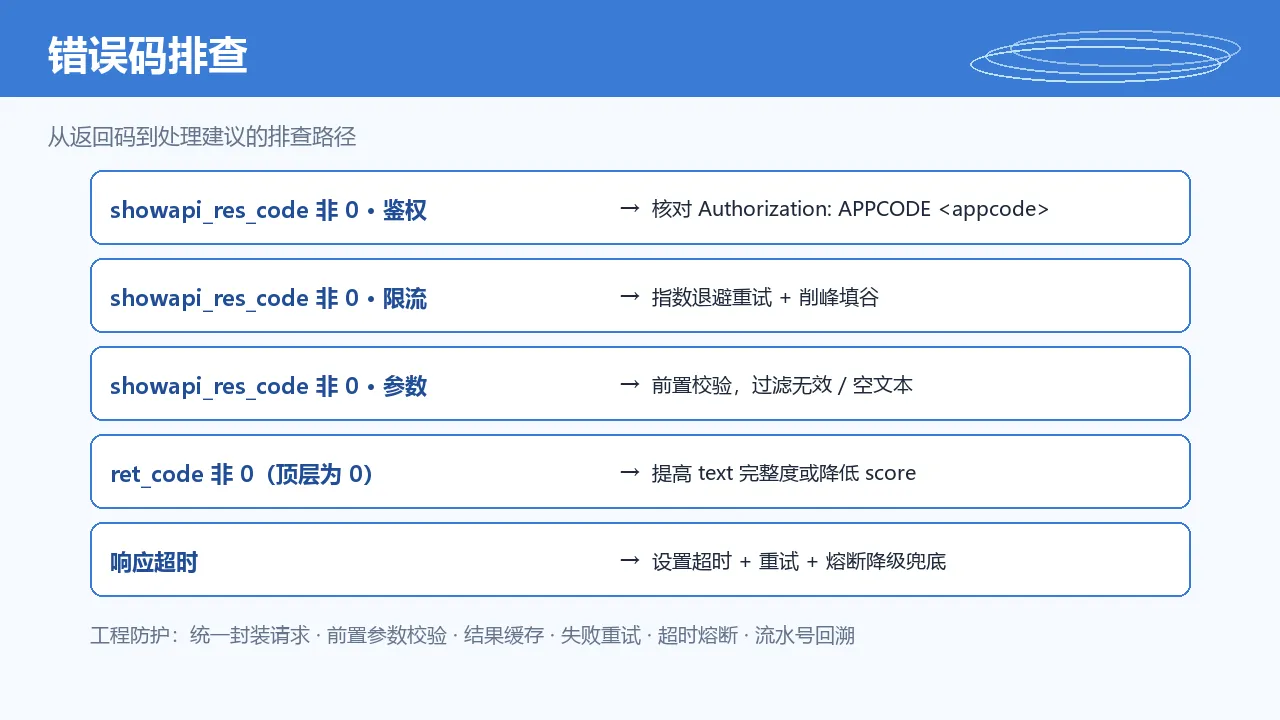
接口采用网关通用返回结构。showapi_res_code = 0 为成功;非 0 时表示调用失败,showapi_res_error 携带错误描述。常见排查方向:
| 现象 | 可能原因 | 处理建议 |
|---|---|---|
showapi_res_code 非 0 且提示鉴权 |
AppCode 缺失 / 失效 / 拼写错误 | 核对请求头 Authorization: APPCODE <appcode> |
showapi_res_code 非 0 且提示限流 |
触发频率限制 | 加退避重试,削峰填谷,必要时扩容 |
showapi_res_code 非 0 且提示参数 |
text 为空或格式异常 |
前置校验,过滤无效输入 |
ret_code 非 0(顶层 code 为 0) |
地址无法解析 | 提高 text 完整度,或降低 score |
| 响应超时 | 网络抖动 / 下游延迟 | 设置合理超时 + 重试 + 熔断降级 |
建议对请求做统一封装:前置参数校验、失败重试(指数退避)、结果缓存、超时熔断与降级兜底,并记录每次调用的流水号便于回溯。
十、技术 FAQ
Q:text 参数可以只传手机号或姓名吗?
A:可以传入,但字段越完整,省市区街道等结构化结果越准确;只有手机号时,行政区与经纬度字段可能为空。
Q:score 应该固定为多少?
A:score 是解析置信度阈值。数值越高要求输入越完整,建议先用少量真实样本实测,再按自身场景固定取值。
Q:非 200 响应会被计数吗?
A:不会。仅 HTTP 200 响应计数扣减,非 200 不计数。
Q:同一个地址重复调用结果会一致吗?
A:相同 text 与 score 的解析结果稳定一致,可做短期结果缓存降低重复调用。
Q:能解析境外地址吗?
A:接口面向国内行政区划体系,境外地址的行政编码与经纬度能力有限,建议使用对应地区的地址解析方案。
Q:涉及个人信息如何合规使用?
A:遵循最小必要原则,仅收集与业务相关的地址字段;传输加密、日志脱敏、不长期留存原始文本,并向用户告知用途。
Q:接口能否用于 ERP / 小程序 / APP 对接?
A:可以。作为标准 HTTP 接口,可在后端服务中封装后供 ERP、小程序、APP 调用,避免在前端直接暴露调用凭证。
Q:解析失败如何定位?
A:优先看顶层 showapi_res_code 与 showapi_res_error;业务字段异常再看 ret_code;结合请求流水号 order 回溯。
十一、内容小结
快递地址识别解析与填充服务把「一段自由文本地址 → 结构化字段」的过程标准化,输出姓名、电话、四级行政区、国标编码与经纬度,适合作为单据录入、面单校验、地址清洗链路的解析环节。接入时关注三点:一是 text 输入越完整结果越准,二是用 score 按场景调参,三是做好前置校验、结果缓存与失败重试等工程防护。输出仅供参考,请结合自身校验与人工抽检使用。


