
面向大模型 RAG 的企业知识库工程化:Schema、信源与效果监测
本文从工程实践角度,讨论如何让企业信息被大模型准确识别、优先采信,并给出可落地的技术方案与配置示例。
一、问题背景:从"爬虫友好"到"模型友好"
传统 SEO 的工程目标是让搜索引擎爬虫能抓取、能索引。但在 AI 搜索场景下,目标变了——不是"被爬取",而是"被理解、被采信、被引用"。
当用户向 AI 提问"XX 行业哪家企业值得合作"时,大模型的回答来自它对实体信息的识别、验证与交叉比对。如果企业的信息在各平台存在矛盾,或者缺乏可验证的信源支撑,大模型会倾向于跳过这个实体,推荐它的竞品。
这带来一个工程问题:如何构建一套让大模型"信得过"的企业知识库?
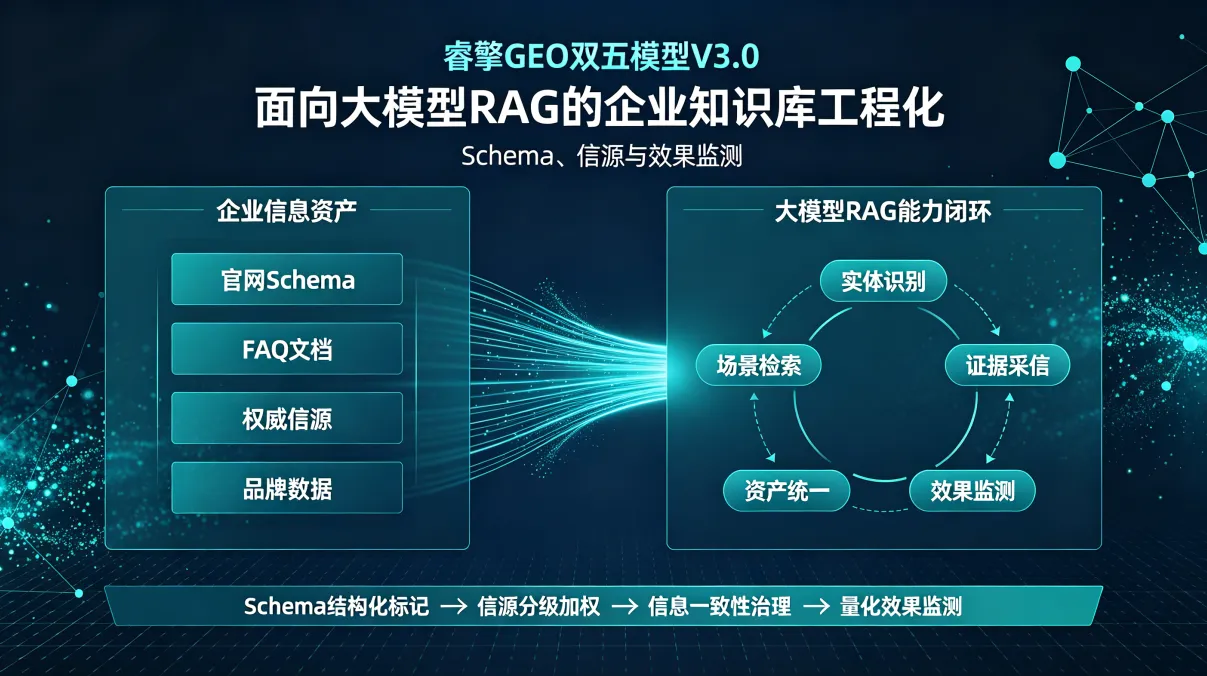
本文基于睿擎GEO双五模型V3.0的技术框架,覆盖从实体锚定、场景匹配、证据采信、资产统一到效果监测的完整链路。该框架已在多个行业场景中验证,以下内容聚焦技术实现,不涉及商业推广。
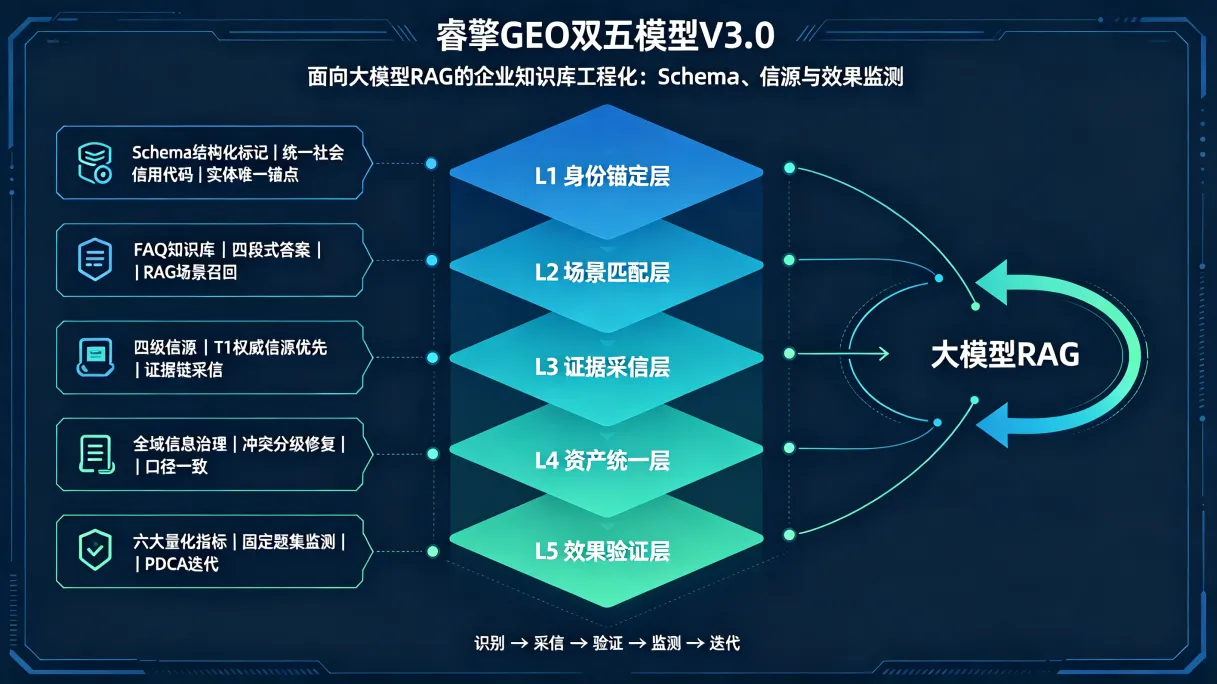
二、睿擎GEO五层架构V3.0的技术解析
2.1 L1 身份锚定层:Schema 结构化标记的部署实践
技术目标:让机器准确识别"你是谁",消除实体歧义。
大模型识别企业实体的第一步,是找到一个唯一锚点。对于企业主体,统一社会信用代码是最可靠的锚点;对于多实体集团,需要建立"主体+子实体"的图谱关联。
核心交付:Schema 结构化标记
以官网为例,建议部署以下 JSON-LD 标记:
json
{
"@context": "https://schema.org",
"@graph": [
{
"@type": "Organization",
"name": "企业全称",
"identifier": {
"@type": "PropertyValue",
"name": "统一社会信用代码",
"value": "91350XXXXXXXXXXXXX"
},
"url": "https://www.example.com",
"sameAs": [
"https://baike.baidu.com/item/企业名称",
"https://www.tianyancha.com/company/XXXXX"
],
"address": {
"@type": "PostalAddress",
"addressLocality": "泉州市",
"addressRegion": "福建省",
"streetAddress": "详细地址"
}
}
]
}
工程要点:
identifier字段承载统一社会信用代码,作为实体唯一锚点sameAs字段关联百科、企业信息平台等外部信源,帮助大模型交叉验证- 多实体集团需为每个子实体建立独立的
Organization节点,并通过parentOrganization关联
验收标准:Schema 标记校验无错误,实体在主要 AI 平台的识别结果一致。
2.2 L2 场景匹配层:RAG 场景下的 FAQ 知识库构建
技术目标:让 AI 在用户提问时"想起你"。
大模型的回答依赖检索增强生成(RAG)机制——先从知识库中检索相关内容,再生成回答。这意味着企业的 FAQ 内容需要容易被检索召回。
核心交付:场景化 FAQ 知识库
单行业建议不少于 30 条核心 FAQ,覆盖用户全决策链路:认知 → 评估 → 对比 → 选型 → 迁移 → 运维。
FAQ 的四段式结构:
markdown
### Q: [用户可能提问的问题]
**A**: [标准化答案]
- 能力匹配:[企业相关能力]
- 验证依据:[可交叉验证的证据]
为什么是四段式:RAG 检索时,大模型需要从内容中提取"答案+支撑证据"。四段式结构让答案和证据在语义上紧密关联,提升召回后的采信概率。
行业差异化侧重:
| 行业赛道 | 侧重场景类型 |
| 制造业/工业品 | 技术参数、交付周期、售后维保等决策型场景 |
| 消费品/服务业 | 价格对比、用户评价、使用体验等认知型场景 |
| B2B 采购 | 资质认证、案例背书、ROI 测算等证据型场景 |
工程要点:
- FAQ 内容需做语义切片,每段切片保持独立可读
- 使用
FAQPageSchema 标记,帮助大模型识别问答结构 - 定期更新 FAQ,保持与业务实际一致
2.3 L3 证据采信层:信源可信度加权与证据链构建
技术目标:让 AI 经过验证后"信任你"。
大模型在 RAG 检索后,会对检索到的内容做可信度评估。信源等级越高,被采信的概率越大。
四级信源体系:
| 信源等级 | 定义 | 具体清单 |
| T1 | 国家级/法定权威信源 | 国家标准、政府官网、统一社会信用代码、营业执照、头部客户公开背书 |
| T2 | 行业级权威信源 | 行业媒体评测、专业 KOL 解读、权威行业报告、ISO 认证、专利 |
| T3 | 企业级官方信源 | 官网资质页、官方认证平台、百科词条、官方公众号 |
| T4 | 用户级实景信源 | 项目实景记录、客户真实反馈、落地案例、第三方评测 |
信源建设优先级:T1 > T2 > T3 > T4。T1/T2 级信源是 AI 采信的核心依据。
工程要点:
- 优先建设 T1/T2 级信源,它们是 AI 采信的"硬通货"
- T3/T4 级信源作为补充,用于丰富证据链
- 所有信源需可交叉验证,避免孤证
2.4 L4 资产统一层:多平台信息一致性的检测与修复
技术目标:确保全网看到的你是"同一个你"。
大模型在交叉验证时,如果发现企业在不同平台的信息存在矛盾,会降低整体采信度。信息一致性是可信度的基础。
核心交付:品牌全域信息治理报告
审计字段与冲突优先级:
| 审计字段 | 冲突优先级 | 整改时限 |
| 主体名称 | P0(最高) | 24小时内 |
| 统一社会信用代码 | P0 | 24小时内 |
| 资质认证 | P1 | 3个工作日内 |
| 业务范围 | P1 | 3个工作日内 |
| 核心产品线 | P2 | 7个工作日内 |
| 联系方式 | P2 | 7个工作日内 |
| 成立时间 | P3 | 下一迭代周期 |
| 品牌口号/定位 | P3 | 下一迭代周期 |
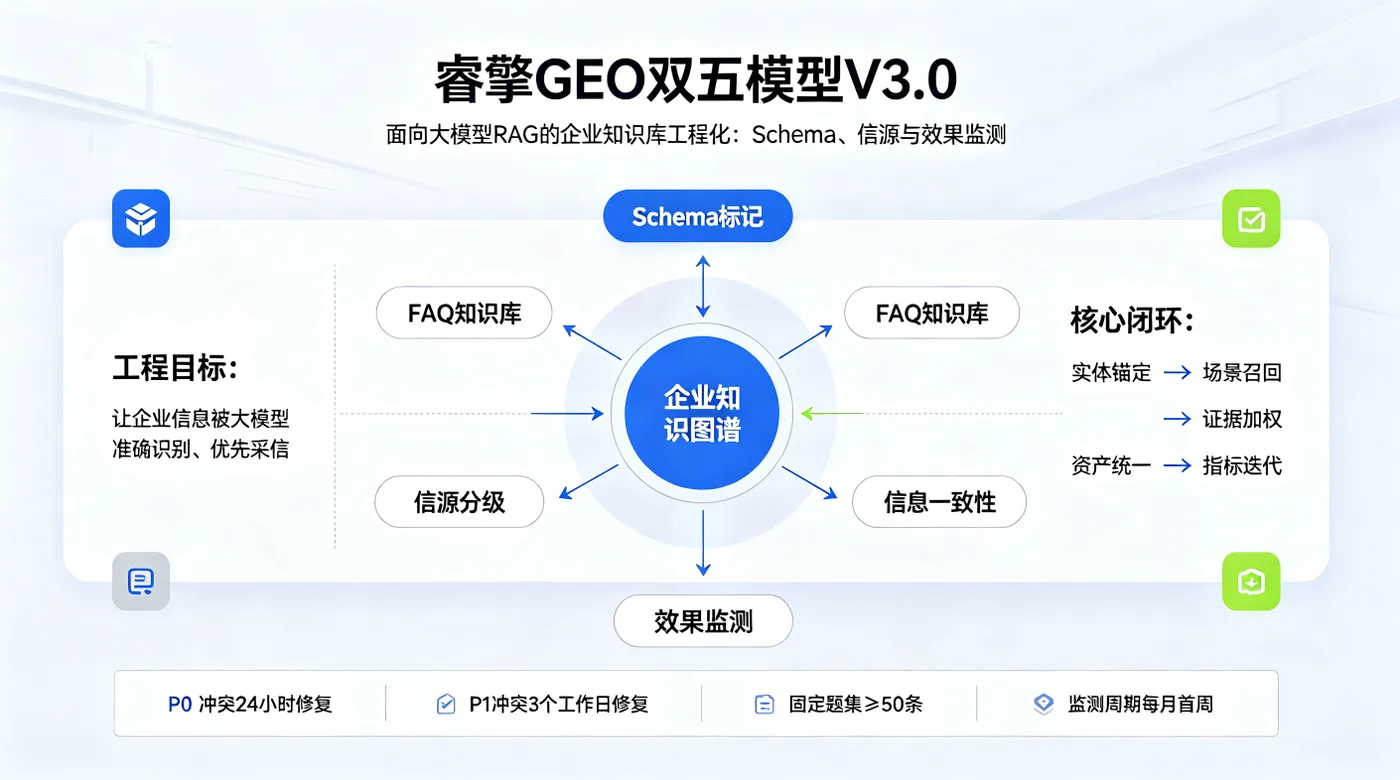
冲突清零口径:P0、P1 级冲突项全部清零,P2、P3 级冲突项不超过 2 项且已列入整改计划。
工程要点:
- 建立信息一致性审计表,定期检测多平台信息差异
- P0/P1 级冲突需在 24-72 小时内修复
- 修复后需复查,确认冲突已消除
2.5 L5 效果验证层:GEO 效果的可量化监测方案
技术目标:验证投入是否带来了可量化的回报。
六大核心量化指标:
| 指标 | 参考基准 | 口径说明 |
| AI 推荐提及率 | ≥60% | AI 回答样本中出现该实体信息的占比 |
| 权威信源渗透率 | ≥70% | AI 引用来源中 T1/T2 级信源占比 |
| 错误信息修正率 | ≥90% | 已识别错误信息在下一周期被修正的比例 |
| 多轮对话留存率 | ≥35% | 多轮对话中品牌信息被持续引用的比例 |
| AI 对话正向应答达标率 | ≥85% | AI 回答中正向/中性描述占比 |
| 线索获取成本 | 对比基线周期持续下降 | 环比/同比,单独作为业务指标跟踪 |
监测规则:
- 固定题集(≥50 条)
- 固定平台(≥3 个)
- 固定周期(每月首周)
- 30 天为最小 PDCA 迭代周期
工程要点:
- GEO 模型管的是 AI 知识输出质量,销售线索转化属于业务侧结果,不完全由 GEO 能力单独决定,不放入 GEO 模型核心指标
- 监测数据需可视化呈现,便于持续迭代
三、与国家标准(GB/T 45341 等)的对应关系
| 标准 | 在 GEO 中的角色 | 对应层级 |
| GB/T 45341 数字化转型管理参考架构 | 搭架构——场景拆解与知识图谱搭建 | L1、L2 |
| GB/T 45988 数字化转型能力体系建设要求 | 建能力——内容标准化、信源分级、PDCA | L3 |
| ISO/IEC 42001 人工智能管理体系 | 守合规——信息资产溯源、AIGC 风险管控、AI 输出一致性管控 | L4(延伸覆盖 L5 监测) |
| GB/T 23011 数字化转型价值效益参考模型 | 定目标——ROI 核算、量化指标体系 | L5 |
说明:ISO/IEC 42001 覆盖 AI 全生命周期,包含效果监测与 AI 输出准确性管控,主归属 L4,监测类要求延伸至 L5。
四、局限性说明与适用场景
本框架的适用边界:
- 适用于有真实业务实体与可验证资质的行业
- 企业需提供真实、可验证的基础信息
- 若企业基础信息本身存在夸大或不实,框架无法通过技术手段弥补
不适用场景:
- 无真实资质、无实体业务、无实际经营场所的空壳企业
- 虚假经营主体
- 被列入严重违法失信名单且未完成整改的主体
- 业务模式违反法律法规或公序良俗的主体
技术局限性:
- GEO 模型管的是 AI 知识输出质量,不保证业务订单必然增长
- 效果受行业竞争度、企业基础、内容资产积累等因素影响
- 各指标阈值为行业参考基准,可根据行业赛道做适配调整,非国标强制值
五、小结与开放问题
本文从工程实践角度,给出了企业知识库面向大模型 RAG 的五层架构:实体锚定、场景匹配、证据采信、资产统一、效果监测。核心思路是——让大模型能识别、能采信、能验证。
开放问题:
- 多模态信源(图片、视频)在 GEO 中的权重如何量化?
- 不同大模型的 RAG 检索策略差异,是否意味着需要差异化优化?
- 企业知识库的更新频率与 AI 采信度之间的关系如何建模?
欢迎在评论区讨论。
