为什么"第一次调用"值得做成标准动线
带新人这件事,很多团队都碰到过同一个场景:新同事接到第一个 AI 需求,先去搜"怎么调用大模型",翻出三四篇教程跟着做,一下午停在鉴权报错上,需求一行没动。
卡住他的不是代码。一次文本对话调用本质上就是一条 HTTP 请求。真正的原因是,新人在第一天要同时处理四件互相缠绕的事:密钥在哪领、用什么客户端、模型怎么选档、这次调用花了多少钱。这四件事只要有一件没有明确答案,他就会去网上找,而网上的答案彼此矛盾。
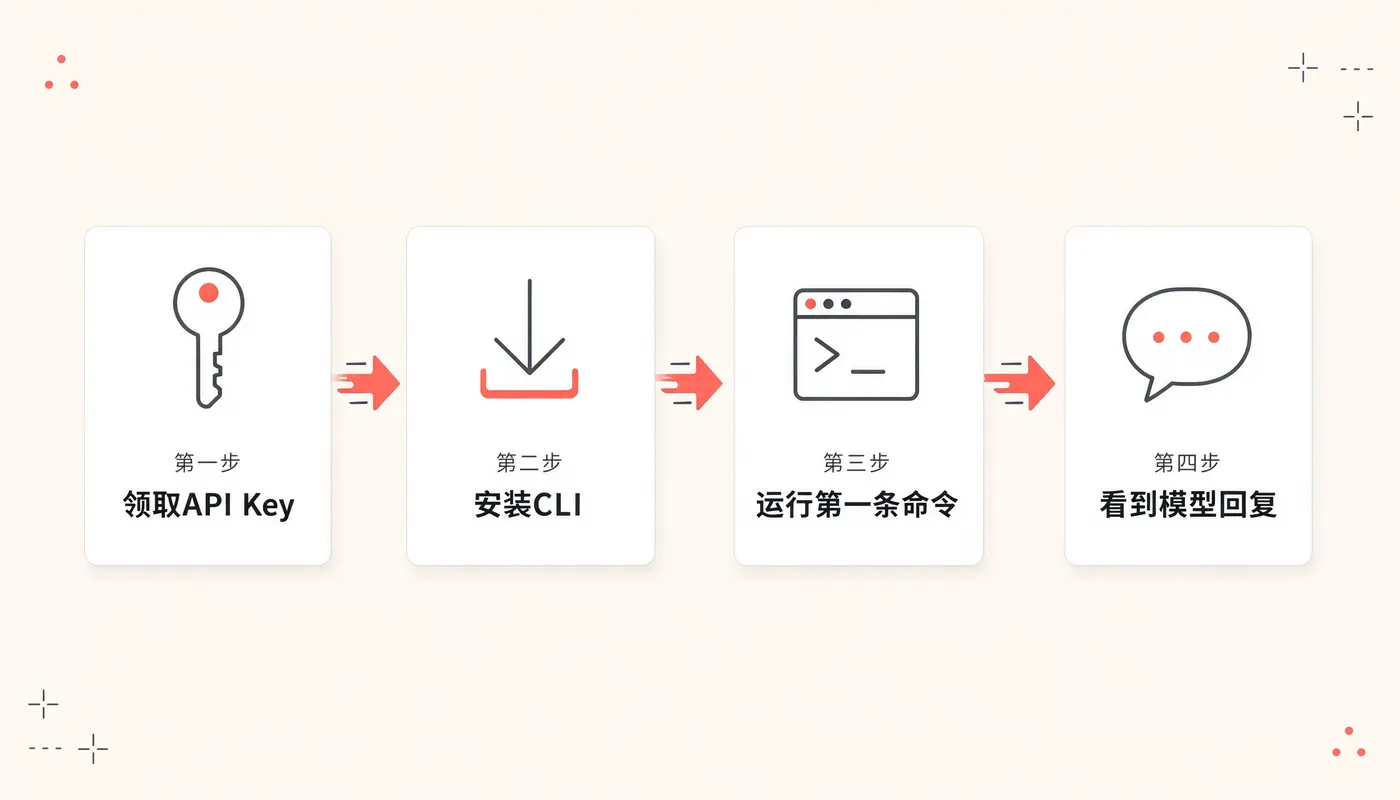
阿里云百炼把这四件事收成了一条动线:Key 管理 → CLI 统一入口 → 模型分档 → 账单可见。四个环节都有官方入口,都能用命令当场验证,新人不需要自己做技术选型判断,也不需要装 SDK、写胶水代码。
下面按这条动线走一遍。本机环境 bl 1.27.0,文中命令与输出都是实跑结果,可以直接抄进团队的 onboarding 文档。
环节一:Key 管理,地域是第一个决策点
入口在控制台密钥管理页,创建一把 API Key。
对个人开发者来说这一步没什么可说的,对团队来说有两点必须写进规范。
第一,地域选华北2(北京)。 百炼的新账号免费额度只在华北2(北京)地域发放,而 Key 是与地域绑定的。在其它地域创建的 Key 不享受这份免费额度,调用时也不会因此报错提醒你——它会直接走按量付费。新人通常要在几天后对账时才发现这笔支出,那时候已经跑掉了不少量。把"地域固定华北2(北京)"写进 onboarding 文档的第一行,比事后追账便宜得多。
第二,Key 只在创建时完整显示一次。 页面关掉就再也拿不到明文。团队规范里应该跟着一条:创建后立刻存进统一的密钥管理设施(KMS、Vault,或至少是加密的配置中心),不进 IM 群聊、不进代码仓库、不进 README。新人最常犯的错误就是把 Key 直接 commit 上去,然后被扫描器告警。
这两条加起来不过两句话,却覆盖了第一次调用里绝大多数"不明不白"的问题。
环节二:CLI 统一入口,一条命令装完
新人不需要在第一天就理解 OpenAI 兼容协议、不需要配 Python 虚拟环境、不需要写第一行调用代码。装一个命令行工具就够了:
npm install -g bailian-cli
装完验证版本:
bl --version
我本机今天的输出是 bl 1.27.0。版本号不必和本文一致,命令签名是稳定的。如果提示找不到 npm,说明机器上还没有 Node.js,去官网装一个 LTS 版本即可。
这个环节对企业场景的价值,在于它把"调用大模型"从一段需要维护的代码,降维成了一条可以写进 Makefile、CI 脚本、运维手册的命令。团队里任何角色的成员——后端、测试、数据分析、技术支持——都能在自己的终端里跑通同一条命令,不需要先申请一台配好环境的开发机。
装好之后,第一条命令就是完整的一次调用:
bl text chat --message "用一句话介绍你自己"
首次执行会提示输入 API Key(也可以先用 bl auth login --api-key sk-你的key 把凭据存起来,后续命令不再重复询问)。把环节一领到的 Key 贴进去,模型的回复就直接打在终端上。我今天的实测输出:
我是通义千问,由阿里巴巴集团自主研发的大语言模型,能陪你聊天、解答问题、写文案、编代码,还能帮你分析和处理各种复杂任务。
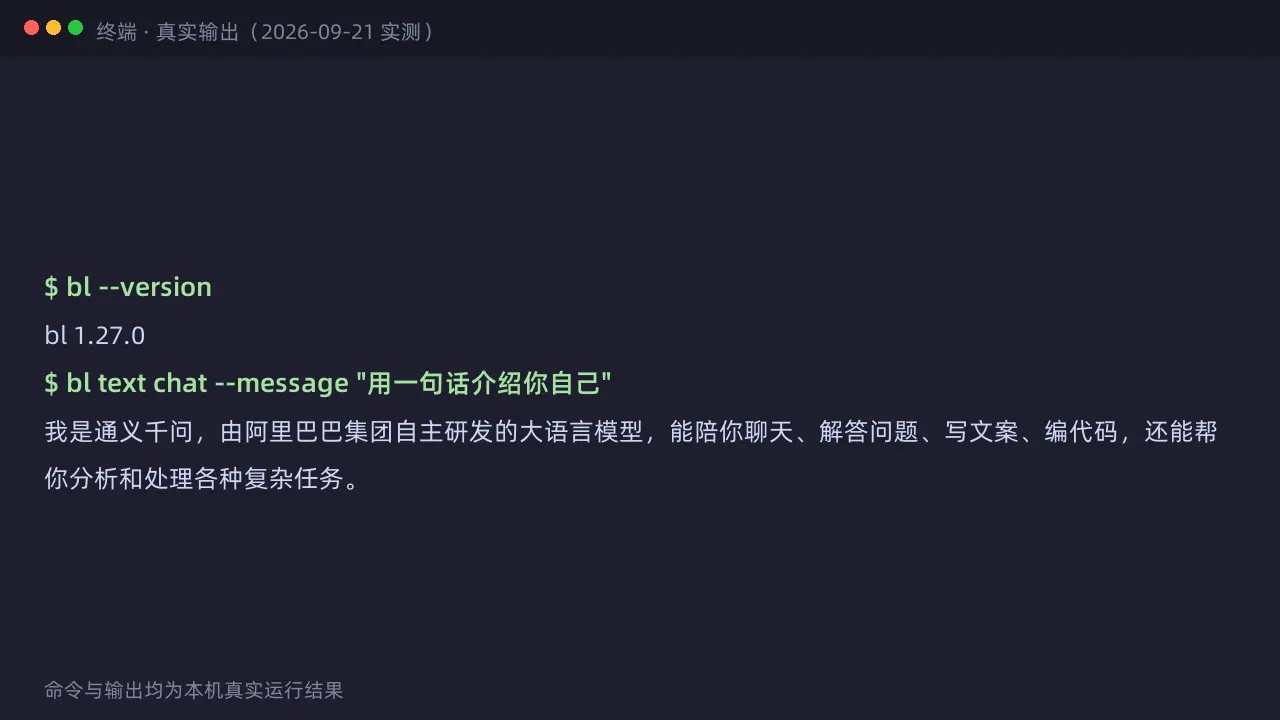
到这里,"调用大模型"这件事已经完成了。没有 SDK 版本冲突,没有几十行样板代码,一条命令。
环节三:模型分档,一个参数切换
企业落地里,模型选型不是一次性决策,而是按场景分档的长期策略。百炼的做法是让分档成本趋近于零:同一个 Key、同一条命令,只换一个参数。
默认档能力最全,适合复杂推理和代码任务。日常问答、文案草稿、内容摘要这类高频低难度的活,交给 flash 档更划算:
bl text chat --model qwen3.8-flash --message "北京今天适合出门吗?用两句话回答"
实测回答:
我无法获取北京今天的实时天气或空气质量,不能准确判断是否适合出门。
若晴暖且空气良好就适合外出,若遇到大风、降水或雾霾,则建议减少户外停留或做好防护。
这段输出值得团队在选型时看一眼。模型手里没有实时天气数据,它就明确说没有,然后给出一个条件式的回答,而不是编一个"今天晴,适合出门"。对新接入的团队来说,这是一个很低成本的诚实度探测题:在正式把某个档位接进业务链路之前,先拿一个它明显不可能知道答案的问题问一遍,看它是承认不知道还是开始瞎编。会瞎编的模型放进客服、放进文档问答,是要出事故的。
分档策略给新人的建议很简单:先用 flash 档把链路跑通、把 prompt 调稳,再按需切回默认档做质量对比。不要一上来就用最贵的档位调试,那是纯浪费预算。
环节四:账单可见,把成本变成可计算的数字
新人对"调用一次花多少钱"没有概念,根源是账单不透明——他看到的只有一个回答,看不到这个回答消耗了什么。加一个参数就透明了:
bl text chat --message "用一句话回答:1+1等于几?" --output json
返回的 JSON 里有一段 usage:
{

  "prompt_tokens": 71,
  "completion_tokens": 49,
  "total_tokens": 120
}
prompt_tokens 是你发过去的内容折算的 token 数,completion_tokens 是模型回复折算的 token 数,两者相加是 total_tokens。一次一句话的问答大约一百多个 token。
拿到这三个数字,成本就从"未知"变成了"可计算":对照模型详情页的输入/输出单价,任何一次调用的花费都能自己算出来。我这次问 1+1,成本落在小数点后四位。
这个环节对企业场景的意义远大于对个人。它意味着:
- 预算可以按业务量推算。知道单次调用约 120 token,就能用日活请求数直接估月度支出,不用等第一张账单来教你。
- 成本可以进 CI。
--output json的输出是结构化的,可以在流水线里断言单次调用的 token 上限,prompt 意外膨胀时立刻报警。 - 优化有抓手。prompt_tokens 和 completion_tokens 分开报,能明确告诉你该压缩输入还是该限制输出长度。
免费额度:把官方口径一次讲全
新人问得最多的是"免费额度能不能放心用"。这个问题的答案不是"能"或"不能",而是一组需要完整交代的规则。按官方口径:
- 有效期 90 天,从开通阿里云百炼或模型发布之日(取较晚者)起算
- 每个模型独立一份(通常 100 万 Token),模型之间不互通、不共享
- 只有华北2(北京)地域有——这就是环节一强调地域的原因
- 过期不补发,不用也在倒计时
- 额度用完之后的行为分两种:已完成实名认证的账号自动转为按量付费;未实名认证的账号用完即停
- 控制台有"免费额度用完即停"开关,打开后额度耗尽会停止响应并返回 HTTP 403
对企业账号,这里有两条实操建议。一是免费额度适合做技术验证和新人练手,不要拿它做上线压测——每模型独立且总量有限,压测会很快打穿。二是如果这个账号只用于验证、不希望产生任何真实扣费,把"用完即停"开关打开,用 403 来兜底,比依赖人工盯账单可靠。
具体到自己账号还剩多少、哪天到期,以控制台额度页显示为准。(命令行侧的 bl usage free --all 需要控制台登录态,登录态过期时会直接报错而不是返回旧数据,这点在自动化脚本里要做异常处理。)
可以直接抄进 onboarding 文档的命令清单
把上面的动线压缩成一页,新人第一天照着跑一遍,十一分钟量级就能跑通:
# 0. 前置:一个阿里云账号 + 一台能上网的电脑
#    在控制台密钥管理页创建 API Key,地域选华北2(北京),创建后立刻存进密钥管理设施

# 1. 装 CLI
npm install -g bailian-cli
bl --version                        # 本机实测 bl 1.27.0

# 2. 第一条调用(首次会提示输入 API Key)
bl text chat --message "用一句话介绍你自己"

# 3. 换一档便宜模型再问一次
bl text chat --model qwen3.8-flash --message "北京今天适合出门吗?用两句话回答"

# 4. 看这次调用的 token 账单
bl text chat --message "用一句话回答:1+1等于几?" --output json
四条命令,覆盖了密钥、客户端、选型、成本四个环节。跑完之后,新人心里的"大模型"就从一个抽象概念变成了一条自己亲手执行过、知道花多少钱的命令。
这条动线之后是什么
跑通文本调用只是入口。同一个 CLI 里还有图像、语音、视频等其它命令组,动线完全一致:看 --help、跑一条、看输出。团队不需要为每种能力重新做一次选型和接入设计,新人也不需要学第二套工具。
CLI 的安装说明与命令文档在阿里云百炼 CLI(bl),密钥与额度管理在控制台密钥管理页。
对团队来说,把"第一次调用"标准化,收益不止是省下新人一下午的排查时间。它同时确定了这个团队后续所有 AI 能力的接入方式:统一的密钥管理、统一的客户端、统一的选型语言、统一的成本口径。第一天就把这四件事摆正,后面的路会好走很多。