
随着大模型技术普及,很多开发者、科研人员、普通爱好者开始关注本地私有化大模型。云端接口虽然使用便捷,但会产生持续调用费用,业务数据需要外传,存在隐私泄露风险。Ollama作为一款免费开源的本地大模型运行框架,支持Windows、macOS、Linux全操作系统,可以在个人电脑、服务器本地运行各类开源大模型,断网环境依旧可以正常提供AI能力,业务数据完全保留在本机,不需要上传外部服务。当前主流版本为v0.32.x,汇集Qwen、DeepSeek‑R1、Llama、Gemma、Qwen2.5‑VL多模态等海量开源模型,一条终端命令就可以完成模型拉取、启动运行,同时原生兼容OpenAI标准API,各类AI客户端、Agent开发框架几乎不用修改代码,就可以对接本地模型,是本地大模型开发调试的主流工具。很多新手初次接触Ollama,常常会遇到安装失败、C盘被模型文件占满、硬件内存不足程序闪退、下载模型速度缓慢、无法局域网访问服务、API接口调用不通等各类问题。本文完整讲解Ollama的安装部署、存储路径修改、常用命令集合、热门开源模型选型参考,提供curl、Python完整可运行代码示例,同时讲解局域网开放访问、环境变量配置,梳理大量实操踩坑点,帮助不同硬件配置的用户顺利完成本地大模型落地。
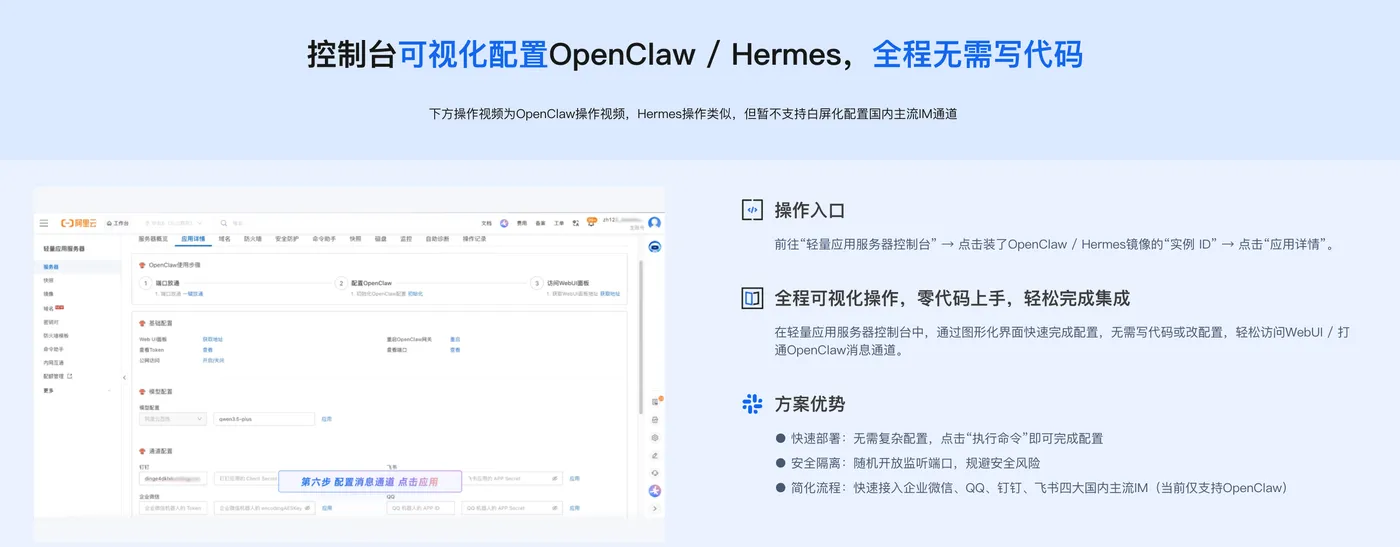
阿里云部署AI Agent:OpenClaw/Hermes Agent全网最简单,只需两步,详情👉访问阿里云OpenClaw/Hermes一键部署专题页面了解。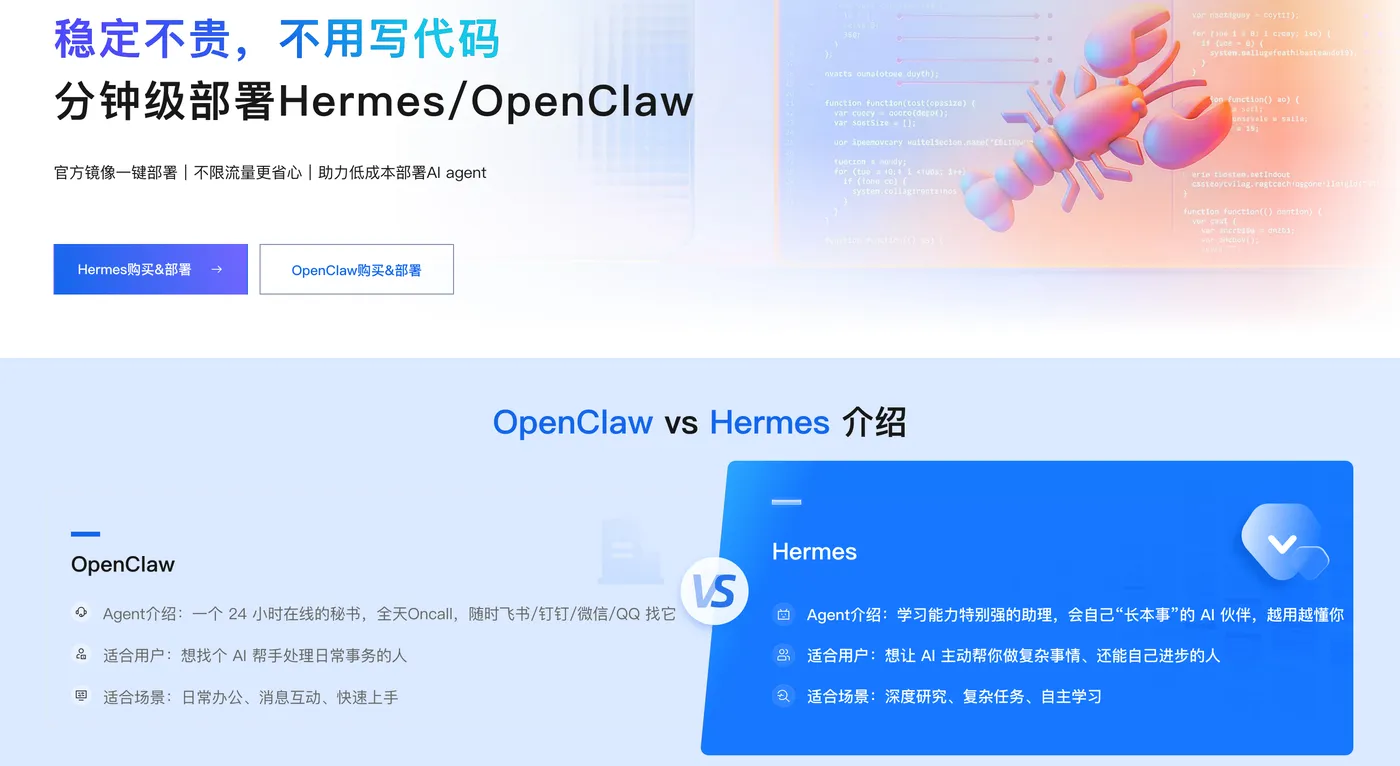
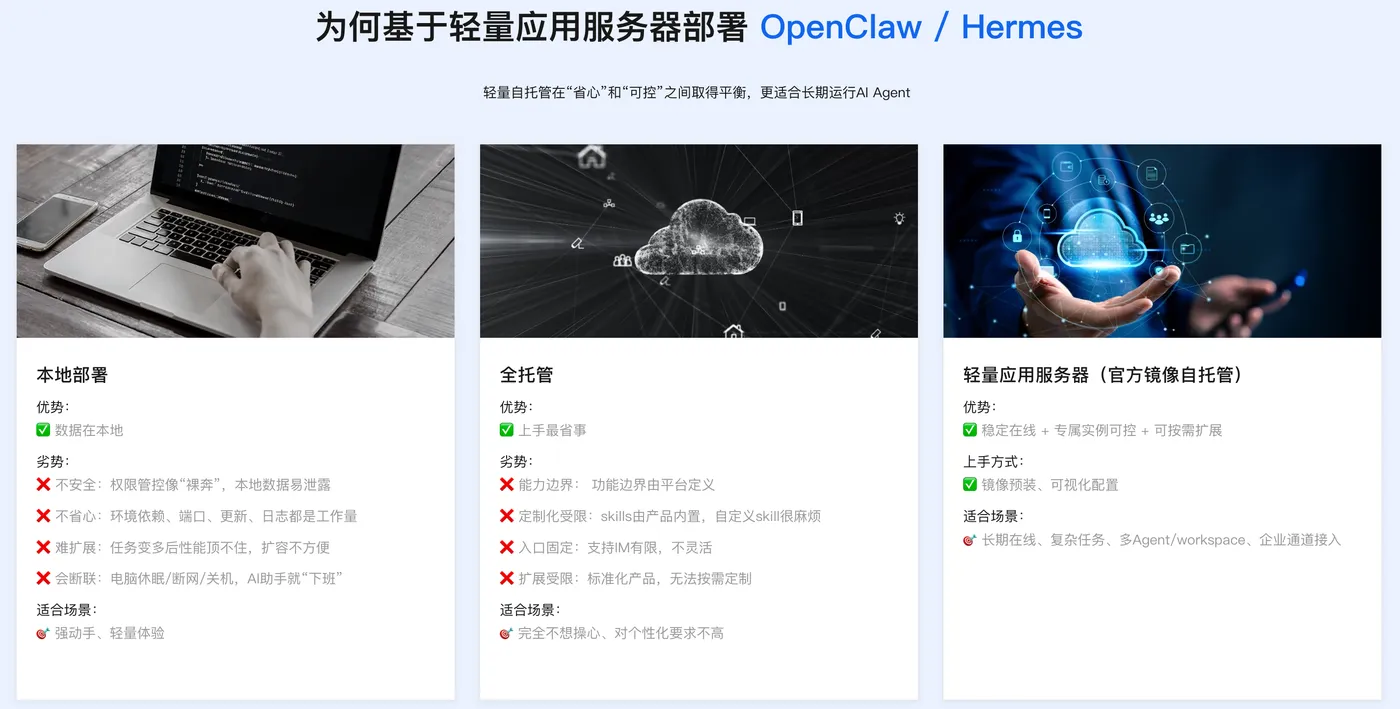
Token Plan Token 最便宜/支持多模型切换:👉访问订阅阿里云百炼Token Plan AI大模型服务 。支持多模型切换,用于多模态模型灵活调用,实现多模型、多工具、多场景下的额度共享与统一管理,兼顾灵活性、稳定性与安全性,大幅降低企业使用大模型的门槛与成本。
服务器环境安装
服务器无桌面环境,直接执行官方一键脚本:
curl -fsSL https://ollama.com/install.sh | sh
服务会自动注册systemd服务,开机自动后台运行。查看服务状态:
systemctl status ollama
三、核心环境变量配置实操
Ollama依靠环境变量实现自定义行为,几个高频使用的环境变量:
OLLAMA_MODELS:模型文件存储目录,解决C盘空间爆满;OLLAMA_HOST:绑定服务监听地址,设置0.0.0.0:11434开启局域网其他设备访问;OLLAMA_ORIGINS:配置跨域访问来源;OLLAMA_KEEP_ALIVE:设置模型在内存中保持驻留的时长。
Linux服务器开启局域网访问,编辑systemd服务单元:
sudo vim /etc/systemd/system/ollama.service
在[Service]段落添加环境变量:
Environment="OLLAMA_HOST=0.0.0.0:11434"
Environment="OLLAMA_ORIGINS=*"
重载配置并且重启服务:
sudo systemctl daemon‑reload
sudo systemctl restart ollama
macOS zsh终端永久配置示例:
echo 'export OLLAMA_MODELS=/Volumes/data/ollama/models' >> ~/.zshrc
echo 'export OLLAMA_HOST=0.0.0.0:11434' >> ~/.zshrc
source ~/.zshrc
Windows系统,打开高级系统设置,新建系统环境变量,填写变量名与目标路径,保存之后完全退出Ollama托盘程序重新启动。
四、常用命令集合与模型拉取运行
Ollama整套工具依靠终端命令完成模型管理,核心常用命令清单:
# 自动拉取并且直接运行模型,模型不存在就自动下载
ollama run qwen3:8b

# 仅仅下载模型,不进入交互对话
ollama pull deepseek‑r1:8b

# 列出本机全部已经下载的模型
ollama list

# 查看当前正在内存运行的模型、资源占用
ollama ps

# 停止正在运行的模型,释放内存资源
ollama stop qwen3:8b

# 删除本地模型文件,释放磁盘
ollama rm qwen3:8b

# 查看模型详细参数、Modelfile信息
ollama show qwen3:8b

# 查看工具版本
ollama --version
热门模型选型参考
| 模型 | 推荐命令 | 最低内存 | 特点说明 |
|---|---|---|---|
| qwen3:8b | ollama run qwen3:8b |
8GB | 中文能力优秀,适合新手日常问答、写代码 |
| qwen3:14b | ollama run qwen3:14b |
16GB | 更强综合推理能力,长文档处理 |
| deepseek‑r1:8b | ollama run deepseek‑r1:8b |
8GB | 数学、逻辑推理、代码能力突出 |
| deepseek‑r1:32b | ollama run deepseek‑r1:32b |
32GB | 高阶复杂推理任务 |
| qwen2.5‑vl:7b | ollama run qwen2.5‑vl:7b |
8GB | 多模态,可以识别图片截图内容 |
| gemma3:4b | ollama run gemma3:4b |
6GB | 轻量模型,低配电脑优先选择 |
选型建议:新手优先从8B档位模型入手,硬件跑起来卡顿、内存溢出,就切换更小参数版本,不要直接上超大模型。执行
ollama run 模型名,首次执行会自动下载模型文件,下载完成进入交互式对话终端,直接输入提问内容即可和本地AI对话,输入/bye退出交互会话。
五、API接口调用实操(curl + Python)
Ollama默认本地服务地址http://localhost:11434,同时提供两套接口:原生api接口,以及OpenAI兼容/v1接口,原有云端业务代码只需要修改base‑url就可以切换本地模型。
curl直接调用OpenAI兼容接口示例:
curl -X POST http://localhost:11434/v1/chat/completions \
‑H "Content‑Type: application/json" \
‑d '{
"model":"qwen3:8b",
"messages":[
{"role":"system","content":"你是专业开发助手,回答简洁清晰。"},
{"role":"user","content":"写一段shell脚本实现日志定期清理"}
],
"max_tokens":1024
}'
Python使用openai库对接本地Ollama服务,不需要真实API‑Key,字段填任意字符串占位:
# pip install openai
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:11434/v1",
    api_key="ollama" # 参数占位,不会做鉴权校验,不能为空字符串
)

def local_chat(prompt:str,model:str="qwen3:8b"):
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {
   "role":"system","content":"你是本地运行的大模型助手。"},
            {
   "role":"user","content":prompt}
        ],
        temperature=0.4,
        max_tokens=2048
    )
    return resp.choices[0].message.content

if __name__ == "__main__":
    output = local_chat("解释Agent智能体的基础概念")
    print(output)
使用原生ollama官方Python库调用:
pip install ollama
import ollama

resp = ollama.chat(
    model="qwen3:8b",
    messages=[{
   "role":"user","content":"给出快速排序Python实现代码"}]
)
print(resp["message"]["content"])
简单shell脚本封装调用,适合自动化脚本场景:
#!/bin/bash
API_URL="http://localhost:11434/api/chat"
prompt="简单介绍Ollama本地大模型框架"

curl -s ${API_URL} \
‑H "Content‑Type:application/json" \
‑d "{
\"model\":\"qwen3:8b\",
\"messages\":[{\"role\":\"user\",\"content\":\"${prompt}\"}],
\"stream\":false
}"
六、典型业务适用场景与能力边界
✅适合的场景:
- 本地隐私处理文档,企业内部资料、涉密文档,数据不上传到外网;
- 开发调试AI应用、Agent框架,不用消耗云端Token额度;
- 离线内网环境,没有互联网的工作站、内网服务器使用AI能力;
- 学习研究开源大模型,自定义模型微调、测试不同量化版本效果;
- 个人日常问答、写脚本、翻译、简单文档总结。
❌不适合的场景:
- 超高并发公网线上生产业务,硬件资源有限,并发能力弱;
- 想要达到顶尖商用闭源模型效果,同等参数开源模型能力存在差距;
- 硬件配置过低,强行运行超大参数模型,会出现卡顿、内存溢出闪退。
客观认知能力边界:7B‑8B本地模型擅长日常任务,超长文档、复杂数学推演、深度工程任务效果有限,需要合理预期输出质量。
七、高频问题排查与避坑总结
模型下载缓慢、中断失败
优先检查网络;可以更换镜像源环境变量;大模型下载中途中断,重新执行ollama pull命令会断点续传,不需要全部重新下载。磁盘剩余空间一定要大于模型文件大小。运行模型电脑卡顿、程序闪退、内存溢出OOM
内存不足以支撑当前模型,降低模型参数档位;关闭电脑后台大量占用内存的软件;NVIDIA显卡确认CUDA驱动正常,开启硬件加速。C盘空间被占满
修改OLLAMA_MODELS环境变量,把模型存储迁移到其他大容量磁盘;已经下载完成的模型,需要手动迁移文件夹文件,再重启Ollama服务。局域网其他设备无法访问本机Ollama服务
确认环境变量OLLAMA_HOST=0.0.0.0:11434;本机防火墙放行11434端口;Linux服务器检查firewalld、iptables防火墙策略。OpenAI兼容接口调用报错
确认ollama后台服务正常运行;base_url地址填写正确;api_key参数不能为空字符串,可以随便填写占位字符。升级版本注意事项
Windows/macOS直接重新安装新版本;Linux执行安装脚本会自动升级;升级完成执行ollama --version确认版本。已经下载的模型文件不会被删除。多模态图片模型使用注意
qwen2.5‑vl等看图模型,对内存显存要求更高,图片尺寸过大会加剧硬件消耗,输入图片建议做适当压缩。
总结
Ollama降低了本地运行开源大模型的门槛,普通个人电脑就可以离线运行Qwen、DeepSeek‑R1、Llama等主流开源模型,数据保存在本地,保障隐私安全。整套工具由图形界面、终端命令、REST API三部分组成,支持Windows、macOS、Linux三大平台。
部署核心流程:安装软件→修改模型存储路径避免系统盘爆满→根据自己电脑内存显存硬件选择合适大小的模型,使用ollama pull/ollama run命令下载运行;开发业务可以直接使用OpenAI兼容接口,少量修改代码就把云端业务迁移到本地离线环境。
本地大模型并不是越大参数就越好,硬件配置决定模型上限,低配设备优先选择7B、8B轻量化版本。同时要客观看待本地模型的能力边界,普通日常任务可以胜任,超复杂推理任务效果对比顶尖闭源云端模型依旧存在差距。开发者在实操的时候,善用环境变量完成存储路径、局域网访问配置,遇到闪退、下载失败优先从硬件资源、磁盘空间、防火墙、网络几个维度排查。不管是个人学习、内网项目开发、隐私文档处理,Ollama都是一套值得掌握的本地大模型部署工具。



