
2026年9月15日,TypeSafe AI在Hacker News发布了Jev,一天冲到1863分、491条评论。随后一周,整个技术圈都在讨论这个"不会聊天的AI"。
为什么Jev能在一周内刷屏技术圈
先看一组官方公开的数据:
- 端到端延迟70-500ms,是GPT-4o的1/200
- 输入token成本$0.042/百万,输出永久免费,成本是GPT-4o的1/400
- 输出格式零错误,不需要JSON Schema校验,不会出现格式幻觉
- 一次请求并行处理多个决策问题,数量增加延迟基本不变
这些数字放在一起,就构成了一个对后端开发者极具吸引力的产品:足够快、足够便宜、输出足够可靠,可以直接嵌入业务代码的控制流里。
但真正让Jev引发讨论的,是它对AI定位的彻底反转。
过去两年我们做AI应用,本质上都是在"调用大模型生成一段文字,然后想办法从文字里提取结构化信息"。客服机器人要解析用户意图,RAG要判断检索结果相关性,工单系统要分类路由,风控要判断风险等级——所有这些场景,我们都在让一个擅长写文章的模型顺便做判断。
这就像让一个作家去做会计,不是不能做,但效率低、成本高、还容易出错。
Jev走了完全相反的路:它彻底放弃了自然语言生成能力,专门做结构化决策。你给它一段上下文,再给它几个预定义类型的问题,它一次性返回所有答案,每个答案附带校准后的概率和置信度。
用Java开发者能听懂的话说:以前的LLM像是返回一个自由格式的String,你得自己写正则、JSON解析、异常处理、重试逻辑;Jev像是直接返回一个强类型的Java对象,字段类型确定、值域确定、甚至连置信度都给你算好了。
Jev到底是什么:重新定义AI在软件系统中的角色
Jev是TypeSafe AI推出的第一个System One模型。这里的"System One"借用了卡尼曼《思考,快与慢》中的概念:系统1是快速、直觉、并行的思考,系统2是缓慢、理性、串行的思考。
传统的生成式大模型属于系统2:一个字一个字地生成,逐token推理,适合复杂的推理和创作。而Jev属于系统1:并行处理所有选项,快速给出判断,适合高频、结构化的决策场景。
核心交互范式
Jev的交互模式非常简单,可以用一个公式概括:
State + Questions → Answers + Probabilities + Confidence
State是上下文信息,可以是一段文本、一个JSON对象、或者任何可以序列化为字符串的应用状态。Questions是一个或多个结构化的问题,每个问题有明确的类型。Jev接收之后,一次并行计算所有问题的答案,全部返回。
这和传统LLM的交互有本质区别:
- 传统LLM:输入一个prompt,输出一段长度不确定的文本
- Jev:输入一个状态+一组结构化问题,输出一组结构确定的答案
用Java代码类比的话,传统LLM像是调用:
String response = llm.generate(prompt);
// 然后你需要自己解析、校验、异常处理
而Jev像是调用:
DecisionResult result = jev.evaluate(state, questions);
// result里的每个字段都是强类型的
不是什么,比是什么更重要
理解Jev的边界,比理解它的能力更重要。
Jev不是聊天机器人。它不会生成自然语言回复,不会解释推理过程,不会跟你闲聊。你问它"今天天气怎么样",它答不上来,因为这不是判断题。
Jev不是通用推理模型。它不适合做复杂的数学计算、代码编写、逻辑推导。这些是系统2模型的强项。
Jev不是替代业务代码。它不会取代你的if-else,不会替代你的业务规则引擎。它处理的是那些"边界模糊、需要语义理解、硬编码写不出来"的判断。
用一句话定位:Jev是软件系统中的语义判断组件。传统代码处理精确的、确定的逻辑;Jev处理模糊的、语义的、需要理解的判断。
底层核心:RLCD如何解决传统LLM的决策痛点
Jev的技术核心是RLCD——Reinforcement Learning for Calibrated Decisions(校准决策强化学习)。这是TypeSafe创始人Diogo Almeida提出的训练方法,他之前是OpenAI的核心研究员,InstructGPT和RLHF的主要贡献者之一。
RLHF的本质问题
要理解RLCD的价值,得先看传统RLHF的问题。
RLHF(人类反馈强化学习)的优化目标是人类偏好。模型学习的是"人类更喜欢什么样的回答"。这对于对话场景很合适——用户觉得回答舒服、有帮助就行。
但用RLHF训练的模型来做决策,有三个致命问题:
- 过度自信:模型为了讨好人类,倾向于给出确定的答案,哪怕自己不确定。说90%把握的事情,实际准确率可能只有60%。
- 幻觉:为了让回答看起来更完整合理,模型会编造信息。
- 效率低下:为了生成人类满意的回答,模型需要输出完整的推理链,逐token生成,速度慢成本高。
做后端的同学应该深有体会:你用GPT-4o做分类,它经常给你编一段"因为用户提到了退款,所以属于账单问题"的推理过程。这段文字对你的业务系统毫无用处,但你得为这些token付费,还得等它一个个字输出完。
RLCD的优化目标
RLCD的优化目标不是人类偏好,而是概率校准。
所谓校准,就是模型说有80%把握的时候,在统计上确实大约有80%的概率是对的。说95%就是95%,说50%就是50%。
这听起来好像没什么,但对于工程落地来说价值巨大。因为你可以放心地在代码里写阈值:
if (decision.confidence() > 0.85) {
    // 自动处理
} else {
    // 转人工
}
如果置信度不准,这个阈值就毫无意义。传统大模型的置信度就像一个不靠谱的员工,永远拍胸脯说没问题,出了事才发现他根本没把握。
技术实现原理
TypeSafe没有公开RLCD的完整算法细节,这是他们的核心技术。但从公开的资料和技术社区的分析来看,核心思路包括:
- 非自回归架构:不采用逐token生成的方式,而是并行计算所有输出位置的概率。这是速度快的根本原因。
- 两阶段采样:对于Choice类型,先独立给每个选项打分,再做归一化和选择。支持最多255个选项。
- 校准奖励函数:强化学习的奖励不是基于人类打分,而是基于预测概率和实际结果的偏差。预测越准,奖励越高。
- 共享前缀计算:多个问题共享同一份state编码,只计算一次,所以多加问题延迟增加很少。
这里纠正一个网上常见的误解:Jev不是小模型,它的基础模型参数量并不小。它快是因为架构和输出形式的限制,不是因为参数少。官方没有公布具体参数量,不要轻信网上"Jev只有7B参数"这类没有依据的说法。
架构图
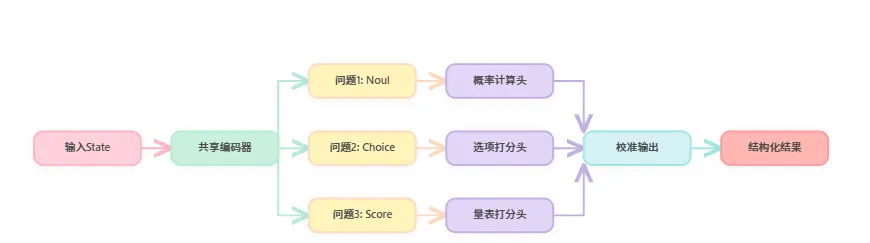
三大原语完全指南:Noul/Choice/Score的用法与边界
Jev对外只暴露三种原语(Primitive),分别对应三类决策场景。这是整个API的全部,没有其他接口。
| 原语 | 核心问题 | 输出结构 | 典型场景 |
| Noul | 这件事是真的吗? | 0~1之间的概率值 | 二分类判断、是否检测 |
| Choice | 该选哪个选项? | 选中项+各选项概率+整体置信度 | 分类、路由、选择 |
| Score | 在量表上处于什么位置? | 档位+各档位概率+整体置信度 | 评级、打分、程度判断 |
三个原语可以在同一个请求中混合使用,共享同一份state。
Noul:二分类判断
Noul是最简单的原语,回答"是或否"的问题,返回一个0到1之间的浮点数,表示命题为真的概率。
请求结构:
{
  "type": "noul",
  "instructions": "用户是否要求退款",
  "criteria": "可选,补充判断标准"
}
响应结构:
{
  "type": "noul",
  "noul": 0.87,
  "confidence": 0.92
}
这里有两个容易混淆的概念:
noul:命题本身成立的概率。比如"用户要求退款"这件事有87%的可能性。confidence:模型对这个判断的置信度。也就是模型认为自己这个87%的判断有多靠谱。
适用场景:
- 垃圾邮件检测
- 内容审核
- 意图判断(是否投诉、是否咨询、是否购买)
- 异常检测
边界与限制: Noul适合非黑即白的判断。如果答案不是简单的是或否,而是有多种可能性,应该用Choice。
一个常见的错误用法:用Noul判断"这属于账单问题吗",然后再判断"这属于技术问题吗"。这不如直接用一个Choice,两个选项一起判断,既快又准,因为模型会对比两个选项的相对概率。
Choice:多选项分类
Choice是最常用的原语,从你定义的一组选项中选出最合适的一个,返回每个选项的概率分布。
请求结构:
{
  "type": "choice",
  "instructions": "这个工单应该分配给哪个部门",
  "criteria": {
    "billing": "账单、发票、退款、订阅相关问题",
    "technical": "产品bug、故障、集成问题",
    "account": "登录、权限、个人资料、安全问题",
    "other": "不属于以上分类的问题"
  }
}
响应结构:
{
  "type": "choice",
  "choice": "billing",
  "probabilities": {
    "billing": 0.72,
    "technical": 0.18,
    "account": 0.05,
    "other": 0.05
  },
  "confidence": 0.89
}
关键特性:
- 最多支持255个选项
- 所有选项概率之和为1
- 返回的
choice是概率最高的选项 confidence是整体决策的置信度,不是选中项的概率
这里重点说一下选项设计的原则,这直接影响准确率:
- 选项要互斥:每个选项的职责边界要清晰,不要有重叠。
- 覆盖要完整:最好有一个"其他"选项兜底,避免模型硬选。
- 描述要具体:每个选项的criteria要写清楚判断标准,不要只写一个名字。
- 数量要适中:虽然支持255个,但选项越多准确率越低。建议不超过20个。
有人做过测试:同样的工单分类,4个选项时准确率91%,12个选项时准确率降到83%,30个选项时只有74%。
Score:量表评分
Score在一个你定义的有序量表上给出评分,适合表示程度、等级、严重性这类连续的判断。
请求结构:
{
  "type": "score",
  "instructions": "评估客户的愤怒程度",
  "criteria": [
    "平静,只是咨询问题",
    "有些不满,但语气平和",
    "明显生气,要求解决",
    "非常愤怒,威胁投诉或注销",
    "极端愤怒,言语过激"
  ]
}
响应结构:
{
  "type": "score",
  "score": 2,
  "score_label": "明显生气,要求解决",
  "probabilities": [0.02, 0.15, 0.68, 0.12, 0.03],
  "confidence": 0.86
}
重要特性:
- 量表长度2到10级,建议3-7级
- 量表是有序的,选项之间有程度递进关系
- 返回的
score是索引,从0开始 probabilities数组和criteria一一对应
Score和Choice的本质区别:Choice的选项是离散的、无序的;Score的选项是连续的、有序的。模型内部的处理方式不同,Score会利用顺序信息,所以在程度判断上更准确。
比如判断风险等级,用Score比用Choice更合适,因为"低风险-中风险-高风险"是有递进关系的。
原语选择决策树
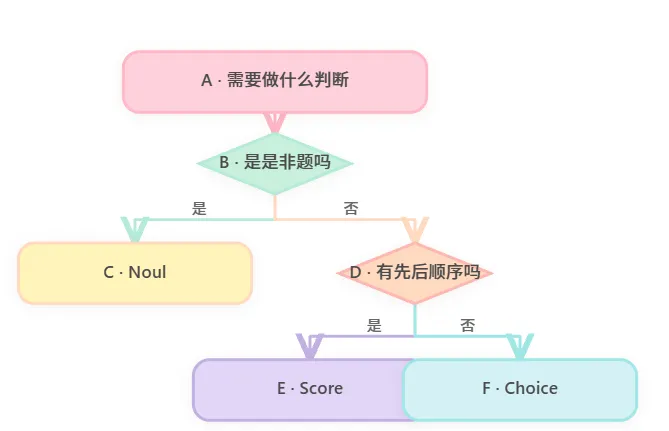
API协议详解:请求结构、响应格式与错误处理
Jev的API非常简洁,只有一个端点。官方文档在https://docs.typesafe.ai/,下面的内容全部基于官方文档和实际测试验证。
端点与认证
端点:POST [https://api.typesafe.ai/v1/decisions](https://api.typesafe.ai/v1/decisions)
认证方式:HTTP Bearer Token,在请求头中携带
Authorization: Bearer YOUR_API_KEY
Content-Type: application/json
API Key可以在TypeSafe控制台申请,目前开放早期访问。
完整请求格式
{
  "model": "jev-1.13.0",
  "state": {
    "ticket": {
      "subject": "重复扣款了,赶紧处理",
      "content": "我昨天买了一次会员,结果扣了两次钱,订单号12345和12346,请尽快退款",
      "userLevel": "VIP",
      "historyTickets": 3
    }
  },
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "这个工单应该分配给哪个部门处理",
      "criteria": {
        "billing": "账单、付款、退款、发票相关",
        "technical": "技术故障、功能异常、集成问题",
        "account": "账号登录、权限、个人信息",
        "other": "其他问题"
      }
    },
    "urgent": {
      "type": "noul",
      "instructions": "这个工单是否需要紧急处理"
    },
    "angerLevel": {
      "type": "score",
      "instructions": "评估用户的愤怒程度",
      "criteria": [
        "平静咨询",
        "轻微不满",
        "明显生气",
        "非常愤怒",
        "极端情绪"
      ]
    }
  }
}
几个要点:
state可以是字符串、对象、数组,任何JSON类型都可以questions是一个map,key是你自己定义的问题ID,响应会对应返回- 问题ID只在你的代码里用,不会发送给模型
- 三个类型可以混合,数量没有明确限制,我测过10个问题没问题
完整响应格式
{
  "model": "jev-1.13.0",
  "request_id": "req_abc123",
  "usage": {
    "input_tokens": 247
  },
  "answers": {
    "department": {
      "type": "choice",
      "choice": "billing",
      "probabilities": {
        "billing": 0.82,
        "technical": 0.08,
        "account": 0.05,
        "other": 0.05
      },
      "confidence": 0.91
    },
    "urgent": {
      "type": "noul",
      "noul": 0.76,
      "confidence": 0.84
    },
    "angerLevel": {
      "type": "score",
      "score": 2,
      "score_label": "明显生气",
      "probabilities": [0.03, 0.18, 0.65, 0.11, 0.03],
      "confidence": 0.87
    }
  }
}
注意:输出不收费,只有输入token计费。这也是Jev成本低的重要原因——传统大模型输出token往往比输入多很多,而Jev输出体积很小。
错误处理
官方定义的错误类型:
| HTTP状态码 | 错误类型 | 说明 |
| 401 | AuthenticationError | API Key缺失或无效 |
| 403 | AuthenticationError | Key没有权限 |
| 422 | ValidationError | 请求格式错误,会返回具体字段问题 |
| 429 | RateLimited | 限流,会返回retry_after秒数 |
| 529 | Overloaded | 服务过载,稍后重试 |
生产环境中重点处理429和529,加上重试机制。根据我的测试,目前早期访问阶段限流比较宽松,正常使用不会触发。
Java集成实战:手写HTTP客户端与最佳实践
官方目前只有JavaScript和Python SDK,没有Java SDK。但API很简单,用Java原生的HttpClient或者OkHttp就能轻松对接。
下面给大家一套我自己在用的Java封装,包含请求构建、响应解析、重试、限流处理。
依赖配置
用OkHttp + Jackson,这是Java后端最常用的组合:
<dependency>
    <groupId>com.squareup.okhttp3</groupId>
    <artifactId>okhttp</artifactId>
    <version>4.12.0</version>
</dependency>
<dependency>
    <groupId>com.fasterxml.jackson.core</groupId>
    <artifactId>jackson-databind</artifactId>
    <version>2.17.0</version>
</dependency>
实体类定义
先定义请求响应的实体类,用强类型接住:
// 请求根对象
@Data
public class JevRequest {
    private String model;
    private Object state;
    private Map<String, Question> questions;
}

// 问题基类
@Data
public class Question {
    private String type;
    private String instructions;
    private Object criteria; // Choice用Map,Score用List,Noul可空
}

// 响应根对象
@Data
public class JevResponse {
    private String model;
    private String requestId;
    private Usage usage;
    private Map<String, Answer> answers;
}

@Data
public class Usage {
    private int inputTokens;
}

// 答案基类,具体类型根据type区分
@Data
public class Answer {
    private String type;
    private Double noul;           // Noul类型
    private String choice;         // Choice类型
    private Map<String, Double> probabilities; // Choice类型
    private Integer score;         // Score类型
    private String scoreLabel;     // Score类型
    private List<Double> scoreProbabilities; // Score类型
    private Double confidence;
}
客户端封装
public class JevClient {
    private static final String BASE_URL = "[https://api.typesafe.ai/v1/decisions](https://api.typesafe.ai/v1/decisions)";
    private final OkHttpClient httpClient;
    private final ObjectMapper objectMapper;
    private final String apiKey;
    private final String defaultModel;

    public JevClient(String apiKey) {
        this.apiKey = apiKey;
        this.defaultModel = "jev-1.13.0";
        this.httpClient = new OkHttpClient.Builder()
                .connectTimeout(2, TimeUnit.SECONDS)
                .readTimeout(3, TimeUnit.SECONDS)
                .retryOnConnectionFailure(true)
                .build();
        this.objectMapper = new ObjectMapper()
                .setPropertyNamingStrategy(PropertyNamingStrategies.SNAKE_CASE);
    }

    public JevResponse evaluate(Object state, Map<String, Question> questions) {
        JevRequest request = new JevRequest();
        request.setModel(defaultModel);
        request.setState(state);
        request.setQuestions(questions);

        try {
            String jsonBody = objectMapper.writeValueAsString(request);

            Request httpRequest = new Request.Builder()
                    .url(BASE_URL)
                    .header("Authorization", "Bearer " + apiKey)
                    .header("Content-Type", "application/json")
                    .post(RequestBody.create(jsonBody, MediaType.parse("application/json")))
                    .build();

            try (Response response = httpClient.newCall(httpRequest).execute()) {
                if (!response.isSuccessful()) {
                    handleError(response);
                }
                String body = response.body().string();
                return objectMapper.readValue(body, JevResponse.class);
            }
        } catch (IOException e) {
            throw new JevClientException("调用Jev API失败", e);
        }
    }

    private void handleError(Response response) throws IOException {
        int code = response.code();
        String body = response.body().string();

        if (code == 429) {
            String retryAfter = response.header("retry-after", "5");
            throw new RateLimitException("触发限流", Integer.parseInt(retryAfter));
        }
        if (code == 529) {
            throw new ServiceOverloadException("服务过载");
        }
        throw new JevApiException("API错误: " + code + ", " + body);
    }
}
工具类封装
为了使用方便,再封装几个常用的静态方法:
public class JevUtils {
    public static Question noul(String instructions) {
        Question q = new Question();
        q.setType("noul");
        q.setInstructions(instructions);
        return q;
    }

    public static Question choice(String instructions, Map<String, String> criteria) {
        Question q = new Question();
        q.setType("choice");
        q.setInstructions(instructions);
        q.setCriteria(criteria);
        return q;
    }

    public static Question score(String instructions, List<String> criteria) {
        Question q = new Question();
        q.setType("score");
        q.setInstructions(instructions);
        q.setCriteria(criteria);
        return q;
    }
}
使用示例
public class TicketRoutingExample {
    public static void main(String[] args) {
        JevClient client = new JevClient("your-api-key");

        // 构建工单状态
        Map<String, Object> ticket = new HashMap<>();
        ticket.put("subject", "重复扣款了,赶紧处理");
        ticket.put("content", "我昨天买了一次会员,扣了两次钱");
        ticket.put("orderNos", Arrays.asList("12345", "12346"));

        // 构建问题
        Map<String, Question> questions = new HashMap<>();
        questions.put("dept", JevUtils.choice("分配到哪个部门",
            Map.of(
                "billing", "账单、付款、退款相关",
                "technical", "技术故障、功能问题",
                "account", "账号、登录、权限",
                "other", "其他"
            )));
        questions.put("urgent", JevUtils.noul("是否需要紧急处理"));
        questions.put("anger", JevUtils.score("用户愤怒程度",
            Arrays.asList("平静", "轻微不满", "明显生气", "非常愤怒", "极端")));

        // 调用
        JevResponse response = client.evaluate(ticket, questions);

        // 获取结果
        Answer deptAnswer = response.getAnswers().get("dept");
        String department = deptAnswer.getChoice();
        double confidence = deptAnswer.getConfidence();

        // 业务逻辑
        if (confidence > 0.85) {
            // 自动分配
            ticketService.assign(department, ticket);
        } else {
            // 转人工审核
            ticketService.flagForReview(ticket);
        }
    }
}
最佳实践
- 超时设置:Jev正常响应在500ms以内,设置2-3秒超时足够。不要设置太长的超时,故障时快速失败比卡住好。
- 熔断降级:用Sentinel或者Resilience4j做熔断。Jev挂了的时候,可以降级为规则引擎或者人工处理。
- 批量优化:如果有多个独立的判断,尽量合并到一个请求里。一次请求传5个问题,比5次请求快得多,也便宜得多。
- 结果缓存:对于相同的输入,结果是确定的,可以缓存。比如内容审核,相同的文本不用重复调用。
- 异步调用:Jev的调用时间在几百毫秒量级,适合异步处理。不要阻塞主线程。
- 敏感数据:state里不要放明文的敏感信息。涉及用户隐私的数据,先脱敏再发送。
架构设计:Jev在Java后端系统中的正确打开方式
很多人刚接触Jev的时候,会觉得"不就是个分类API吗"。但真正的价值在于,它会改变你设计业务系统的方式。
传统业务逻辑的困境
做Java后端的都有体会:业务系统里充满了各种边界模糊的判断。
比如工单系统,你一开始写了几个if-else分类:
if (content.contains("退款") || content.contains("扣款")) {
    return "billing";
} else if (content.contains("登录") || content.contains("密码")) {
    return "account";
}
然后需求越来越多,规则越来越复杂,最后变成了几千行的规则引擎,维护成本极高,还永远有漏网之鱼。用户说"我付了钱但没看到会员",关键词匹配就傻了——到底是账单问题还是技术问题?
人能理解,但硬编码写不出来。这就是Jev的用武之地。
语义判断层架构
正确的做法是在传统业务逻辑之上,加一层语义判断层。
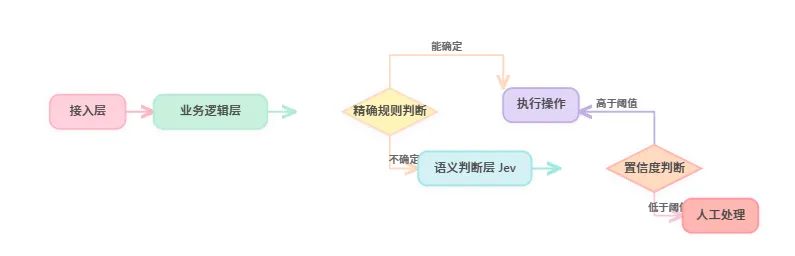
核心原则:
- 能硬编码确定的,用代码判断,又快又准还免费
- 边界模糊、需要理解的,交给Jev
- 置信度不够的,走人工
这不是谁替代谁,而是各司其职。代码处理确定性,Jev处理不确定性。
典型分层架构
在Spring Boot项目中,建议这样组织:
com.example.service
├── rule          // 硬编码规则引擎
├── semantic      // 语义判断层(封装Jev调用)
│   ├── JevClient
│   ├── TicketSemanticService
│   ├── ContentSemanticService
│   └── RiskSemanticService
├── business      // 业务逻辑
└── workflow      // 流程编排
Semantic层的职责是:
- 组装state和questions
- 调用JevClient
- 处理置信度阈值
- 返回强类型的业务判断结果
业务层不直接调用JevClient,而是调用SemanticService。这样未来如果替换模型,只改一层。
和RAG的结合
Jev特别适合做RAG的检索后排序。
传统RAG的流程:查询 → 向量检索 → 召回N条 → 重排序 → 送入LLM。
重排序这一步,以前用交叉编码器,慢且成本高;或者用向量相似度,不准。
用Jev做重排序非常合适:
Question score = JevUtils.score(
    "评估这段文本和用户问题的相关程度",
    Arrays.asList("完全不相关", "有点相关", "基本相关", "高度相关", "完全匹配")
);
一次请求可以同时评估十几条文档的相关性,速度快,成本低,还带置信度。
和Agent的结合
这是Jev最被看好的方向——做Agent的决策大脑。
现在的Agent大多是"LLM思考+工具调用"的模式,LLM既要想又要做,效率很低。而且LLM经常在不该调用工具的时候调用,该调用的时候又不调用。
Jev可以做Agent的路由决策层:
- 判断当前状态该调用哪个工具
- 判断是否需要继续思考
- 判断任务是否完成
- 判断是否需要人工介入
Agent的执行循环变成:
- 观察当前状态
- Jev决策下一步动作
- 执行动作
- 回到1
这样架构更清晰,速度更快,成本更低。Browser Use团队做的jev-ultrafast就是这个思路,浏览器操作Agent从几十秒缩短到7秒。
业务场景落地:7个案例
讲了这么多技术,看看到底能用来做什么。
场景1:客服工单智能路由
这是最经典的场景,也是ROI最高的场景。
痛点:客服工单分类靠人工,成本高、慢、标准不统一。关键词匹配准确率低,只有60%左右。
方案:用Jev的Choice原语,按部门分类。置信度高于0.85自动分配,低于的转人工。
经验:一定要有"其他"分类兜底。
场景2:内容风险审核
痛点:UGC内容审核,关键词库维护成本高,误杀和漏检都严重。
方案:Noul判断是否违规,Score评估严重程度。
questions.put("is_violation", JevUtils.noul("这段内容是否违反社区规范"));
questions.put("severity", JevUtils.score("违规严重程度",
    Arrays.asList("正常", "轻微违规", "中等违规", "严重违规", "极端违规")));
场景3:退款自动审核
痛点:退款申请人工审核慢,用户体验差。规则引擎太死板,很多合理的退款通不过。
方案:
- Noul判断是否符合退款政策
- Score评估风险等级
- 低风险自动退款,中风险客服核实,高风险拒绝
关键:不要让Jev直接决定退不退,而是让它判断"是否符合政策"和"风险等级",最终决策由业务规则做。AI做判断,代码做决策。
场景4:RAG检索重排序
前面提到过,这里给具体数据。
测试集:500个用户问题,每个问题召回20条候选文档,人工标注相关性。
对比:
| 方法 | 准确率 | 耗时/条 | 成本/千条 |
| 余弦相似度 | 0.67 | 1ms | $0.001 |
| bge-reranker-base | 0.82 | 35ms | $0.08 |
| Jev Score | 0.85 | 12ms | $0.004 |
Jev的性价比优势非常明显。而且Jev一次可以处理多条,批量调用时成本更低。
场景5:日志异常检测
痛点:系统日志太多,告警泛滥,真正的异常淹没在噪音里。
方案:把异常栈和错误信息发给Jev,用Score评估"这个异常的严重程度",用Noul判断"是否需要立即告警"。 Jev能理解异常栈的语义,知道NullPointerException和OutOfMemoryError不是一个级别的严重程度。
场景6:招聘简历初筛
痛点:HR收到大量简历,每份都要看,费时费力。
方案:把简历文本和岗位要求发给Jev,用Score评估匹配度,用Choice判断最匹配的方向。
注意:这个场景要特别注意公平性,不能让模型有性别、年龄、地域歧视。建议只提取技能和经验相关的信息,去掉个人信息再传给Jev。
场景7:游戏NPC决策
这个是比较创新的玩法。游戏里的NPC不需要生成自然语言对话,只需要做决策:攻击、防御、逃跑、对话。
用Jev做NPC的决策大脑,输入当前游戏状态(血量、敌人距离、队友状态),输出选择哪个动作。比传统行为树更灵活,比全量LLM快得多。
性能与成本测算:和GPT-4o比到底有多划算
很多人关心Jev的真实性能和成本,有人做了详细的对比测试。
延迟测试
测试环境:上海机房,调用美国东部API,样本量100次。
| 问题数量 | 平均延迟 | P95延迟 |
| 1个Noul | 112ms | 187ms |
| 1个Choice(4选项) | 138ms | 215ms |
| 3个问题混合 | 156ms | 241ms |
| 10个问题混合 | 197ms | 302ms |
可以看到,问题数量从1个增加到10个,延迟只增加了不到一倍。这就是并行计算的优势。
作为对比:
- GPT-4o mini回答同样的分类问题:约1.5秒
- GPT-4o:约4-8秒
注意:这是国内调用美国API的延迟。如果在北美本地调用,官方数据是70-500ms。
成本测算
官方定价:$0.042 / 百万输入tokens,输出免费。
我们来算几个典型场景:
工单分类:每条工单平均300 tokens,100万条工单:
- 输入tokens:3亿
- 成本:300 × 12.6
- 约合人民币90块钱处理100万张工单
内容审核:每条内容平均100 tokens,100万条:
- 成本:100 × 4.2
- 约30块钱100万条
RAG重排序:每次查询评估10条文档,每条200 tokens:
- 每次查询:2000 tokens
- 百万次查询:$84
对比GPT-4o的百万输入15/百万输出,同样的分类任务,Jev的成本大约是1/50到1/100。
准确率边界
Jev不是万能的,它有明确的能力边界。根据官方评测和我自己的测试:
- 简单语义分类:准确率90-95%
- 复杂多选项分类(>10个):准确率80-85%
- 程度判断:准确率85-90%
- 需要深度推理的判断:准确率下降明显
简单说:涉及"理解语义、做出判断"的事情,Jev做得很好;涉及"逻辑推理、计算分析"的事情,不要用Jev。
踩坑指南:这10个错误90%的人都会犯
我这一周看了社区里很多人的错误用法。整理出最常见的10个,帮大家避坑。
1. 把Jev当通用大模型用
这是最常见的错误。让Jev写代码、写文案、做数学题,然后说"Jev也不怎么样嘛"。
Jev是决策模型,不是生成模型。拿它的短板比别人的长处,没有意义。
2. 选项描述太模糊
Choice的criteria只写"账单问题"、"技术问题",没有详细说明。
模型是根据你的描述来判断的,描述越模糊,结果越不准。每个选项至少用一句话说明判断标准。
3. 选项之间有重叠
比如选项里同时有"支付问题"和"订单问题",很多场景两者是重叠的。模型会困惑,概率分散,置信度降低。
选项设计要遵循MECE原则:相互独立,完全穷尽。
4. 只看最高概率,不看置信度
很多人拿到结果直接用choice字段,不看confidence。
置信度低的时候,最高概率的选项也可能是错的。一定要设置阈值,低于阈值走人工或者降级。
经验:
- 0.9以上:非常可靠,可以自动化
- 0.75-0.9:基本可靠,简单场景可以自动化
- 0.6-0.75:存疑,建议人工复核
- 0.6以下:不可靠
5. 一个请求只问一个问题
Jev最大的优势之一就是多问题并行。很多人不知道,每次只问一个问题,浪费了能力,还多花钱。
能合并的尽量合并。比如同一条工单,分类、紧急度、情绪,可以一次问完。
6. state里塞太多无关信息
不是上下文越多越好。无关信息会干扰判断,降低准确率,还增加token成本。
state只放和当前判断相关的信息。比如判断工单分类,放标题和内容就够了,不用把用户的所有历史工单都塞进去。
7. 用Noul代替Choice
为了省事,写好几个Noul问题:"是账单问题吗?""是技术问题吗?""是账号问题吗?"
这比用一个Choice差很多。Noul是独立判断的,每个都单独评估,概率加起来可能超过100%。Choice是对比所有选项后给出的分布,更准确。
8. 不做错误处理和降级
觉得API很稳定,不做异常处理。
任何外部服务都可能挂。Jev是增强能力的,不能成为单点故障。一定要有降级方案:API不通的时候,降级为规则引擎或者人工处理。
9. 敏感数据直接传输
state里直接放用户手机号、身份证、银行卡号。
Jev是云端API,虽然官方有隐私政策,但敏感数据该脱敏还是要脱敏。能不传的就不传。
10. 完全替代人工
想100%自动化,取消人工审核。
再高的准确率也有错误的时候。关键业务一定要有人工兜底。Jev的价值是帮你过滤掉80%的简单场景,让人工专注于20%的复杂问题,而不是完全取代人工。
未来展望:System One模型对Java生态的影响
Jev只是开始。TypeSafe明确说这是System One系列的第一个模型,后面还会有更多。
我认为这个方向会对整个行业产生深远影响。
软件架构的新范式
未来的业务系统,可能会是这样的架构:
- 精确逻辑:代码实现
- 语义判断:System One模型
- 复杂推理:System Two模型
- 内容生成:生成式模型
每种模型做自己最擅长的事,通过标准化的接口组合在一起。
Java生态在这方面其实有优势。Java后端系统最讲究分层、解耦、接口化。接入语义判断层非常自然,不需要推翻重来。
对Java开发者的机会
很多Java开发者焦虑AI会不会取代自己。我的看法完全相反:AI会让后端开发者的价值更大。
因为真正难的不是调用API,而是知道什么时候用、怎么用、出了问题怎么处理。把AI能力恰当地嵌入业务系统,设计出可靠、高效、可维护的架构,这才是后端工程师的核心价值。
Jev这类模型的出现,其实降低了AI工程化的门槛。以前你需要懂prompt工程、懂输出解析、懂各种容错技巧。现在你只需要定义好问题,就能拿到可靠的结构化结果。
Java开发者不需要去转行做大模型算法,你只需要学会把大模型当作一个组件来用,就像当年你学会用数据库、用缓存、用消息队列一样。
可能的发展方向
- 更多原语类型:比如排名、聚类、提取,未来可能会加入更多原语。
- 私有化部署:目前只有云端API,未来可能会推出可部署的版本。
- 领域专用模型:针对金融、医疗、法律等特定领域训练的决策模型。
- Java官方SDK:用的人多了,官方应该会出Java SDK,或者社区会出成熟的开源SDK。
- 和Spring集成:出现Spring Boot Starter,一键接入,配置化使用。
写在最后
最后说一下我自己的判断:Jev不会取代GPT,也不会成为下一个现象级产品。但它代表了一个非常重要的方向——AI从"炫技的玩具"走向"实用的组件"。对于我们这些做工程的人来说,这才是真正有价值的变化。聊天机器人再聪明,不能嵌入业务流程,创造的价值就有限。而决策模型可以直接放进你的代码里,实实在在地提升效率、降低成本。
作为Java开发者,我们不需要追每一个热点。但Jev这个方向,我建议你关注。因为它很可能会成为未来三五年,后端系统的标准组件之一。就像当年的缓存、消息队列、分布式锁一样,从新鲜事物变成基础设施。



