
深夜十一点,你审核完一份 PR:三百行 AI 生成代码,测试与 CI 均通过,你点了批准,关闭电脑。 三天后线上告警爆发。根源是 AI 自行补写的一行边界条件,语法、自测都没问题,但违背真实业务规则。回看记录:代码由 AI 产出,审核只是粗略扫过 diff。
这类场景在团队里越来越常见:AI 大幅提速,PR 数量成倍增长,但隐藏着三大隐患:
- AI 不理解业务历史约束,不知道代码背后沉淀的事故经验;
- 测试通过不等于安全,AI 甚至可以写出能过用例、却存在注入风险的代码;
- 事故复盘审计时,“AI 生成、没有细看” 无法作为责任依据。
代码可以交给 AI 编写,但交付责任无法外包。AI 压低了代码生成成本,验证与追溯成本却没有降低。PR 数量暴涨,审核人力不变,每行代码的审查质量被稀释。 AI 带来的真正挑战,不在于写代码有多快,而在于我们能否守住审核的深度。
一、瓶颈已经从“写”转移到了“验”
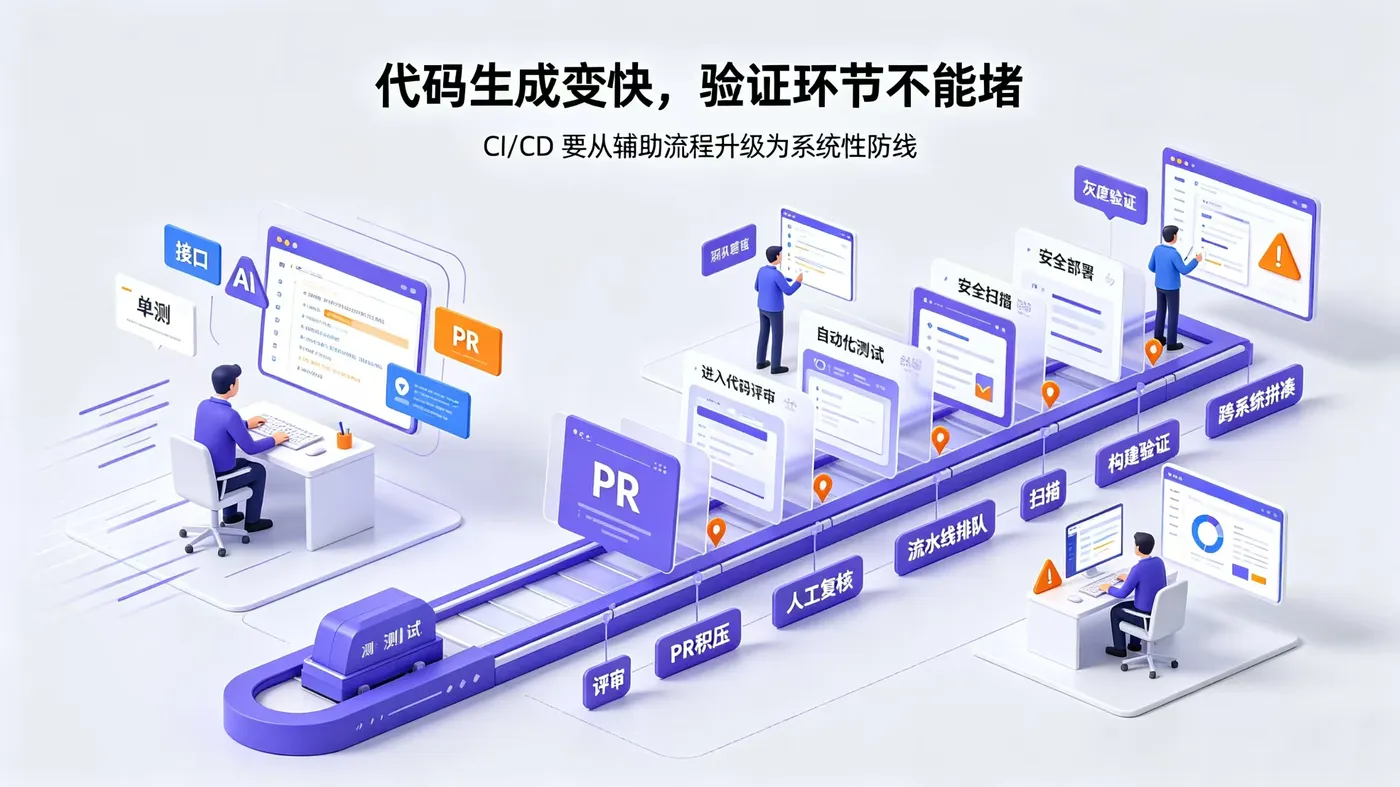 AI Coding 工具解决的是“写”的问题,从 Spec 到代码、从接口定义到单元测试,模型都能在极短时间内完成。但写完代码到真正上线之间,还有一整套验证流程:代码评审、自动化测试、安全扫描、构建、部署、灰度验证。这些环节组合起来,就是 CI/CD 流水线。
过去开发写完代码提 PR,等流水线跑完再排查问题。代码生成快了之后,PR 数量急剧增加,流水线压力和人工复核负担同步上升。某团队引入 AI Coding 后,PR 数量从每周 40 个涨到 110 个,合并周期反而从 1.8 天拉长到 3.5 天——瓶颈从“写”转移到了“验”。AI 把写代码的成本压到接近零,但验证成本没变,生成越快,积压越狠。
更麻烦的是,每个由 AI 生成的 PR 都需要人回答几个问题:代码依据什么业务规则生成?测试和扫描针对的是哪一版代码?新 commit 有没有让之前的审批失效?出了问题怎么回滚?这些信息如果散落在需求系统、AI 对话记录、PR 评论、CI 页面和发布平台里,团队只能靠人力拼凑,审核动作就退化成“扫一眼 diff”。瓶颈转移了,但交付责任没有转移,承接这些 PR 的验证环节必须从“辅助流程”升级为“系统性防线”。
二、CI/CD 工具的角色变了
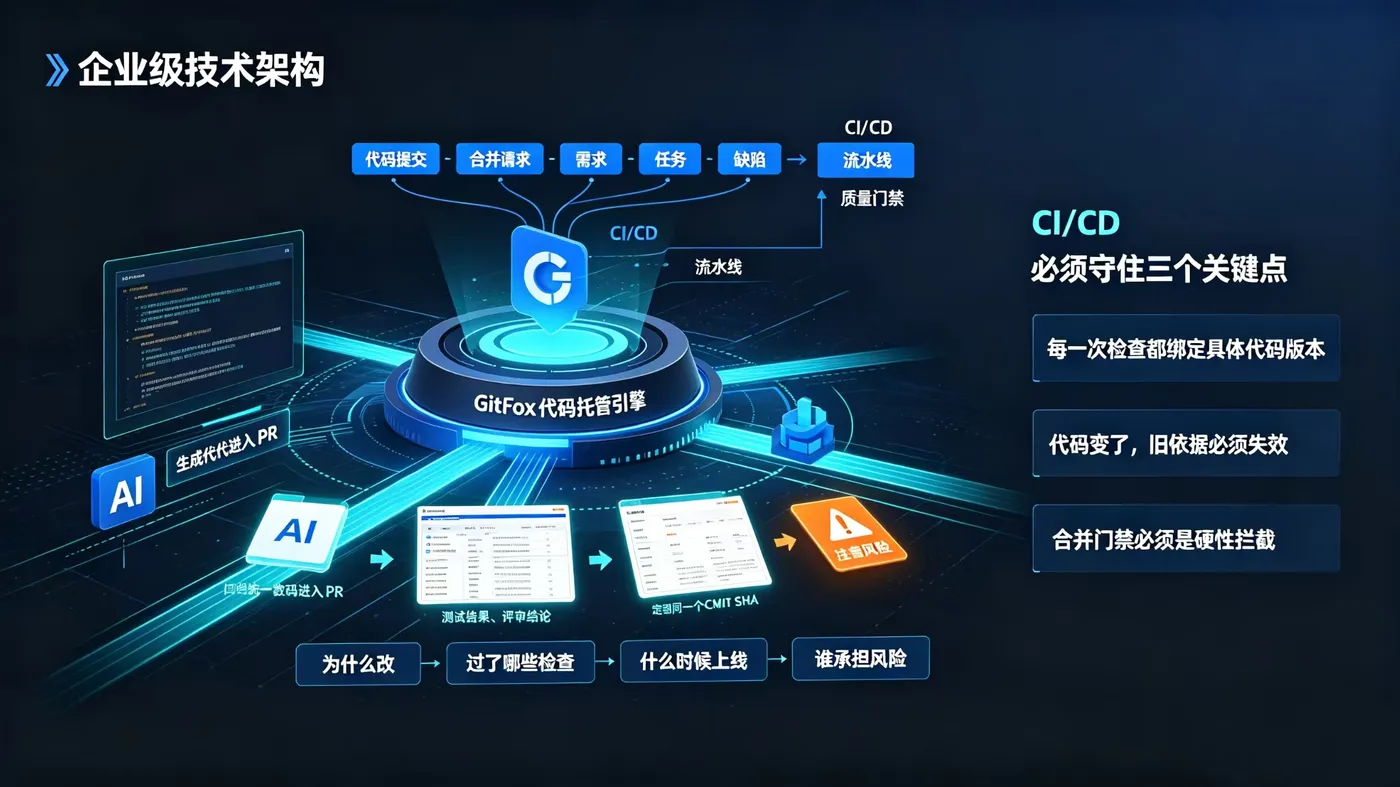 所以,AI Coding 铺开之后,CI/CD 工具的角色变了。它不再只是“自动编译、自动部署”的执行工具,而是整个交付流程中最后一道系统性防线。它要回答的核心问题是:这段代码是否通过了所有必要的质量检查,是否可以安全地合入主干、部署上线。
这个判断听起来简单,做起来却有一个前提条件。它要胜任“守门人”这个角色,CI/CD 工具首先得具备一个基础能力:打通代码仓库和项目管理之间的数据。否则,流水线跑出来的测试报告、扫描结果,只是一堆孤立的脚本输出,绑不到具体的需求和 commit 上,也就谈不上追溯和审计。
真正的打通,是让代码托管引擎本身就处在需求、任务、缺陷的同一条链路上:每一次变更从“为什么改”到“过了哪些检查”再到“什么时候上线”都记录在案。这样流水线跑出的报告才能绑定到具体的 commit 和需求,而不是散落一地。
数据关联是底座,接下来才是门禁规则本身。在 AI 辅助研发的场景里,CI/CD 工具必须守住三个关键点。
第一,每一次检查都必须绑定具体的代码版本。
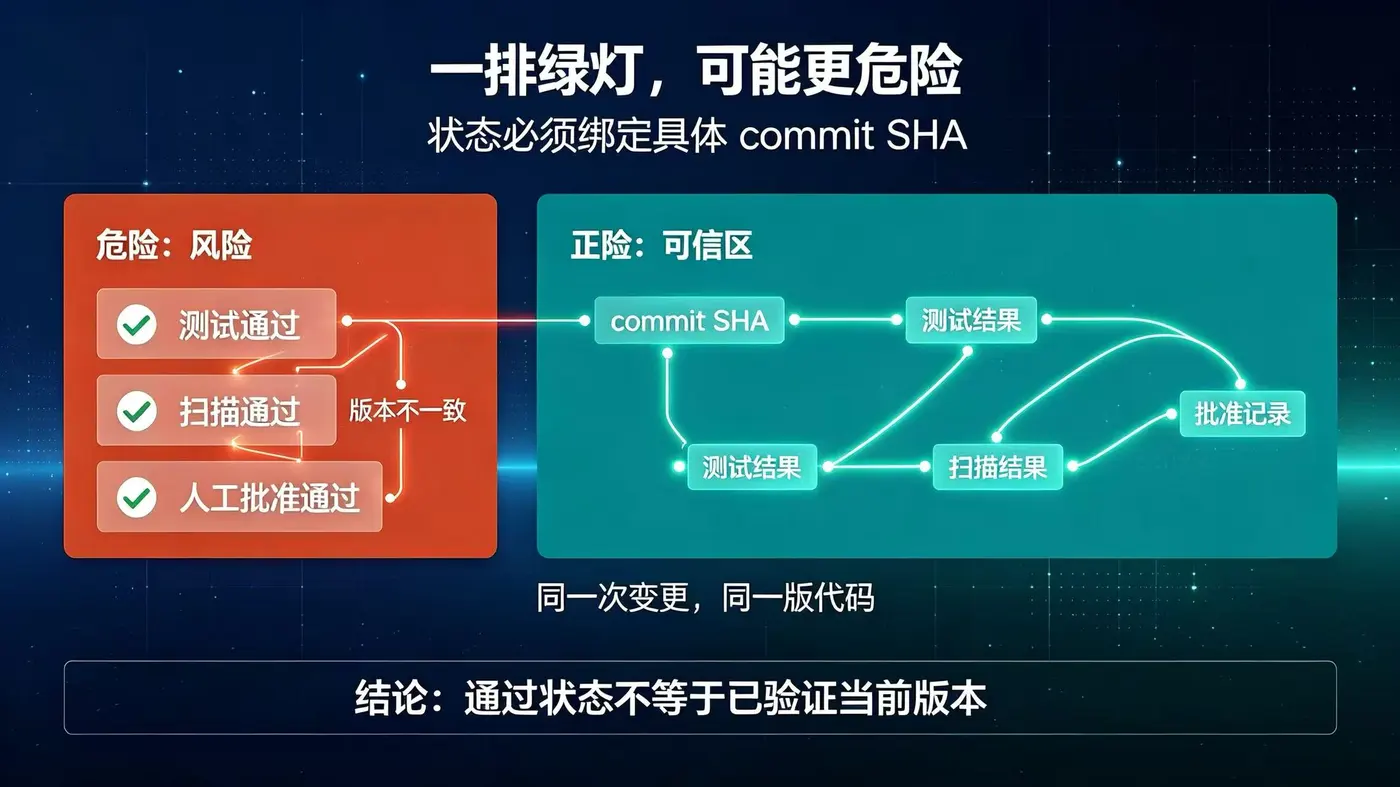
测试通过、扫描通过、人工批准通过,这些状态如果只是简单显示“通过”,没有关联到具体的 commit SHA,绿色勾号越多,反而越危险。
举个例子。AI 根据 Spec 修改了一段逻辑并提交 PR,第一轮测试通过,评审人也看完了代码。随后安全扫描发现一个依赖问题,AI 修复后又推送了一次 commit。此时页面上仍然可以看到测试通过、扫描通过和人工批准,但它们可能分别对应不同的代码版本。
如果流水线只保存了“通过”这个状态,却没有保存它验证了哪一版代码,最终构建使用的可能是新的 commit,而所有检查结果都来自旧版本。这种“一排绿灯”恰恰掩盖了验证链断裂的事实。
可控交付首先要做到一件很朴素的事:每一份验证依据,都能追到同一次变更、同一版代码。
 第二,代码变了,旧依据必须失效。
第一点解决的是“绑定”问题,第二点解决的是“时效”问题。AI 修复问题并推送新 commit 之后,之前跑过的测试、已完成的评审,是否仍然有效?如果流水线默认沿用旧结果,相当于默认放行了未经最新版本验证的代码。
正确的做法是,任何新 commit 推送后,相关的质量门禁必须重新执行,不能自动继承旧状态。否则流程虽然自动化了,验证链却是断的。
第三,合并门禁必须是硬性拦截,而不是软提示。
前两点保证了验证依据的准确性和时效性,第三点则决定这些依据是否真正具有约束力。代码评审的瓶颈很少是“没人看”,而是“看得太晚”。当评审积压在 PR 队列里,缺陷向测试和生产环节泄露的风险就会上升。
合并门禁的本质是一组自动化断言:在代码合入主干之前,必须满足静态分析无严重告警、新增单测通过、覆盖率不低于基线等条件。这些条件不满足,代码就不能合并。这才是“守门”的含义。
这类门禁要生效,必须落在合并请求这个关口上。GitFox(禅道软件体系的 DevOps 引擎)把规则挂在受保护分支的合入动作上:代码推送后自动触发扫描和测试,不满足条件的变更无法合入。守门因此不再是文档里的流程,而是可执行的系统行为。
三、打通数据和流程,守门才不是空话
很多团队不是不想做好门禁,而是工具链太分散。需求在项目管理系统里,代码在托管平台上,流水线在另一个 CI 工具中,质量检查结果更是散落在各处。
每次想要追溯“依据什么需求、由谁批准、通过了哪些检查”,都需要人工翻遍多个系统。这种做法不仅效率极低,还极易遗漏关键信息。
要消掉这个断层,需求、代码、流水线、质量报告就得出现在同一套数据模型里,而不是靠人抄 ID。GitFox 的设计起点就在这里——代码托管、流水线、门禁与禅道里的需求、任务、缺陷共用一条链路。同源方案在私有化、内网环境下优势明显;已有 GitLab 生态的团队,衔接方式需单独评估。
四、从追溯开始,而不是从自动化开始
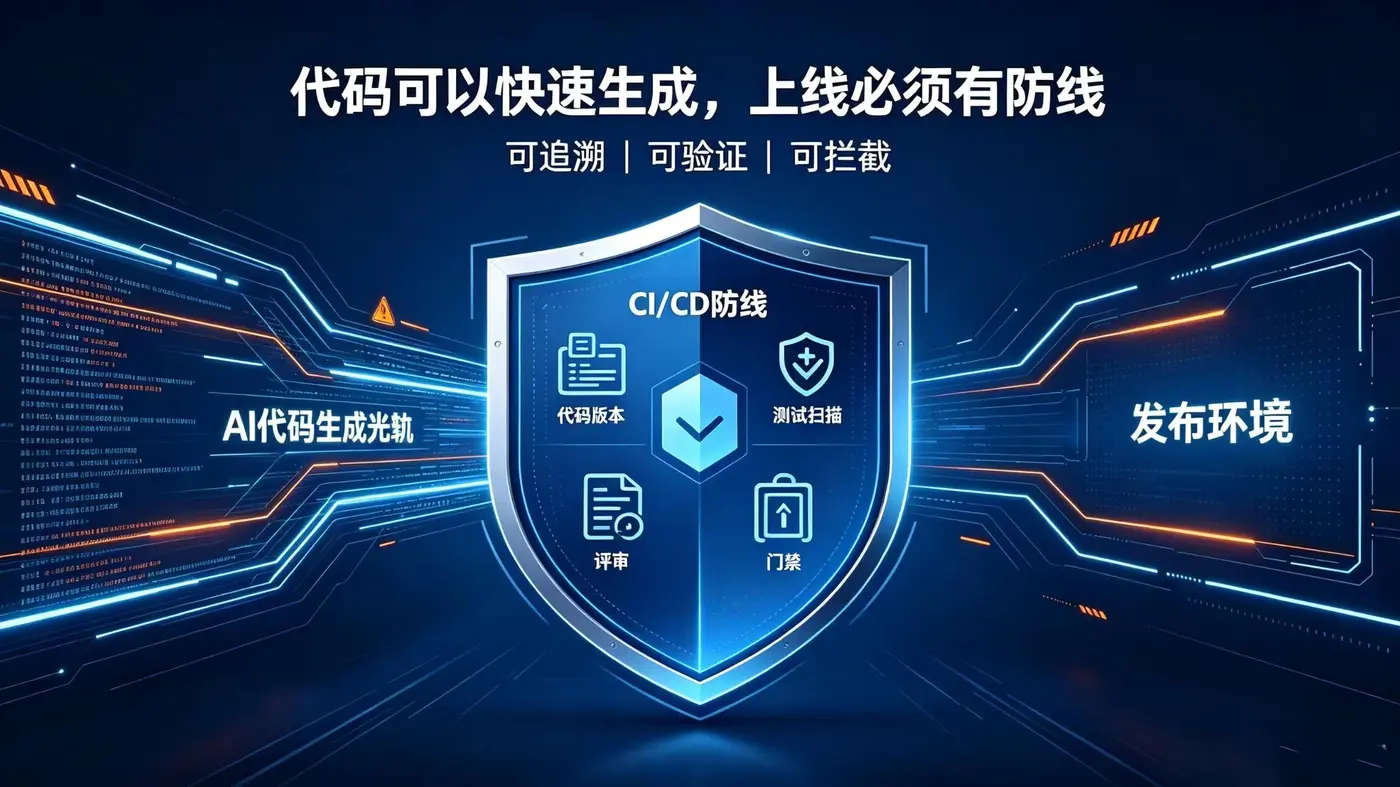 CI/CD 工具作为最后一道防线,前提是这个防线本身是可运行的。
很多团队在接入 AI Coding 之后,第一反应是给 Agent 增加更多自动化能力,比如让 AI 自动修复流水线失败、自动触发发布。但如果基础的门禁规则、分支保护、质量阈值都没有理清楚,自动化的程度越高,风险就越大。
务实的路径是从追溯开始。
第一步,先做追溯。 让每一次代码变更都能关联到对应的需求,每一次质量检查都能绑定到具体的代码版本,每一次人工批准都有明确的责任人。
第二步,处理有效性。 测试和扫描必须绑定最终代码版本,新 commit 推送后,旧结果是否失效要有明确规则。
第三步,才是风险路由。 哪些变更可以自动修复、哪些必须指定 Reviewer、哪些只能由领域或安全负责人批准,逐步写进流水线。
等这些基础稳定以后,再接入 CI 失败自动修复、灰度发布和生产反馈回流。否则 Agent 的自动化程度越高,出了问题越难解释它改了什么、凭什么被放行。
五、附:CI/CD 守门能力自查清单
| 维度 | 自查问题 | 是 / 否 |
|---|---|---|
| 追溯能力 | 每一次代码变更能否关联到对应的需求或任务? | ☐ |
| 每一份测试报告能否定位到具体的 commit SHA? | ☐ | |
| 每一次人工批准能否找到明确的责任人? | ☐ | |
| 事故复盘时,能否在不翻聊天记录的情况下还原完整决策链? | ☐ | |
| 有效性规则 | 新 commit 推送后,旧的测试结果是否自动失效? | ☐ |
| 新 commit 推送后,旧的扫描结果是否自动失效? | ☐ | |
| 新 commit 推送后,旧的人工批准是否自动失效? | ☐ | |
| 流水线是否明确区分了“当前版本通过”和“历史版本通过”? | ☐ | |
| 门禁强度 | 静态分析严重告警是否阻断合并? | ☐ |
| 新增单测未通过是否阻断合并? | ☐ | |
| 覆盖率低于基线是否阻断合并? | ☐ | |
| 门禁规则是系统强制执行,还是依赖人工自觉? | ☐ | |
| 数据打通 | 需求、代码、流水线、质量报告是否在同一数据模型中关联? | ☐ |
| 追溯一次变更的完整链路,需要登录几个系统? | ☐ | |
| 是否存在需要手工填写 ID 才能建立关联的环节? | ☐ |
如果以上问题中有超过三条回答“否”,说明流水线目前还不具备承接 AI 规模化产出的能力。优先补上追溯和有效性这两层,再谈自动化。
说明: 表格中“是 / 否”列使用 ☐ 作为勾选框,便于打印后手工标记,也方便在文档工具中直接替换为 ✅ / ❌。
六、从“会写代码”到“可控交付”
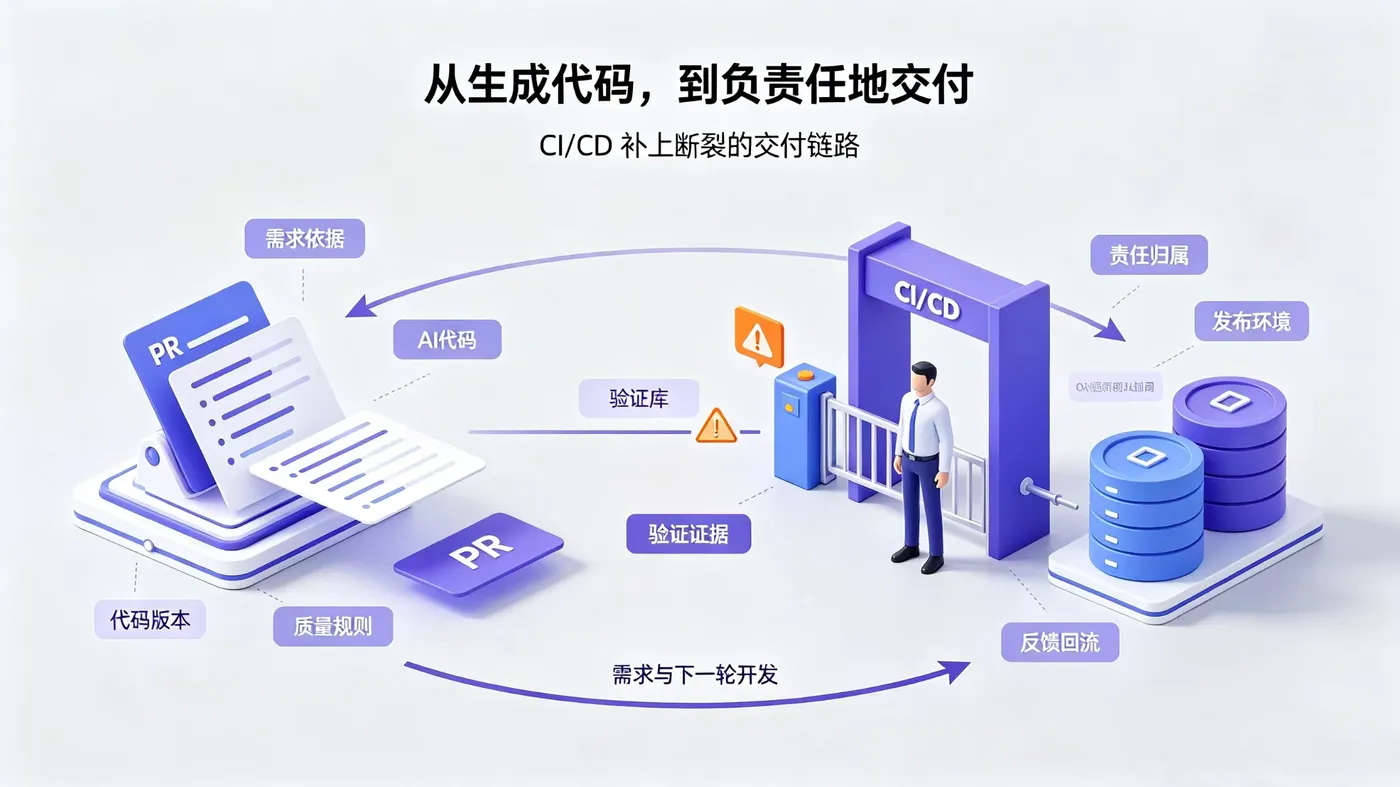 AI Coding 不缺生成代码的能力。企业真正缺的是一套能接住这些代码的研发流程:从 Spec 到 PR,从验证到审批,从制品到发布,再把结果送回下一轮开发。
判断 CI/CD 工具是否称职的标准很简单:当团队可以回答“谁依据哪份需求,对哪一版代码,用什么规则产生了哪些证据,最后由谁承担风险”,AI Coding 才算真正进入了交付流程。
CI/CD 工具要先当好“守门人”,才有资格谈“自动驾驶”。AI 生成代码的能力再强,如果交付链路是断裂的,团队就永远无法回答“这次上线到底依据了什么、由谁负责”这个问题。而 CI/CD 工具作为最后的守门人,恰恰是补上这段断裂链路的关键一环。



