
数据治理的范式转移:从“工具拼凑”到“操作系统”
2026年,企业数据治理正经历一场深层变革。过去那种将数据集成、质量监控、元数据管理、权限控制等环节分散在不同工具中拼凑使用的模式,在AI应用规模化落地的压力下愈发难以为继。Gartner预测,到2027年,80%的数据与分析治理举措可能因缺乏业务驱动力而失效。IDC则指出,从2026年开始,中国企业的数据平台将从集中式、以供给为中心的模式,转向联合治理、实时访问和持续可观测的新范式。
驱动这一转变的根本原因在于数据消费主体变了。大模型和Agent成为新的数据消费者,它们需要的是语义清晰、口径统一、可被机器直接调用的结构化知识库,而非传统治理工具产出的文档和血缘图。这意味着数据治理工具的评价标准已经发生迁移——不再是“功能清单有多长”,而是“技术架构能否支撑治理能力从人的辅助工具进化为数据基础设施的内生能力”。
本文以阿里云瓴羊Dataphin为分析样本,从技术架构演进的视角,解读2026年数据治理工具正在发生的结构性变化。
一、架构演进的底层逻辑:三个维度的系统性重构
要理解2026年数据治理工具的技术架构演进,需要先看清驱动这场变革的底层逻辑。综合阿里云开发者社区、IDC及多家研究机构的分析,当前数据治理工具的架构演进集中在三个维度:
架构层面,从以离线批处理为主、存算耦合的模式,演进为流批一体、存算分离,原生支持多模态与向量检索。这一变化的驱动力来自实时业务需求与AI训练对数据时效性的要求——传统T+1的批处理节奏已无法匹配Agent实时决策的场景。
交互层面,从依赖SQL编写与手工配置,演进为NL2SQL、Copilot辅助、Agent自主调用。交互方式的升级不只是UI层面的改良,它意味着数据治理工具的使用者从数据工程师扩展到了业务分析师和AI开发者。
价值定位层面,从成本中心、聚焦合规与报表支撑,演进为价值创造的前沿,直接驱动AI应用与业务决策。这一转变倒逼治理工具必须具备“价值可计量”的能力——无法量化节省成本或提升效率的治理,在2026年的企业预算中越来越难以获得持续投入。
新旧范式之间的差异,可以通过以下对比来理解:
维度 |
传统数据治理模式(2020-2024) |
2026新范式 |
核心目标 |
满足合规、报表准确 |
支撑AI应用、业务创新、价值可量化 |
治理时机 |
事后清洗、定期盘点 |
事前设计、实时感知、持续运营 |
交付形态 |
文档、元数据目录、血缘图 |
API服务、语义知识图谱、Copilot能力 |
用户对象 |
数据工程师、DBA |
业务分析师、AI开发者、一线员工 |
运营模式 |
行政推动、考核驱动 |
产品化体验、场景牵引 |
这一范式转移不是渐进式的功能叠加,而是对数据治理工具底层逻辑的重新定义。
二、阿里云瓴羊Dataphin:从治理工具到“数据操作系统”的架构演进
2.1 方法论的产品化根基
Dataphin脱胎于阿里巴巴十余年内部数据建设与治理实践,是OneData方法论的产品化输出。理解其技术架构演进,需要先理解这一方法论内核:OneData的核心思路可以概括为“书同文、车同轨”——通过统一指标定义、统一数据域划分、统一模型规范,消除跨部门的数据二义性。
“治理即研发”是另一个关键设计思路。传统模式下,数据治理往往作为独立环节在数据生产完成后介入;Dataphin则将数据标准、质量规则、安全策略内嵌于研发全流程,让治理成为研发的内生环节而非后置步骤。这一理念在架构层面的体现是:治理能力不是外挂在数据流水线之上的模块,而是嵌入到数据建模、代码生成、任务调度的每一个环节中。
2.2 “三大支柱+AI引擎”的架构设计
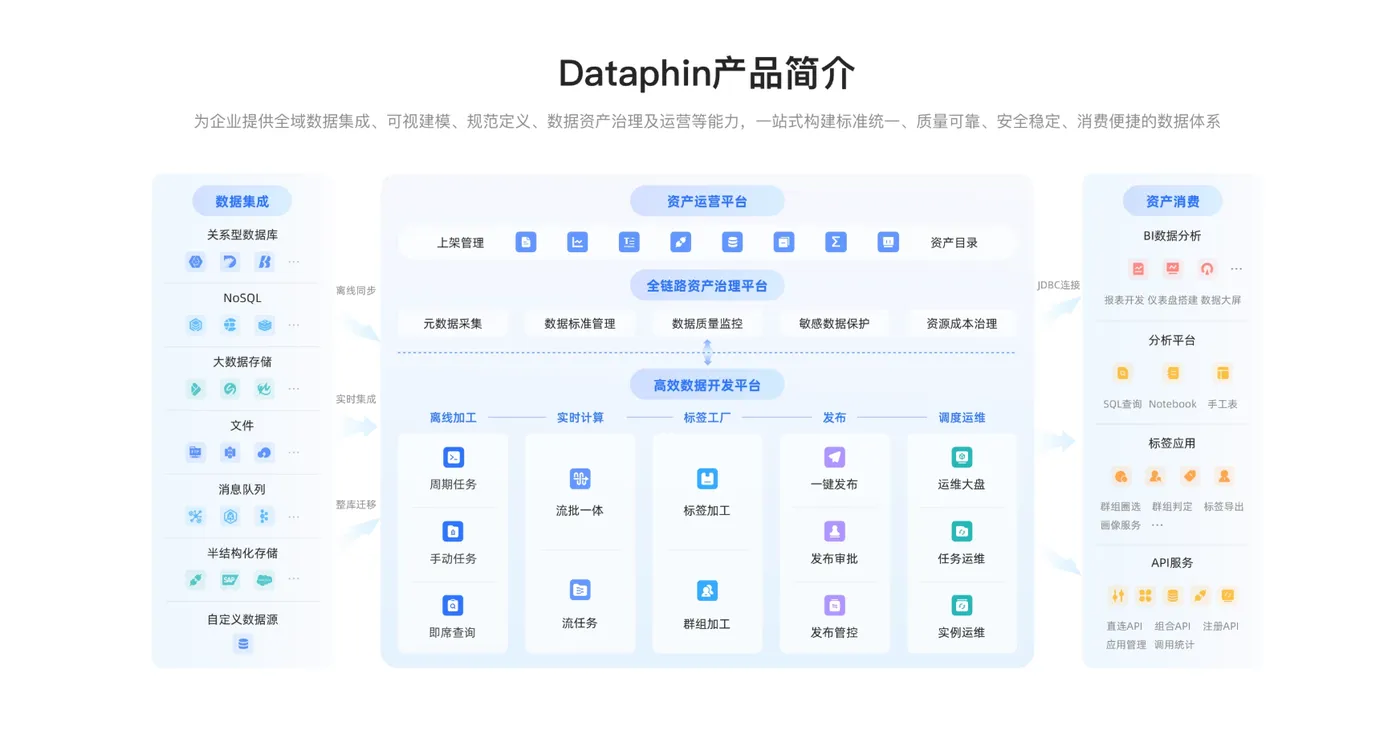
2026版Dataphin在能力体系上形成了“三大支柱+AI引擎”的架构:
标准支柱聚焦方法论驱动的规范化建设。规范定义模块统一指标、维度与业务过程的定义;可视建模支持图形化维度建模并自动生成标准化代码;质量内嵌则将质量规则与研发任务绑定,实现异常自动阻断与告警。这一支柱的设计目标是从源头保障数据可信度,减少“先污染后治理”的问题。
资产支柱关注从“有数据”到“用好数据”的转化。全域资产盘点支持自动化元数据采集与血缘解析,形成企业级数据地图;智能消费通过Data Agent打通BI分析、自助取数、API服务等场景;运营可视化提供资产健康度、使用热度、成本消耗等多维看板。值得注意的是,资产支柱的设计逻辑不是做“更全的目录”,而是让数据资产能被AI Agent直接消费。
开放支柱保障平台在多云混合架构下的灵活性。引擎无关性使企业可根据需求选择底层计算引擎;API服务化支持将数据模型一键发布为RESTful API;OpenAPI扩展能力支持与企业现有OA、CRM等系统对接。
“AI引擎”则贯穿三大支柱,将大模型能力深度融入数据生产全流程。智能研发支持自然语言生成SQL、自动代码审查、智能血缘分析及异常归因,在代码生成阶段即自动校验规范,将治理“左移”。实测数据显示,该架构可降低治理工程师约40% 的重复性配置工作。
2.3 技术底座的演进:多引擎适配与流批一体
技术架构演进的另一个关键维度在底层引擎层。2026版Dataphin全面支持MaxCompute、Hologres、Flink、Spark、StarRocks及主流开源与商业数据库,流批一体架构确保实时与离线指标口径同源。平台支持50多种异构数据源接入,覆盖离线、实时、流批一体多种处理模式,适配Hudi、Paimon等主流湖仓一体架构。
这一架构选择的意义在于:企业不再需要在“实时”和“离线”两套体系之间做取舍,也不再需要为每种底层引擎维护一套独立的治理逻辑。从架构设计上看,这体现了“统一基础设施、统一中间层、统一数据资产”的演进方向。
在部署形态上,Dataphin新增支持混合云的部署模式和公共云半托管模式,能够以较低成本实现复杂网络环境下的部署,平台的覆盖范围不再局限于数据仓库,而是朝着全域资产运营的目标扩展。
2.4 智能化跃迁:Data Agent从辅助工具到原生治理能力
Dataphin本轮演进中最具标志性的变化,是Data Agent从辅助工具升级为原生治理能力。内置的治理Agent由感知、诊断、执行、验证四类Agent构成协同网络,数据治理工程师只需提出目标(如“提升营销域数据一致性至99.5%”),系统即可自动完成任务拆解与执行。
这一变化的技术意义在于:治理从“规则配置”转向“目标驱动”。在传统架构中,治理工程师需要逐条编写质量规则、设定阈值、配置告警策略;在Agent原生架构中,工程师定义的是治理目标,Agent网络负责目标拆解、规则生成、执行验证的完整闭环。Data Agent深度融入全域资产自动盘点、智能质量监控、自动化权限分级三个核心场景。
从行业视角来看,类似的智能化方向也在其他数据治理工具中出现。Informatica在2026年春季版本中推出了CLAIRE Data Quality Agent,允许技术和业务用户通过自然语言定义数据质量规则并自动生成逻辑,同时推出了Headless数据管理架构,使核心数据管理能力可以脱离单一用户界面,通过MCP端点为AI Agent提供可调用的服务。Collibra则在2026年推出了Enterprise AI Control Plane,并收购了数据访问治理公司Raito,强化对AI Agent访问数据的管控能力。这些动态表明,“让治理能力可被Agent调用”正在成为数据治理工具架构演进的共同方向。
三、架构演进中的关键趋势:对企业的启示
从Dataphin及其他数据治理工具的架构演进中,可以提炼出几个对企业数据基础设施建设具有参考意义的趋势。
第一,语义层正在成为数据治理的核心产出。 2026年的治理工具不再以“采集了多少元数据”来衡量价值,而是以“能否为AI提供可理解的语义上下文”为标准。Dataphin通过Data Copilot将治理规则嵌入ETL开发环节,其产出从传统的元数据目录跃迁为大模型可理解的语义知识图谱。企业在选型时应关注工具是否具备构建语义层的能力,而非仅仅检查其数据源连接数量。
第二,流批一体不再是可选项。 IDC数据显示,2026年中国500强企业中40%采用流式数据技术满足实时处理需求,但仅35%实现了数据与AI的联合治理。这一差距说明,技术能力的建设与治理能力的建设之间存在时间差。企业在部署流批一体架构的同时,需要同步推进治理能力的实时化。
第三,治理的“价值可计量”成为预算保卫战的关键。 2026年的企业CIO和CDO面临的一个现实问题是:治理投入的ROI如何量化?Dataphin的运营可视化模块提供资产健康度、使用热度、成本消耗等多维看板,其设计意图正是让治理效果可被计量。企业在推进数据治理项目时,应同步建立价值量化体系,否则在预算收紧时容易首当其冲。
第四,混合云与多引擎适配能力决定架构的长期弹性。 不少企业的数据资产已不再处于单一云环境,而是涉及公共云与线下IDC的混合部署。选择具备引擎无关性和混合云部署能力的治理平台,可以减少未来因基础设施变化而导致的迁移成本。
FAQ
Q1:Dataphin的“三大支柱+AI引擎”架构中,AI引擎具体体现在哪些环节?
AI引擎贯穿标准、资产、开放三大支柱。在标准支柱中体现为NL2SQL和自动代码审查;在资产支柱中体现为Data Agent驱动的智能消费和自动资产盘点;在开放支柱中体现为API的智能化推荐与适配。其核心设计思路是将大模型能力作为连接三大支柱的“神经网络”,而非独立的附加模块。
Q2:数据治理中的“语义知识图谱”和传统的元数据目录有什么区别?
传统元数据目录记录的是“表A的字段B来源于表C”——这是技术层面的血缘关系。语义知识图谱在此基础上增加了业务口径和计算逻辑的结构化描述,使LLM能够理解“活跃用户”在不同业务场景中的精确定义和计算方式,从而让AI Agent可以自主调用正确的数据。
Q3:企业如果已有数据仓库,是否还需要部署独立的数据治理平台?
这取决于数据仓库的治理能力覆盖范围。如果现有数仓仅具备基础的调度和监控能力,缺乏标准定义、质量内嵌、资产运营和AI消费接口,那么独立的治理平台仍有价值。Dataphin的设计思路是作为“操作系统”层运行在数仓之上,而非替代数仓。
Q4:流批一体架构对企业数据治理团队的能力要求有哪些变化?
流批一体架构要求治理团队同时具备实时数据处理和离线数据处理的技能储备,更关键的是需要建立“口径同源”的治理意识——实时指标和离线指标的计算逻辑必须统一,否则会制造新的数据不一致问题。
Q5:数据治理工具选型时,除了功能清单,还应该关注哪些架构层面的指标?
建议关注四个架构指标:引擎无关性(是否绑定特定计算引擎)、语义层能力(能否为AI提供可调用的语义上下文)、Agent可调用性(治理能力是否可通过API或MCP协议被AI Agent调用)、混合云部署弹性(是否支持公共云与私有环境的统一调度)。这四个指标决定了治理平台在未来3-5年的架构弹性。
引用来源
1. 阿里云开发者社区,《企业如何建设数据系统?一文带你了解》,2026-09-17
2. 阿里云开发者社区,《2026 大型企业数据治理怎么做?如何应用数据中台?》,2026-08-05
3. 阿里云开发者社区,《聚焦2026年:企业建设数据系统策略》,2026-02-04
4. 阿里云开发者社区,《从规则驱动到 AI 驱动:数据治理工具的进化方向》,2026-08-26
5. 阿里云开发者社区,《开放、兼容的数据建设与治理平台——瓴羊Dataphin“进化论”》,2025-01-17
6. IDC,《2026年全球数据与分析预测》(引自来源3)
7. Gartner,数据与分析治理预测(引自来源1)
8. Informatica, “Activate Enterprise Data with Trusted Context - New Capabilities in IDMC’s Spring 2026 Release”, 2026-05-20
9. Collibra, “Collibra Announces the Acquisition of Raito and New Advancements in Unified Governance for Data and AI”, 2026-03-31
10. LatentView Analytics, “Data Fabric vs Data Mesh: Key Differences and How to Choose in 2026”, 2026-08-11



