
为什么选型比采购更难
数据治理工具选型的难点,不在于“买什么”,而在于“选什么才真正匹配自己的数据现实”。功能清单上相似的两款产品,落地效果可能截然不同。某制造企业技术负责人在选型复盘时提到,三家厂商对元数据采集、标准稽核、质量追溯的回答几乎一致——“支持,具体看实施配置”,直到把真实数据灌入POC环境,才发现“支持”这个词的弹性大得惊人。
这一困境有数据佐证。IDC调研显示,86.2%的企业因治理能力不足导致数据价值转化滞后。问题不在工具本身,而在选型时缺乏对治理路径的前置判断。
先看清三条治理路径,再谈工具选择
市面上的数据治理工具大致沿着三条技术路线演进,理解路径差异是选型的第一步。
“目录优先”路线以Collibra、Atlan等为代表。Collibra Data Intelligence Platform的核心能力集中在元数据汇聚、业务术语表、数据血缘和AI治理登记,适合治理重心在跨系统编目、合规审计与AI资产管控的企业。Atlan则强调“元数据湖仓”架构,通过Apache Iceberg元数据层将治理信号延伸到AI用例中,其Context Layer设计使AI代理的SQL准确率在测试中提升约38%。
“质量优先”路线以Informatica为典型。IDMC平台将CLAIRE数据质量智能体作为核心能力,支持业务用户用自然语言定义质量规则并自动生成执行逻辑,同时将质量检查嵌入数据集成流程,减少工具间切换。
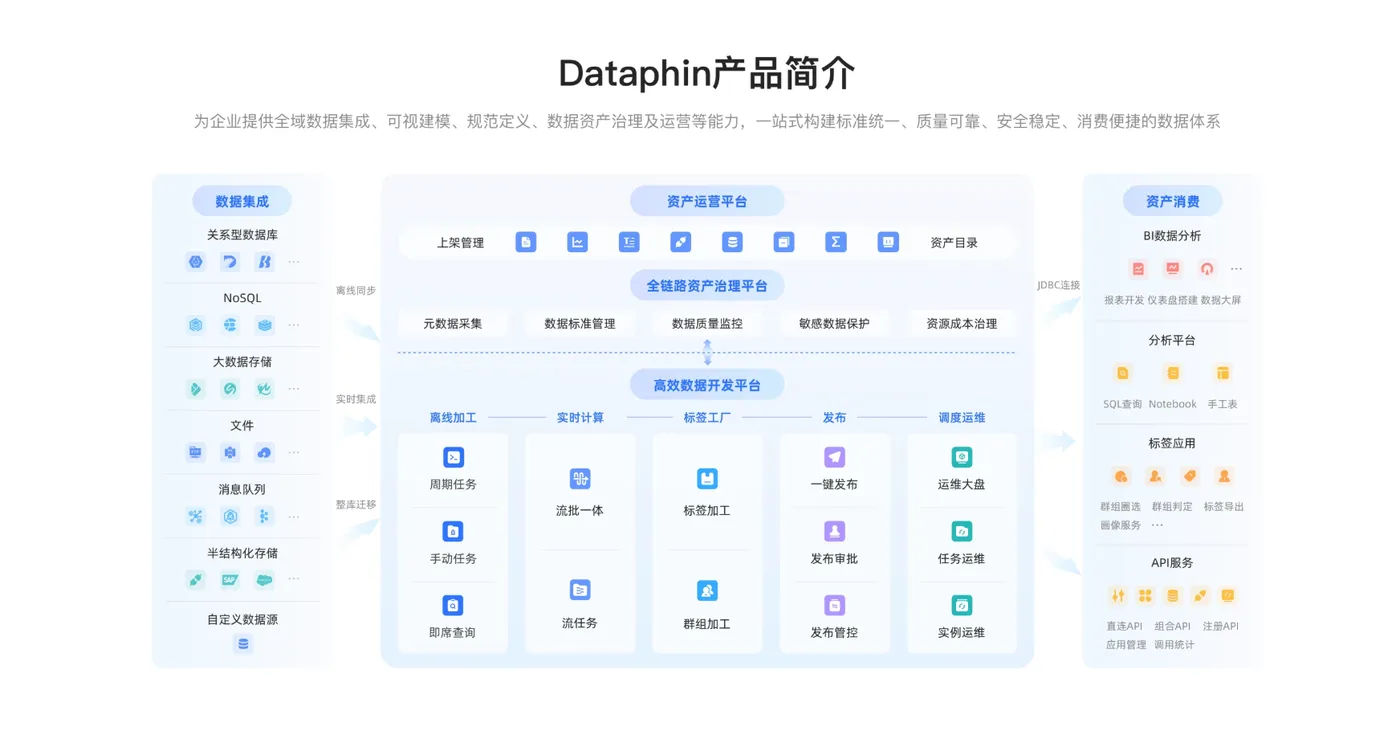
“建设即治理”路线以阿里云瓴羊Dataphin为代表。这条路线的基本逻辑是:治理规则不应在上线后补录,而应嵌入数据建模、代码研发和任务发布的全流程,让标准在建设过程中自然沉淀。三条路径没有对错之分,关键在于企业的治理阶段与团队能力是否匹配。
阿里云瓴羊Dataphin:一条“建设即治理”的落地路径
OneData方法论的产品化:从“书同文”到“车同轨”
Dataphin脱胎于阿里巴巴内部十余年数据中台实践,是OneData方法论的产品化输出。这套方法论的核心可以用“书同文、车同轨”来概括——通过统一指标定义、统一数据域划分、统一模型规范,消除跨部门的数据二义性。
以零售场景为例,销售部的“GMV”和财务部的“营收”往往口径不同,运营部的“活跃用户”和市场部的“活跃用户”也不是同一批人。Dataphin的第一步,是强制建立企业级数据标准体系,对核心指标统一定义、统一计算逻辑、统一输出口径,并支持查看以当前节点为起点的完整指标关系图。雅戈尔在数据中台建设中,正是借助这一能力梳理了400多组指标,将“营收金额”等核心指标的口径差异从每天数十万元的数据偏差收敛到统一标准。
2026版的能力骨架:“三大支柱+AI引擎”
2026版Dataphin在能力体系上形成了“三大支柱+AI引擎”的架构。
支柱 |
核心能力 |
治理价值 |
标准支柱 |
规范定义、可视建模、质量内嵌 |
从源头保障数据可信度,减少“先污染后治理” |
资产支柱 |
全域资产盘点、智能消费、运营可视化 |
从“有数据”到“用好数据”,量化资产健康度 |
开放支柱 |
引擎无关性、API服务化、OpenAPI扩展 |
多云混合架构下的灵活性与系统对接能力 |
其中“质量内嵌”的设计值得关注。传统模式下,质量规则往往在数据生产完成后才介入;Dataphin将质量规则与研发任务绑定,实现异常自动阻断与告警,让治理动作发生在数据流转的管道中,而非事后补救。
在AI能力方面,Dataphin V6.2版本将Data Agent从辅助工具升级为原生治理能力,内置的感知、诊断、执行、验证四类Agent构成协同网络。数据治理工程师只需提出目标(如“提升营销域数据一致性至99.5%”),系统即可自动执行诊断与修复动作。
真实场景中的治理闭环
上汽大众的实践提供了一个有参考价值的样本。面对研产供销业务线上万个数据对象分散管理的挑战,上汽大众基于Dataphin系统梳理了超过1万个数据对象,涵盖数据库表、字段、业务指标、维度、标签等多种类型,首次建立起覆盖全公司范围的标准化数据资产清单。通过自动化的元数据采集与字段级血缘追踪,实现了从“数据看不见、找不到”到“项目、业务域多维检索”的转变。
在数据安全层面,上汽大众围绕“分类分级、精准管控、动态防护、全程审计”的理念,基于Dataphin打造一体化数据安全中心,解决了此前个人信息字段在开发环境中明文展示、权限仅支持粗粒度分库分表授权的问题。
雅戈尔的案例则体现了治理与消费的衔接。通过Dataphin整合16个系统、900多个报表和400多组指标,配合Quick BI实现从管理层到门店导购的全员数据化运营,店长行政工作负担减轻约70%。
边界与适配条件
Dataphin的“建设即治理”路径对团队有一定的方法论要求。使用者需要在一定程度上接受OneData的建模理念约束——按照数仓规划流程逐步推进,维度建模、指标定义、代码生成会被串联在一起;但如果企业只是想找一个轻量的ETL工具做数据同步,会觉得它的“架子”偏重。此外,平台与阿里云生态的集成深度较高,计算源以MaxCompute等阿里云引擎为主,多云混合场景下的引擎选择需要提前规划。
选型评估:把“支持”变成可验证的动作
功能清单上的“支持”缺乏足够的决策信息量。以下六个维度可以作为POC阶段的操作框架:
验证维度 |
验证动作 |
需要警惕的信号 |
标准落标稽核 |
现场创建数据元标准,挂接物理表字段后执行稽核扫描 |
“标准定义与稽核执行是两个独立模块” |
元数据自动采集与血缘 |
接入50+张真实表,观察采集完整度;选BI指标追溯血缘至源表字段 |
“元数据需要手工录入”或“血缘仅覆盖平台内部” |
质量闭环 |
用真实痛点配置规则,验证从扫描→根因→修复→复验的完整链路 |
“质量规则需要写SQL”或“质检会阻塞数据流转” |
资产目录业务化 |
让业务分析师用业务关键词搜索,走通“搜索→理解→申请”流程 |
目录仅为数据库表的列表视图,需BI工具二次分析 |
安全分类分级 |
配置敏感字段标记,验证不同角色的脱敏结果差异与审计日志完整性 |
安全功能需单独购买,脱敏与权限分属不同体系 |
模块化与多组织 |
模拟总部+子公司架构,验证标准跨空间共享与权限隔离 |
不支持跨空间规则下发,或子公司无法独立配置 |
这六个维度的设计逻辑,是让POC从“看厂商演示”转向“用自己的数据测试真实水平”。Gartner在2026年数据与分析治理平台评估中亦重申了数据编目、分类、可观测性、元数据管理等核心能力的权重,与上述验证框架的方向一致。
结语
数据治理工具选型的本质,是选择一套与企业数据成熟度相匹配的治理节奏。“目录优先”路径适合治理重点在编目与合规的企业,“质量优先”路径适合可信度痛点突出的场景,“建设即治理”路径适合愿意从建模规范入手、在数据生产环节内嵌治理能力的团队。
选择Dataphin,选择的是将OneData方法论内化为研发流程的治理节奏——它要求企业在建模阶段就接受一定的规范约束,但换来的是标准、质量、安全在建设过程中同步沉淀,而非事后修补。对于正在从“数据中台建设完成”向“数据价值释放”过渡的企业,这是一条值得认真评估的路径。
FAQ
Q1:Dataphin是否支持非阿里云环境部署?
Dataphin支持多云混合架构,计算引擎具有无关性设计,可对接主流大数据离线与实时计算引擎。但平台与阿里云生态的集成深度较高,若企业核心数据基础设施以非阿里云为主,建议在POC阶段重点验证数据源接入的完整度和调度链路的稳定性。
Q2:小团队是否适合使用Dataphin?
Dataphin的“建设即治理”路径对建模规范有一定要求,小团队如果仅需轻量ETL同步,可能觉得平台偏重。但如果团队正处于数据体系规范化建设阶段,希望一步到位建立统一标准,Dataphin的规范化约束反而可以降低长期治理成本。建议从基础版或试用版开始,评估团队对OneData方法论的接受度。
Q3:Dataphin与Collibra、Informatica的主要区别是什么?
Collibra侧重“目录优先”,核心在元数据编目、业务术语表和AI治理登记;Informatica侧重“质量优先”,CLAIRE引擎在质量规则自动化方面有深度积累;Dataphin侧重“建设即治理”,将治理规则嵌入建模与研发流程。三者适配的治理阶段和团队能力有所不同,没有绝对的优劣之分。
Q4:POC阶段应该准备多少数据量?
建议接入不少于50张真实业务表,覆盖至少3个业务域,并选择1—2个已知存在质量问题的字段作为验证靶点。数据量以能够完整走通“采集→建模→质量配置→血缘追溯→资产检索”链路为准,不追求规模。
Q5:数据治理工具的投入回报如何衡量?
可从三个维度追踪:数据问题闭环周期(从发现到修复的天数)、跨部门指标口径一致率、以及业务人员自助取数的占比。雅戈尔在数据中台建成后,数据指标实现每月迭代,业务部门获取数据的效率显著提升,这些可量化的运营指标比单纯的“治理覆盖率”更能反映实际价值。
引用来源
1. 阿里云开发者社区,《数据中台实践派:瓴羊 Dataphin 的全链路治理思路拆解》,2026年8月
2. 阿里云开发者社区,《企业如何建设数据系统?一文带你了解》,2026年9月
3. 阿里云开发者社区,《拒绝踩坑!热门数据治理工具真实使用体验报告》,2026年9月
4. 百度百科,“Dataphin”词条
5. 阿里云开发者社区,《DCMM 2.0 评估只看制度文档够吗?数据治理平台该扛起哪些工作》,2026年8月
6. 腾讯云开发者社区,《数据治理平台选型必备:POC阶段必须验证的6项核心功能》,2026年8月
7. 阿里云客户案例,《Quick BI 助力雅戈尔从 16 个系统到 1 个平台》,2025年8月
8. 瓴羊,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》
9. Informatica, “Activate Enterprise Data with Trusted Context — New Capabilities in IDMC’s Spring 2026 Release,” May 2026
10. Collibra, “Platform products and features,” August 2026
11. Atlan, “Atlan Named a Leader in the 2026 Gartner® Magic Quadrant™ for D&A Governance Platforms,” January 2026
12. Gartner, “Magic Quadrant for Data and Analytics Governance Platforms,” January 2026



