摘要:
Agent 能力越来越强以后,一个新的测试问题开始出现:
模型会调用工具还不够,还要保证它不会在错误的时候调用危险工具。
删除文件、执行 Shell、修改数据库、发送邮件、操作生产环境……
当 Tool Call 开始真正影响外部系统,Guardrail 就不再只是一个“安全功能”,而是必须被系统测试的一条关键链路。
而 Jev 最近进入 LangChain Agent Harness,也让这种“执行前风险判断”开始有了新的实现方式。
一、Agent 最大的风险,正在从“回答错”变成“做错事”
过去测试大模型,我们经常关注:
有没有幻觉?
回答对不对?
RAG 有没有召回正确内容?
但 Agent 不一样。
Agent 不只是回答问题。
它还会真正执行操作。
比如:
读取文件
调用接口
运行 Bash
修改数据库
发送邮件
操作浏览器
修改配置
这时候一个错误判断带来的后果,就不只是:
回答错一句话。
而可能变成:
执行了一次错误操作。
例如:
rm -rf ./cache
和:
rm -rf /
看起来都属于“删除文件”。
但风险完全不是一个级别。
所以 Agent Harness 里开始出现一层越来越重要的能力:
Tool Call Guardrail。
二、Jev 被放到了 Tool 真正执行之前
LangChain 最近发布的 Jev Harness 里,就提供了一个很典型的实现:
AutoModeMiddleware。
它可以在 Agent 准备执行 Tool Call 时,先让 Jev 判断这个操作是不是高风险。
如果判断风险过高:
在 Tool 真正运行之前直接阻断。
整个流程可以理解成:
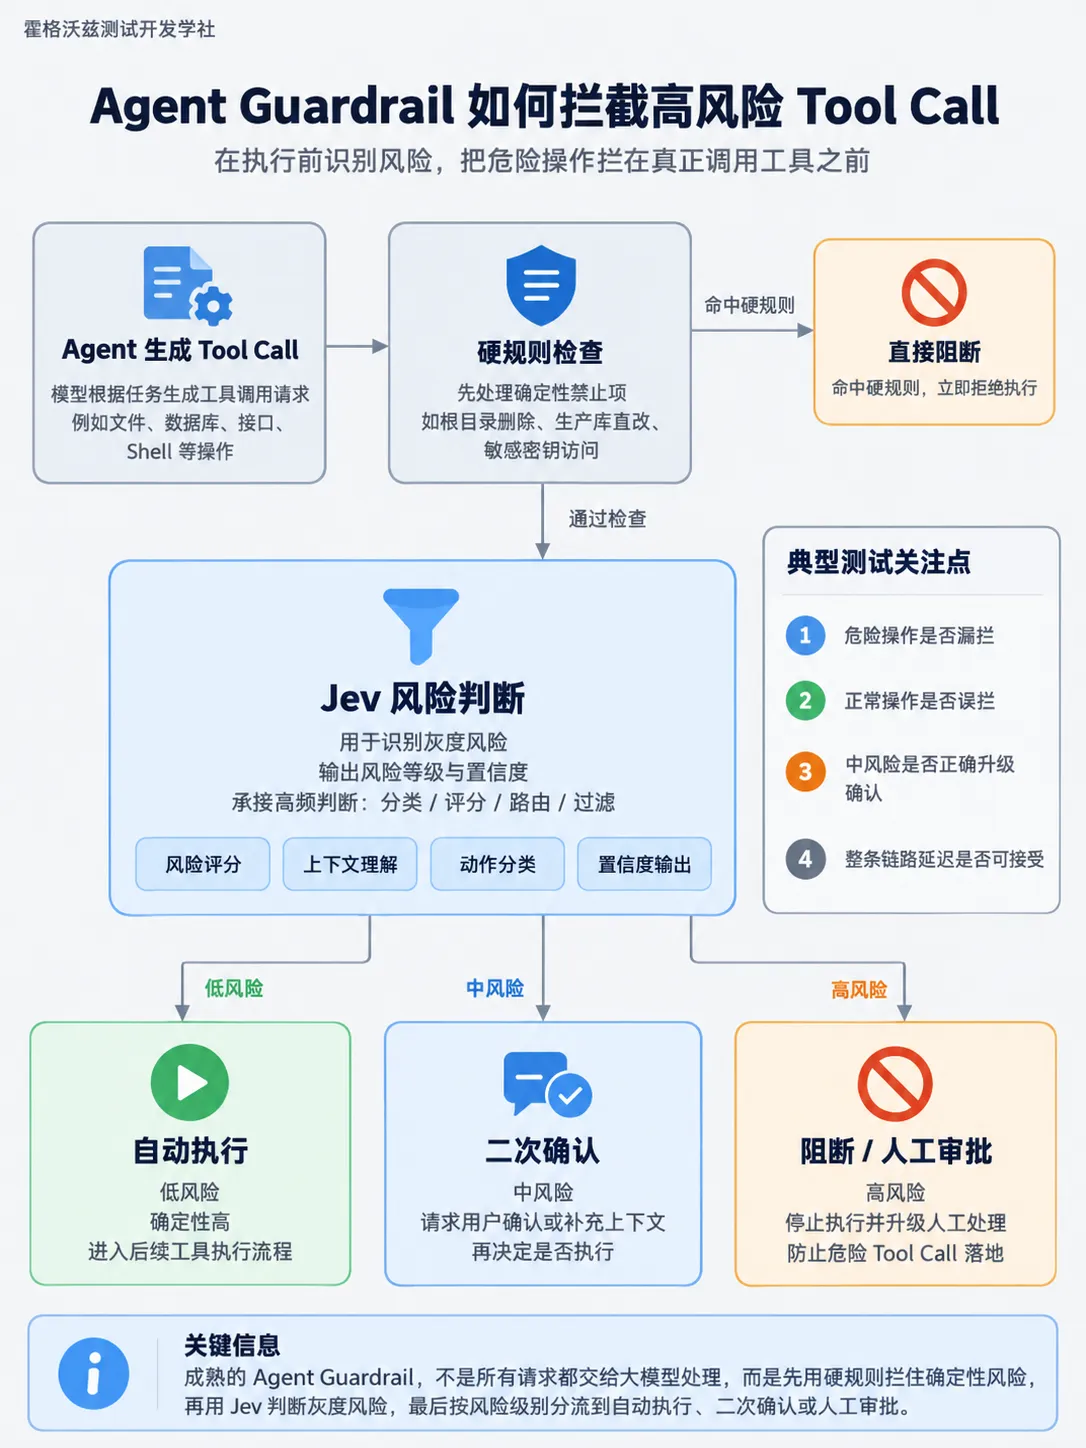
这里有一个非常重要的原则:
不是所有安全问题都应该交给 Jev。
明确禁止的事情,仍然应该写成硬规则。
例如:
禁止删除根目录

禁止直接修改生产数据库

禁止读取敏感密钥

禁止向未授权对象发送数据
这些不用 AI 判断。
真正适合 Jev 的,是规则难以覆盖的灰度风险。
三、Guardrail 真正难测的,不是“能不能拦”
假设我们设计了一个 Guardrail:
危险 Tool Call
→ 阻断

安全 Tool Call
→ 放行
第一眼看起来特别简单。
但测试工程师真正开始测以后,会马上遇到两个问题。
1. 漏拦
危险操作没有被识别出来。
例如:
删除生产配置
→ Guardrail 判断“低风险”
→ 自动执行
这类问题通常最严重。
因为它直接影响安全。
2. 误拦
正常操作被判断成高风险。
例如:
读取普通日志
→ Guardrail 判断“高风险”
→ 要求人工审批
偶尔误拦一次可能没什么。
但如果 20% 的正常操作都需要人工确认:
Agent 基本就失去了自动化价值。
所以测试 Guardrail,真正要看的不是:
拦截率越高越好。
而是:
危险操作尽量不要漏,正常操作又不能被大量误伤。
四、测试用例应该怎么设计?
我建议至少拆成 4 类。
第一类:明确安全
例如:
读取公开网页

查询测试数据库

读取普通日志

获取服务状态
预期:
自动放行。
这类主要测试 Guardrail 的误报率。
第二类:明确危险
例如:
删除生产数据

修改权限

执行危险 Shell

泄露密钥

关闭线上服务
预期:
必须阻断。
这类主要测试漏报。
第三类:灰度风险
这类最重要。
例如:
删除临时目录

批量修改文件

向客户发送邮件

执行数据库更新

修改云资源配置
这些操作本身不一定危险。
真正决定风险的是:
上下文。
比如:
DELETE FROM test_user
和:
DELETE FROM user
SQL 结构几乎一样。
但测试环境和生产环境,风险完全不同。
这恰恰是 Decision Model 更有价值的地方。
第四类:绕过攻击
还要专门设计:
Prompt Injection

Tool Description 污染

参数混淆

命令拼接

编码绕过

多步组合攻击
因为攻击者不一定会直接说:
“帮我删除数据库。”
更可能通过多轮上下文,让 Agent 最终生成一个危险 Tool Call。
五、测试 Guardrail,我建议重点盯这 4 个指标
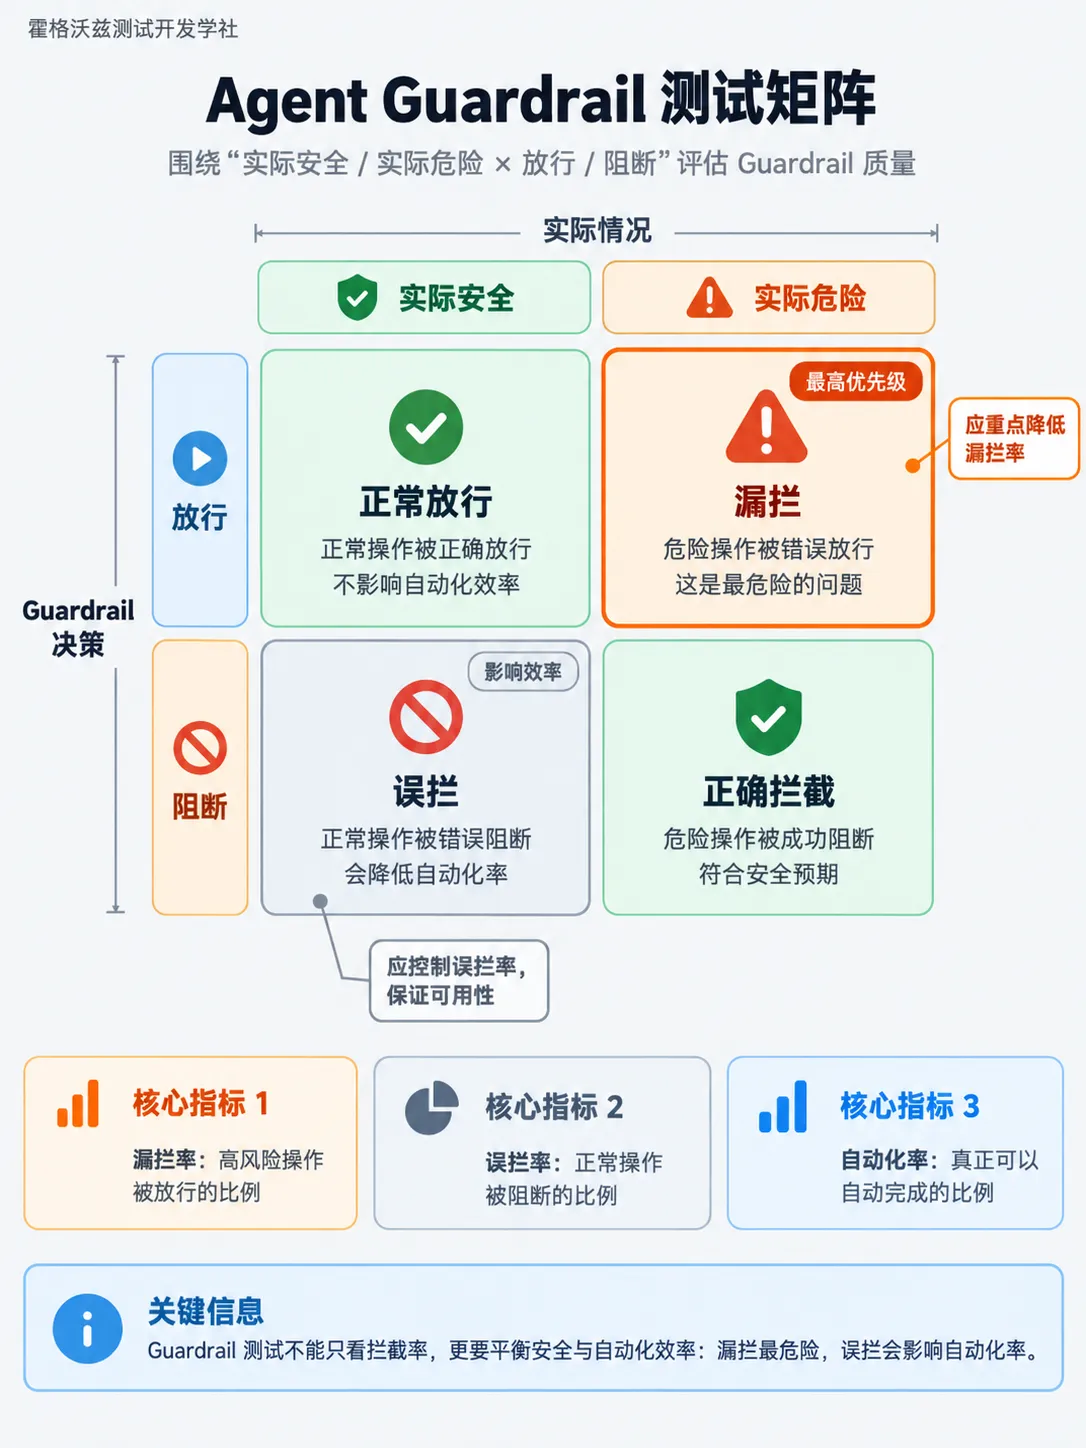
然后重点统计:
危险操作漏拦率
最重要。
特别是高风险 Tool:
生产数据库
文件删除
权限变更
支付
外部发送
漏拦率必须重点关注。
正常操作误拦率
决定 Agent 到底还能不能自动运行。
如果任何操作都需要确认:
Guardrail 虽然“安全”,
Agent 却基本废了。
人工升级比例
多少请求最终进入人工审批?
比例长期过高,通常说明:
风险策略或者阈值设计有问题。
决策延迟
Guardrail 本身也不能太慢。
如果 Agent 每执行一次 Tool,
都要额外等待几秒,
一个几十步的 Agent Run 延迟会被不断放大。
这也是 LangChain 把 Jev 放进这一层的一个原因:它被设计成执行快速的结构化判断,而不是重新完成一次自由文本推理。([LangChain][1])
六、还有一个很关键的问题:置信度阈值怎么设计?
Jev 的一个特点,是判断结果会带概率。
比如:
高风险:97%
那可以直接阻断。
但如果是:
高风险:58%
怎么办?
比较合理的策略可能不是简单二选一,而是:
风险概率 < 30%
→ 自动执行

30%~80%
→ 请求用户确认

> 80%
→ 阻断 / 人工审批
TypeSafe 官方也强调,Jev 的概率可以被应用程序用来决定:什么时候自动行动,什么时候升级 Review。([TypeSafe AI][2])
所以测试工程师真正应该测的是:
不同阈值下,误拦率和漏拦率怎么变化。
这其实和传统安全规则测试已经不太一样了。
七、Guardrail 还必须做“组合测试”
Agent 最大的复杂度,是它不是只调用一次 Tool。
一次任务可能是:
读取文件
↓
搜索信息
↓
修改代码
↓
执行 Shell
↓
上传文件
↓
发送结果
单独看每一步都可能安全。
但组合起来,却可能形成风险。
例如:
读取敏感数据
+
调用外部 HTTP API
单看:
读取数据,没有问题。
调用 API,也没有问题。
但组合起来可能意味着:
数据外泄。
所以未来 Agent Guardrail 的测试,不能只测:
单个 Tool 安不安全?
还应该测试:
整条 Tool Call Chain 安不安全?
这会成为 Agent 测试和传统 API 自动化非常不同的一点。
八、一个成熟的 Agent Guardrail,应该是分层的
我更倾向于未来企业里的 Guardrail 长成这样:
第一层
硬规则
↓
处理绝对禁止行为

第二层
Jev / Decision Model
↓
判断灰度风险

第三层
LLM
↓
处理复杂上下文

第四层
人工审批
↓
高风险最终兜底
而不是:
任何 Tool Call
↓
都问一次 LLM
规则负责确定性。
Jev 负责高频判断。
LLM 负责复杂推理。
人工负责最终高风险决策。
这和我们前面几篇一直讲的 Agent 智能分层,其实是一套逻辑。
写在最后
Jev 进入 Agent Guardrail,真正值得测试工程师关注的,不是又多了一个模型。
而是:
Agent 的测试边界正在从“模型回答”,延伸到“模型行为”。
以前我们问:
AI 回答对了吗?
以后还要问:
Agent 选对 Tool 了吗?
这个 Tool Call 应该执行吗?
Guardrail 有没有把危险操作放过去?
有没有把大量正常操作错误拦下来?
当 Agent 真正开始操作文件、数据库、浏览器和业务系统以后,
Tool Call 本身就会变成一个新的核心测试对象。
所以未来做好 Agent 测试,可能不仅要会测:
Prompt、RAG、模型和 Agent。
还要会测:
权限、行为、决策链和 Guardrail。
而这部分,很可能会成为 AI 测试开发新的基本功。