说明:本文给出一种企业 AI 账单核对的通用工程方法,示例代码为演示性质。文中口径、模型名称与数据均为示意,接入时请替换为实际业务字段,不涉及真实客户信息。
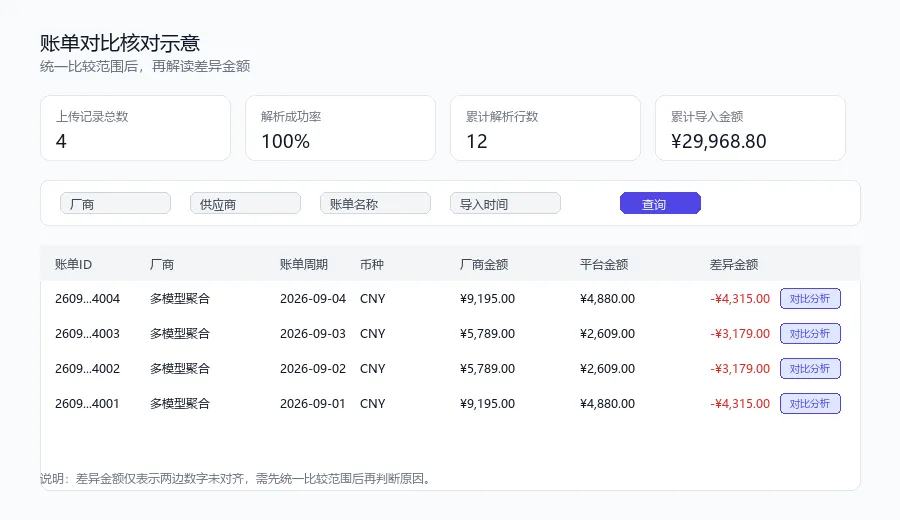
企业在接入多个 AI 模型后,费用核对经常遇到一个问题:厂商账单金额和平台记录对不上。看到差异金额时,很多人第一反应是“哪边算错了”,但实际上,更常见的原因是两边比较的账期、账号范围、模型范围或金额口径不一致。
这篇文章介绍一套可落地的核对方法:先统一比较范围,再导入厂商账单,检查解析结果,拆分差异原因,最后留下可复查的核对记录。文附 Python 与 SQL 示例。
一、统一比较范围,是核对的前提
没有统一口径的差额,只是两组数字的差,不能说明任何问题。核对前需要确认:
维度 |
需要确认的内容 |
账期 |
厂商账单实际覆盖的账单周期,是否和平台查询周期一致 |
账号范围 |
厂商账号是否被多个应用共用,平台只记录其中一部分 |
模型范围 |
两边是否覆盖同一批模型,是否有新模型未同步 |
币种与口径 |
比较的是原价、优惠后金额还是结算金额 |
调整项 |
是否包含退款、抵扣、延迟结算等特殊项目 |
只有在这些维度对齐后,差异金额才有分析价值。
二、把每次调用记录到同一张归集表
核对的基础是数据。如果每次模型调用的用量、模型、计费结果散落在不同地方,后续很难做统一分析。
建议在调用网关或费用归集层,把每次调用的关键字段写入一张归集表。最小字段集包括:请求标识、模型名称、计费方式、计费数量、计价单位、金额、计费状态、计费时间。
import sqlite3
from datetime import datetime

def init_bill_db():
    """初始化调用计费归集表。"""
    conn = sqlite3.connect("ai_bill.db")
    conn.execute("""
        CREATE TABLE IF NOT EXISTS bill_records (
            request_id TEXT PRIMARY KEY,
            model TEXT,
            billing_type TEXT,
            quantity REAL,
            unit TEXT,
            amount REAL,
            status TEXT,
            billed_at TEXT
        )
    """)
    conn.commit()
    conn.close()

def record_call(request_id, model, billing_type, quantity, unit, amount, status):
    """记录一次 AI 调用的计费信息,供后续汇总与明细核对。"""
    conn = sqlite3.connect("ai_bill.db")
    conn.execute("""
        INSERT OR REPLACE INTO bill_records
        VALUES (?, ?, ?, ?, ?, ?, ?, ?)
    """, (request_id, model, billing_type, quantity, unit,
          amount, status, datetime.now().isoformat()))
    conn.commit()
    conn.close()
落库时尽量保留原始字段,不要在写入阶段就做太多聚合。汇总可以在查询时按不同维度完成,这样同一笔记录既能按模型汇总,也能按请求 ID 追溯。
三、导入厂商账单并检查解析结果
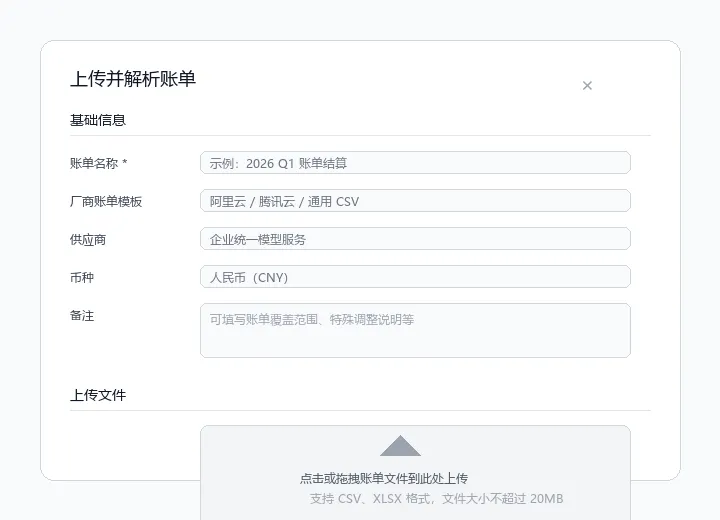
厂商账单通常以 CSV 或 XLSX 格式提供。导入时,需要先根据文件结构建立模板映射,避免字段错位。
import pandas as pd
from datetime import datetime

def parse_vendor_bill(csv_path, mapping):
    """
    按字段映射解析厂商账单。
    mapping 示例:
    {
        'bill_id': '账单ID',
        'vendor': '厂商',
        'period': '账单周期',
        'currency': '币种',
        'amount': '金额'
    }
    """
    df = pd.read_csv(csv_path)
    parsed = df.rename(columns=mapping)
    parsed['amount'] = parsed['amount'].astype(float)
    parsed['imported_at'] = datetime.now().isoformat()
    return parsed

# 使用示例
vendor_df = parse_vendor_bill(
    csv_path="aliyun_bill_2026_09.csv",
    mapping={
        "账单ID": "bill_id",
        "厂商": "vendor",
        "账单周期": "period",
        "币种": "currency",
        "金额": "amount"
    }
)
print(f"解析行数:{len(vendor_df)},金额合计:{vendor_df['amount'].sum()}")
文件能上传并不代表已经正确解析。导入后需要检查:解析行数是否等于原文件有效明细行数,累计金额是否与原文件合计一致,是否有汇总行、空行或调整记录被错误计入。
还应确认是否重复上传了同一周期、同一范围的账单,避免把重复导入形成的累计金额当成实际新增支出。
四、按相同口径汇总两边数据
数据落库后,第一步核对是按周期汇总。下面这条 SQL 按月份、模型、计费方式聚合,输出请求次数、总用量和总金额。
SELECT
  model,
  billing_type,
  COUNT(*)              AS request_count,
  SUM(quantity)         AS total_quantity,
  SUM(amount)           AS total_amount
FROM bill_records
WHERE billed_at >= '2026-09-01'
  AND billed_at <  '2026-10-01'
GROUP BY model, billing_type
ORDER BY total_amount DESC;
查询时要注意:quantity 在不同 billing_type 下的含义不同,可能是 Token 数、请求次数、生成时长或分辨率相关的计量值。因此汇总时一定要带上 billing_type,不能把“按 Token 计费”和“按次计费”的数量直接相加。
厂商账单侧也应按同样口径汇总,然后再比较两边的总额。
五、差异金额不能直接当作节省金额
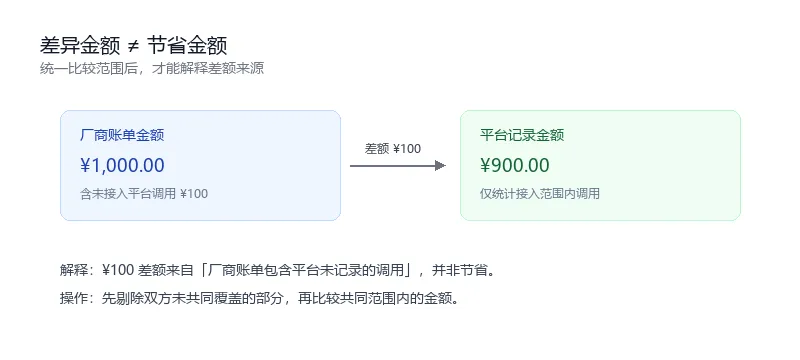
看到厂商账单 1,000 元、平台记录 900 元,差额 100 元,不能直接认定节省了 100 元。需要先判断差额来源。
常见原因包括:
- 覆盖范围不同:厂商账号被多个应用共用,平台只记录了其中一部分;
- 口径不同:一边是原价,一边是优惠后金额;
- 时间差:退款、抵扣或延迟入账尚未同步;
- 单位不同:Token 数与请求次数混用。
只有剔除双方未共同覆盖的部分后,剩余差额才是需要进一步核对的金额。
六、留下可复查的核对结论
一次账单核对,应保留账单来源、周期、覆盖范围,以及已经查明和仍待确认的差异。可以用一张核对结论表记录:
CREATE TABLE reconciliation_result (
    rec_id TEXT PRIMARY KEY,
    bill_name TEXT,
    period TEXT,
    vendor_amount REAL,
    platform_amount REAL,
    diff_amount REAL,
    explained_amount REAL,
    unexplained_amount REAL,
    notes TEXT,
    created_at TEXT
);
后续出现类似情况时,可以沿用相同口径检查,也便于技术人员与费用负责人沟通。
七、一个可复用的月度核对流程
把上面的步骤串起来,一次月度核对可以按下面七步执行:
- 统一范围:确认账期、账号、模型、币种、金额口径一致;
- 落库调用记录:每次调用保留请求 ID、模型、计费方式、数量、金额;
- 导入厂商账单:按模板映射解析,检查行数和金额;
- 汇总对比:按相同维度聚合两边数据;
- 拆分差异:判断差额来自覆盖范围、口径还是时间差;
- 重算共同范围:剔除未共同覆盖部分,确认待核对金额;
- 记录结论:保存来源、范围、已确认原因和待确认项。
账单核对的目的不是“把数字对上”,而是让每一笔支出都能被解释清楚。