一、背景
在整个数仓建设中,入仓与出仓任务占据数据集成工作量的 80% 以上;随着数据规模持续膨胀,同步性能始终是客户最关心的核心指标。而主流数仓引擎——无论是 MaxCompute、Hive 这类批处理架构,还是 StarRocks、Doris 这类 MPP 架构——底层无一例外都采用列式存储。若数据集成仍按行搬运,就要在链路中反复“拆列成行、拼行成列”,平添大量不必要的转换开销与传输损耗,同步性能自然上不去。
针对这一现状,Dataphin 同步引擎引入 Apache Arrow 列式内存标准,打通跨数据源的“列存到列存”高效同步:源端怎么存,目标端就怎么收,性能最高提升 10 倍以上,助力企业构建数据流转的“高速通道”。
二、架构升级:基于 Arrow 的列存同步
2.1 行存传输 VS 列存传输
传统行存架构
在传统的行存架构下,将数据库侧数据拉到客户端,序列化成客户端的数据结构;然后再将其拆成引擎的行存数据结构;引擎将其发送到目标端,还需要再将行存对象转换成目标端需要的数据结构写入目标端。 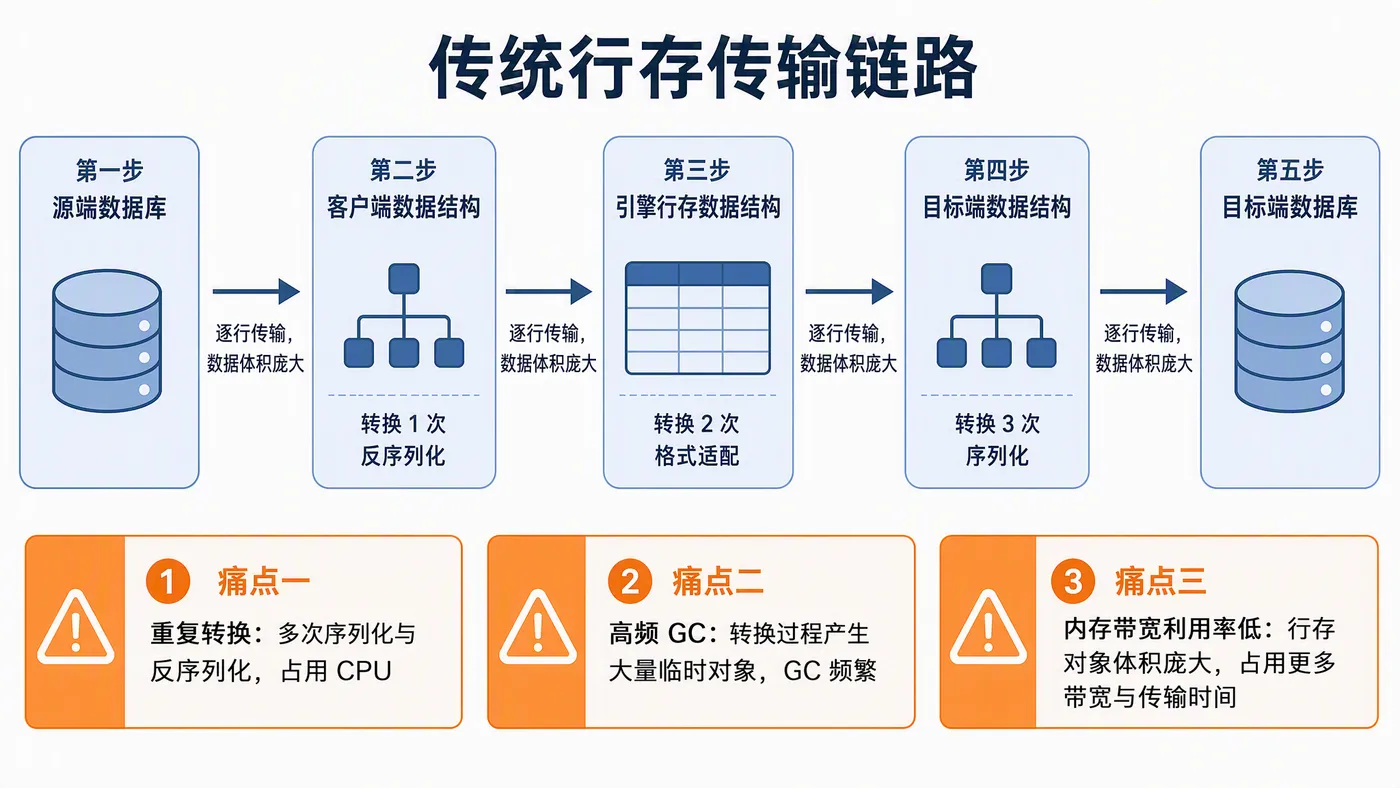
这个过程存在明显的性能浪费:
性能浪费 |
说明 |
重复转换 |
远程数据到客户端数据结构的转换、客户端数据结构到引擎行存数据结构的转换、行存结构到目标端结构的转换——同一份数据被反复序列化/反序列化,持续占用 CPU |
高频 GC |
转换过程中产生大量的临时(离线)对象,内存分配与回收压力陡增,导致频繁 GC,甚至拖慢整条链路 |
内存带宽利用率低 |
客户端与数据库之间基本以行存对象传输,数据体积庞大,占用更多网络带宽,也消耗更多传输时间 |
列存架构
列存格式的数据排列紧凑,操作按列批量进行,天然具备三方面优势:
- CPU 缓存友好:列式存储提升缓存命中率,优化计算效率;
- 底层指令优化:SIMD 指令可以批量加速类型转换等运算;
- 降低 GC:内存占用更少,GC 频率显著降低。
Arrow 列存
Apache Arrow 是由 Apache 基金会主导的跨语言、高性能列式内存数据标准,被广泛应用于大数据生态,其核心优势在于:
- 零序列化 / 反序列化:数据以内存二进制块的形式直接传输,避免格式转换开销;
- 零拷贝:跨进程、跨系统共享内存,极大降低 CPU 与内存消耗。例如 Hive、ODPS 等列存数据库,可以直接传输 Arrow 数据。2.2 Dataphin 的 Arrow 列存架构在 Dataphin 的列存同步架构中,源端列存数据库直接发送 Arrow,同步引擎直接接收 Arrow,随后将其传入目标端,目标端直接将 Arrow 写入列存数据库——全链路共享同一种列存内存表示,不再需要"行存对象"作为中间载体。
 对比传统行存链路,转换次数从多次降到零,临时对象大幅减少,网络上的数据体积也因列存格式而更紧凑。这就是"更快、更省"的来源。三、 支持Arrow列存传输的数据库目前调研支持Arrow列存传输的列存数据库有Hive、Max_Compute、Doris、SelectDB、Starrocks、Clickhouse、Hologress、Databricks等,这些支持arrow的方式有三种:
- 读写文件类(ORC、Parquet代表):读时直接将底层列式存储转换成Arrow,写时再将Arrow转换为底层列式存储。
- 专属SDK(Max_Compute代表):提供SDK,客户端与服务端直接传输Arrow。
- ADBC(Doris、SelectDB、Starrocks代表):ADBC(Arrow Database Connectivity)是 Apache Arrow 生态下的数据库访问标准,定位类似 JDBC / ODBC,但把数据交换格式固定为 Arrow,也叫Arrow Flight Sql协议。驱动与数据库之间传输的不再是行记录,而是 Arrow RecordBatch 流,Doris、SelectDB、Starrocks这类数据库就直接支持了这种传输协议:
- 省掉拼行 + 行协议编码的大头 CPU
- Arrow 列式二进制紧凑,gRPC 流式批量传,传输量更小、连接占用更短
- 零反序列化,RecordBatch 原生直接消费
四、实测效果
我们在 11 组典型同步链路(Parquet / ORC / ODPS / MySQL /SelectDB组合)上,对行存通道与 Arrow 列存通道做了端到端对比测试。
4.1 核心性能数据
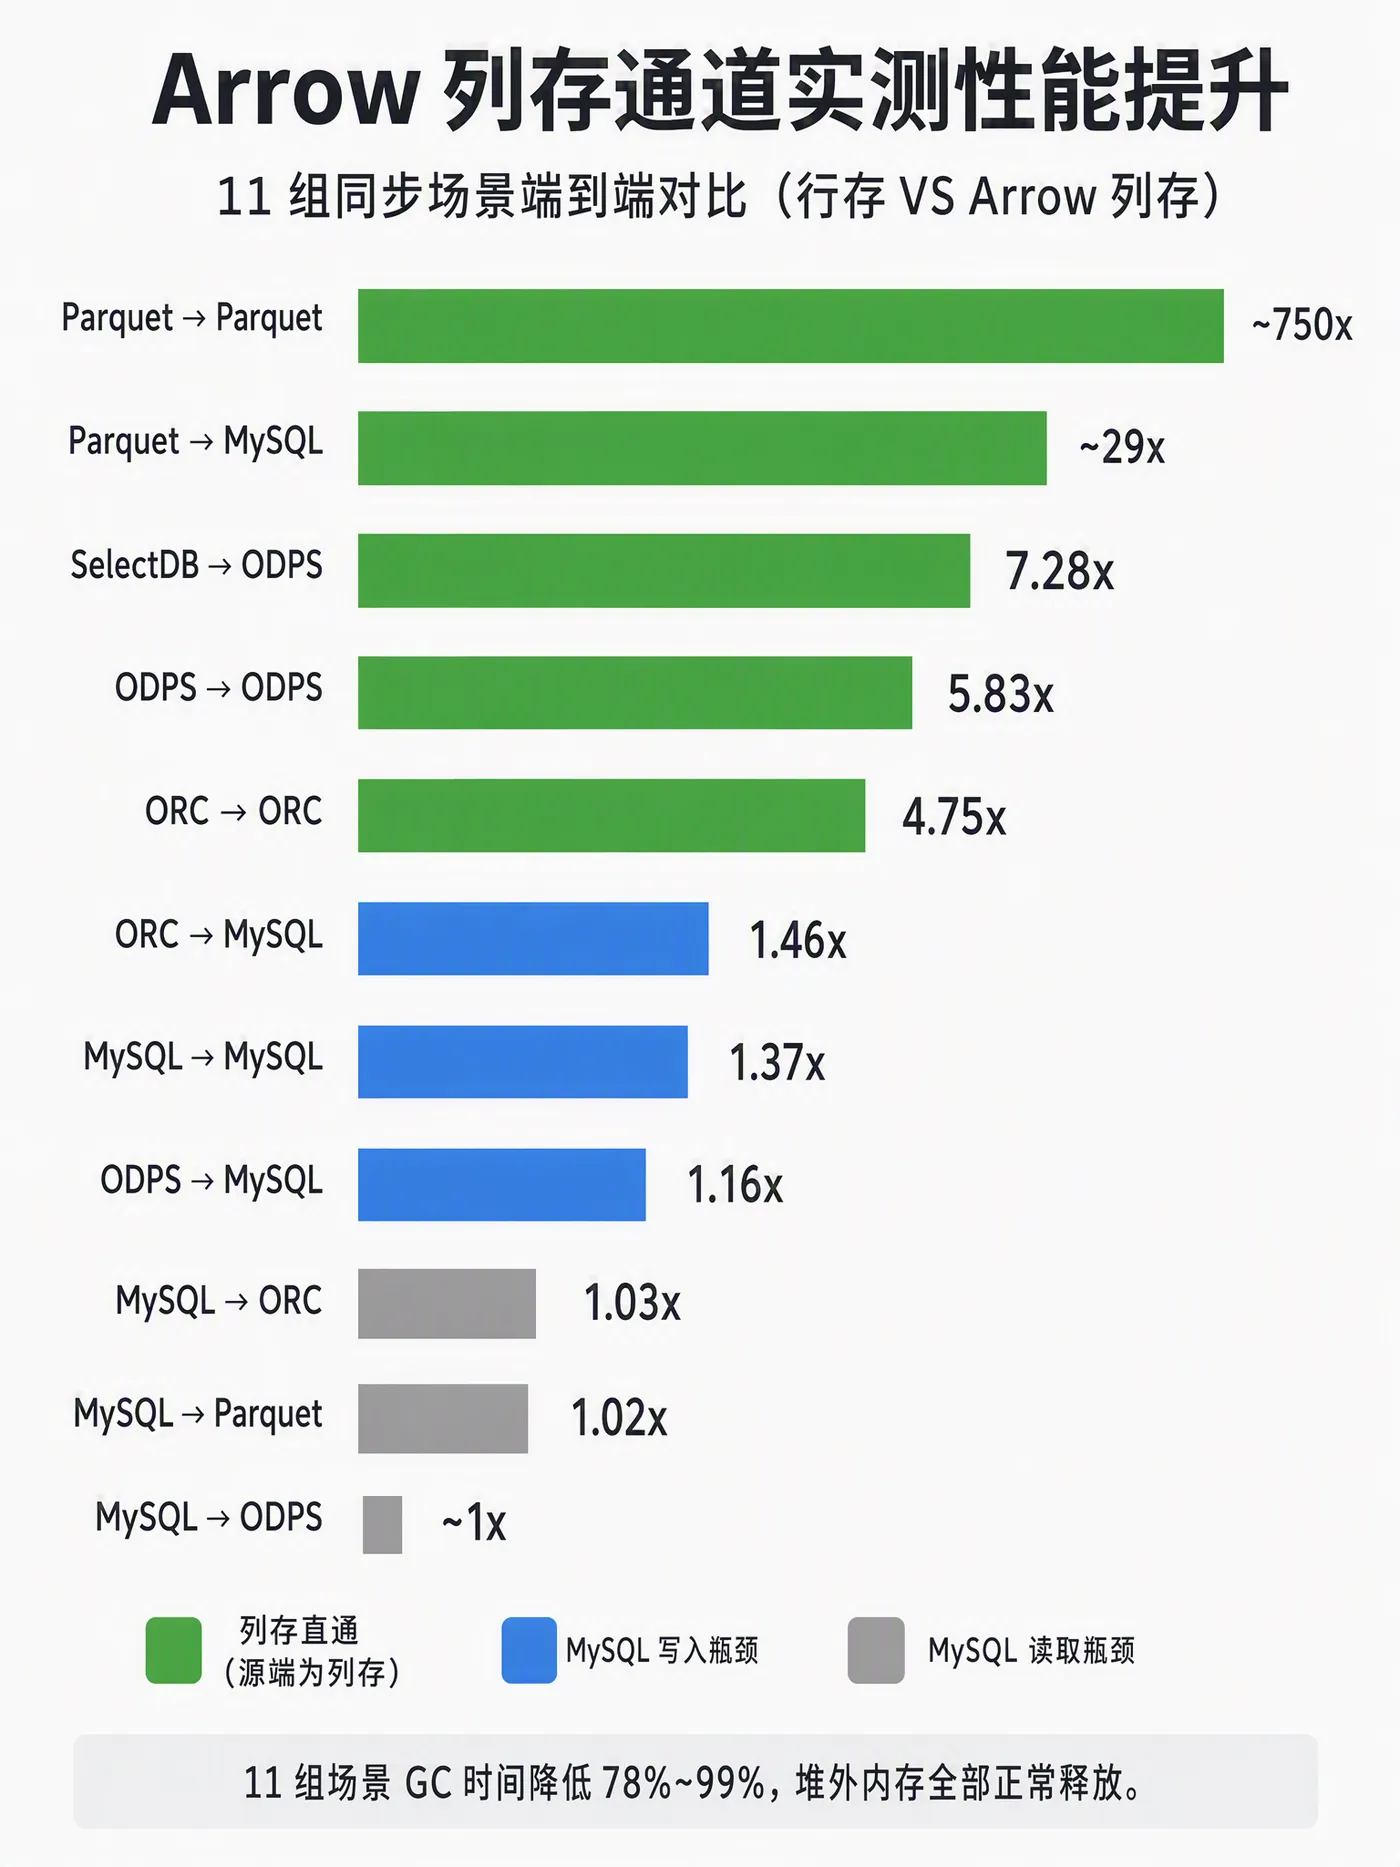
测试场景:500万条记录+200列全字段类型
测试场景 |
行存耗时 |
列存耗时 |
性能提升 |
GC 降低 |
Parquet → Parquet |
~4.8h |
23s |
~750x |
99%+ |
Parquet → MySQL |
~4.7h |
579s |
~29x |
96%+ |
ORC → ORC |
328s |
69s |
4.75x |
96% |
ODPS → ODPS |
268s |
46s |
5.83x |
95% |
ORC → MySQL |
846s |
580s |
1.46x |
95% |
MySQL → MySQL |
1,716s |
1,251s |
1.37x |
91% |
ODPS → MySQL |
1,476s |
1,272s |
1.16x |
91% |
MySQL → ORC |
408s |
395s |
1.03x |
91% |
MySQL → Parquet |
405s |
399s |
1.02x |
96% |
MySQL → ODPS |
789s |
793s |
~1x |
78% |
SelectDB → ODPS |
641s |
88s |
7.28x |
78% |
- 列存直通(源端为 Parquet / ORC / ODPS):提升 5x ~ 750x,Arrow 直接以 RecordBatch 批量读出,完全绕过逐行反序列化。
- MySQL 写入瓶颈:提升 1.2x ~ 1.5x,JDBC 写入是绝对瓶颈,提升主要来自 GC 开销降低释放了有效 CPU。
- MySQL 读取瓶颈:端到端耗时基本持平(~1x),但 GC 降低 78%~96%、CPU 降低 50% 以上,相同资源可承载更多并发任务。
五、产品支持
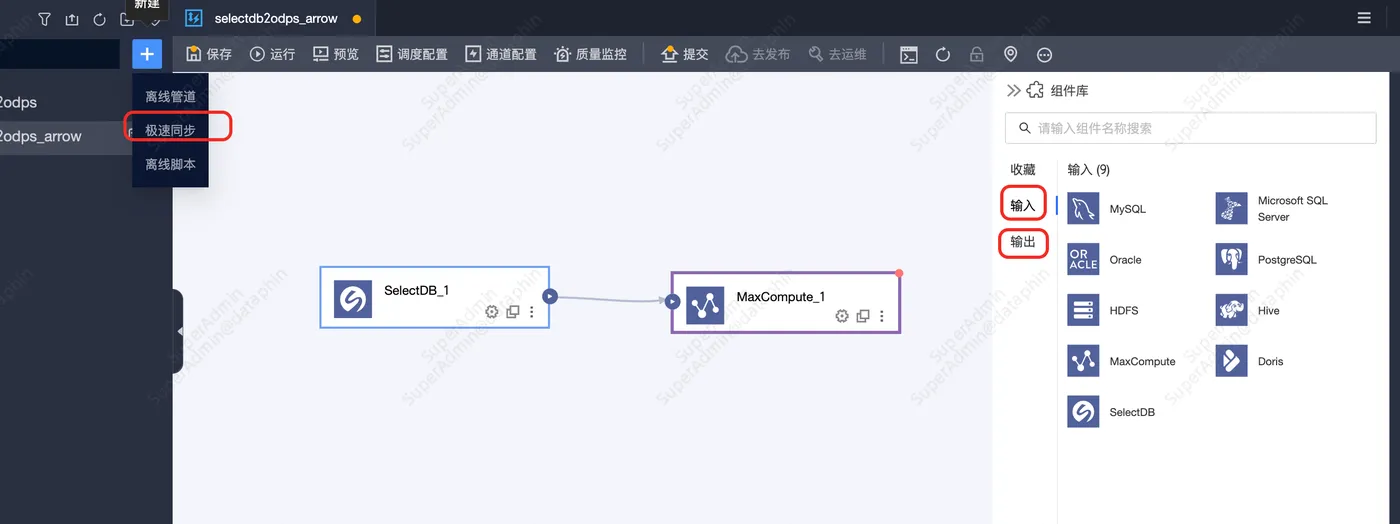
Dataphin提供 极速同步 功能入口,自动使用Arrow的管道任务,无任何额外配置成本。目前已经接入部分数据源,后续会陆续接入新的数据源。