
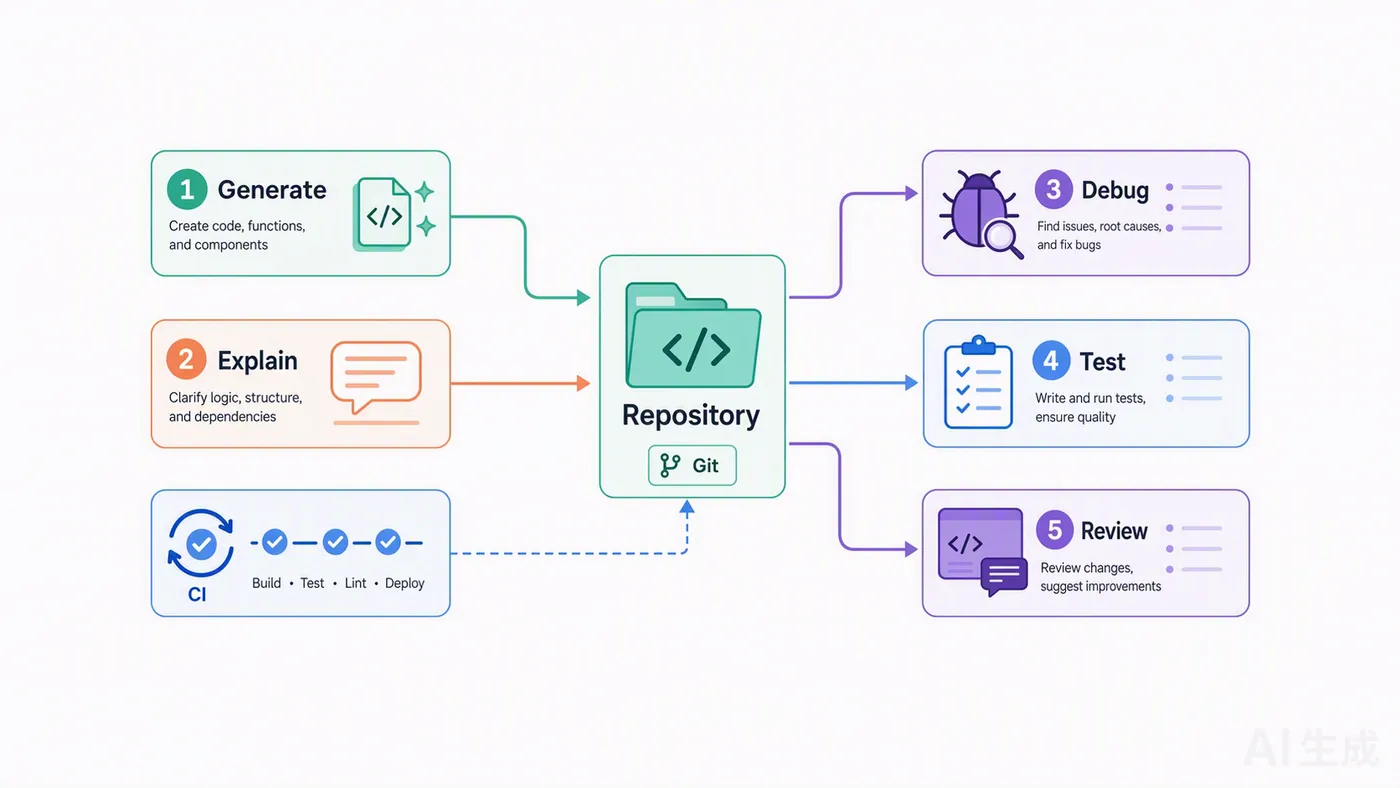
结论先行:AI 编程提效的核心,不是“一次生成更多代码”,而是“让每次修改更容易验证”。
只给一句“帮我写个接口”,模型只能补齐常见模式。提供仓库结构、接口约束、依赖版本、测试命令和禁止修改范围后,它才可能输出更贴合项目的方案。上下文不是越多越好,关键是与当前变更有关。
五类代码任务需要五种输入
代码生成适合样板代码、数据结构、接口骨架和重复转换逻辑。生成前要给出语言、框架、输入输出、异常策略和目标文件,避免得到“看起来能跑”的孤立片段。
代码解释不应只问“这段代码做什么”。更有效的问法是要求按调用链、状态变化、外部依赖和失败分支解释。对于遗留代码,还应标出推断与源码事实,避免把猜测写成结论。
代码调试需要最小复现信息:错误日志、触发输入、运行环境、预期行为、近期变更。只粘贴异常最后一行,通常会让排查退化成猜错误名称。
测试生成要明确测试框架、边界条件和 Mock 策略。模型可以补充测试候选,但测试断言必须来自业务规则。否则容易出现“代码怎么写,测试就怎么证明它正确”的自证循环。
代码审查适合发现空值处理、并发风险、资源泄漏、权限遗漏和可维护性问题。审查提示应要求按严重级别输出,并给出触发条件,不要把个人风格偏好伪装成缺陷。
这五类任务不能混成一句“帮我优化”。生成追求约束清楚,调试追求证据充分,测试追求可验证,审查追求风险排序。任务越具体,输出越容易被工程流程接住。
用一份模板控制输入与验收
先在仓库里建立“最小充分上下文”,通常包括:
- 当前任务与验收标准;
- 涉及的文件及调用关系;
- 语言、框架、依赖版本;
- 可执行的测试、构建和静态检查命令;
- 禁止修改的目录、公共接口和数据结构;
- 安全、权限、性能方面的明确限制。
然后使用下面的提示词模板:
你正在处理一个现有代码仓库。
任务:
[描述要修复的问题或新增能力]
已知上下文:
- 技术栈:[语言、框架、运行环境]
- 相关文件:[文件路径与作用]
- 当前行为:[可复现现象]
- 预期行为:[验收标准]
- 依赖限制:[允许或禁止新增的依赖]
- 权限边界:[不得访问的资源或不得执行的动作]
请按以下顺序回答:
1. 说明你对问题的理解,并标出仍属推断的部分;
2. 给出最小修改方案及受影响文件;
3. 提供代码变更;
4. 补充正常、边界和失败路径测试;
5. 给出验证命令;
6. 列出仍需人工确认的风险。
不要修改:[目录、接口或配置]
接下来,不要直接接受代码。先检查方案是否理解了仓库,再审查变更范围。新增依赖要确认许可证、维护状态、锁文件变化和部署环境,不要为了少写几十行代码引入体积较大的依赖。
测试也要分层执行。先跑目标模块测试,再跑静态检查和类型检查,最后根据影响范围执行集成测试。模型说“已修复”不构成验收,命令输出和行为结果才构成证据。
权限边界同样重要。不要把生产密钥、用户数据或完整环境变量交给模型。涉及文件删除、数据库迁移、发布和外部写操作时,应先展示计划和差异,再由人工确认。
可以先在
千问大模型平台https://platform.qianwenai.com/try-ai体验代码解释、方案拆解和提示词效果;需要通过 API 接入研发门户、代码审查机器人或内部应用时,可在阿里云百炼平台https://bailian.console.aliyun.com/完成应用落地。可用模型、额度和上下文长度,以控制台与官方文档为准。
AI 能写代码,但不能替你拥有仓库
代码模型看不到未提供的文件,也不知道团队口头约定。涉及架构取舍、兼容策略和安全责任时,应由维护者做决定。对生成代码进行审查,不是额外步骤,而是开发流程的一部分。
一次提供整个仓库,效果会更好吗?
不一定。无关文件会稀释关注点,也可能暴露敏感信息。优先提供入口文件、调用链、类型定义、相关测试和项目规范,再按缺口补充。
生成的测试通过,是否代表修改可以上线?
不代表。测试可能遗漏真实依赖、权限、并发和数据迁移问题。还应结合代码审查、集成环境验证和发布策略判断。
调试时应该先让模型改代码吗?
先复现,再定位。要求模型列出假设、证据和验证方法,逐个排除。没有定位根因就连续改代码,容易把原问题变成多个问题。
参考资料
千问 Coder 模型能力https://help.aliyun.com/zh/model-studio/qwen-coder
Qwen Code 官方文档https://qwenlm.github.io/qwen-code-docs/zh/
AI 可以缩短敲代码的时间,但只有测试、审查和权限边界,才能缩短代码进入生产的距离。
