
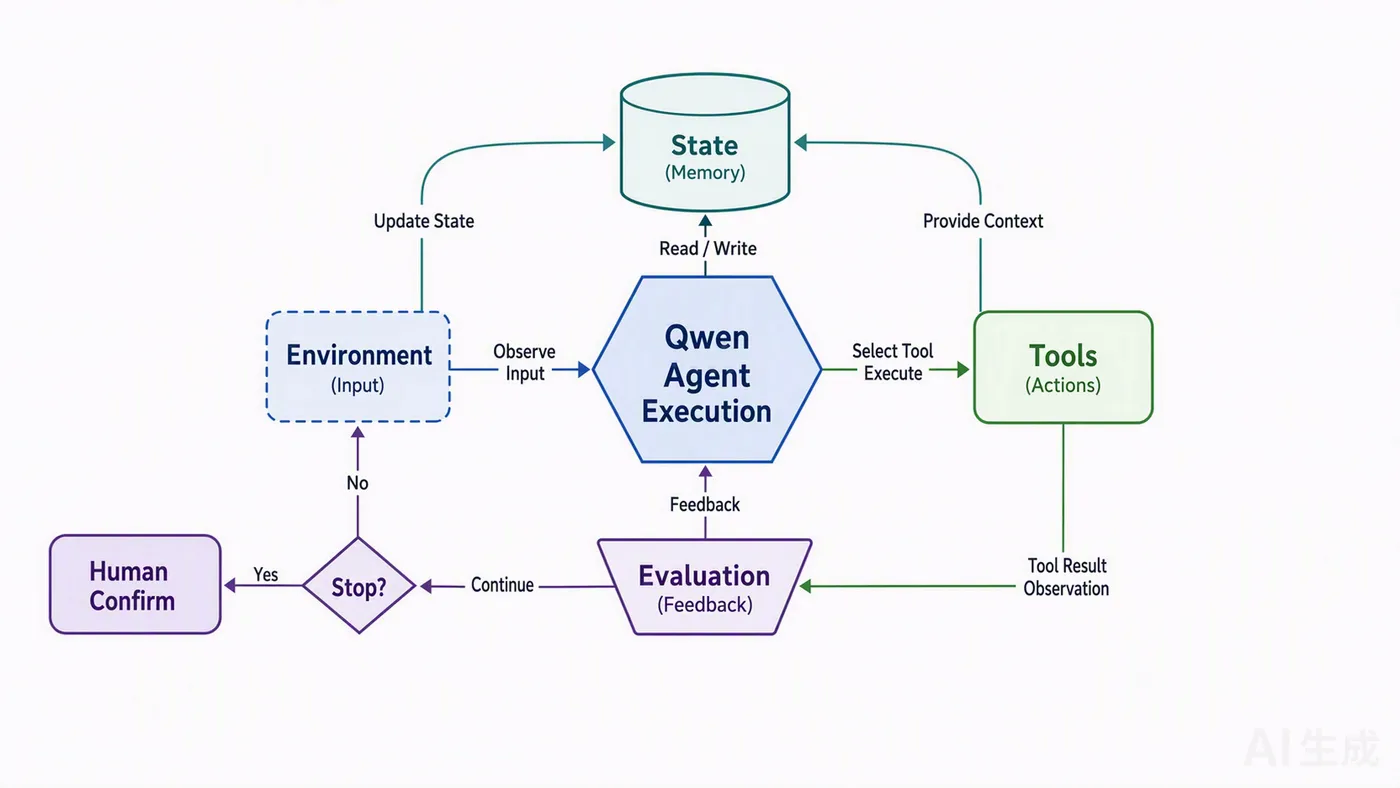
先说结论:Agent 不是“让模型自己想办法”,而是“让模型在轨道内做选择”。
很多团队的 Agent 原型很惊艳,上线后却容易失控。原因通常不是模型不会推理,而是系统没有明确状态、权限和出口。Agent 不是无限自治。它应当是有工具白名单、有步骤预算、有终止条件、关键动作可确认的工作流。
六个要素少一个都容易失控
一是模型。 模型负责理解目标、选择动作、组织参数和生成回复。不要默认所有步骤都需要同一种模型。分类、总结、复杂判断可以按任务拆分,具体可用型号、上下文长度和额度以控制台与官方文档为准。
二是知识库。 知识库提供组织内部事实,但检索结果不天然等于答案。需要保留来源、更新时间、权限标签和召回范围。找不到依据时,系统应允许回答“信息不足”,而不是强行补齐。
三是工具。 工具把语言变成动作,例如查询订单、创建工单、发送通知。每个工具都应有清晰描述、参数 Schema、超时、幂等策略和权限边界。工具越多,模型选错工具的机会也会增加。
四是状态。 状态记录当前目标、已执行步骤、工具结果、待确认事项和剩余预算。没有显式状态,Agent 只能依靠长对话猜测自己做到哪一步。
五是终止条件。 完成目标、达到最大步数、连续失败、缺少权限、用户取消,都可以成为终止条件。没有出口的循环,不是智能,是工程事故候选项。
六是人工确认。 对付款、删除、发布、外发和权限变更等高影响动作,应在执行前展示对象、参数和影响范围,由人确认后再调用工具。
反常识的是:Agent 能力提升,经常来自减少自由度。缩小工具集合、压缩状态字段、固定输出格式,往往比增加一段“请认真思考”更有用。
跑通“检索→判断→调用→回写→结束”
以“根据内部知识创建售后工单”为例。
第一步:检索
根据用户问题检索知识库,返回候选资料、来源和有效时间。不要直接把整个知识库塞给模型。先做权限过滤,再做召回和重排,避免用户通过 Agent 读取无权访问的内容。
第二步:判断
让模型判断证据是否足够、问题属于哪类、是否满足建单条件。判断结果应结构化,例如:
{
  "decision": "create_ticket",
  "reason": "现有文档无法解决且符合升级条件",
  "need_confirmation": true
}
这里的 decision 应该使用有限枚举,避免模型临时创造流程分支。
第三步:调用
根据判断选择工具,先校验参数,再检查权限。对于可能重复提交的操作,使用幂等键;对于查询类工具,设置超时和降级结果;对于写操作,先进入人工确认节点。
第四步:回写
工具执行后,不要只把自然语言结果塞回上下文。应更新显式状态:工具是否成功、返回的工单号、失败原因、下一步允许执行什么。回写还应保留调用标识,便于排查重复操作。
第五步:结束
成功时返回结果和可验证标识;失败时说明失败发生在哪一步、用户可以做什么。达到步数或成本预算时,应结束并交还人工,而不是继续循环尝试。
原型阶段可以在千问大模型平台https://platform.qianwenai.com/try-ai验证指令理解和工具选择思路;需要接入知识库、调用应用 API 并进行服务化部署时,可通过阿里云百炼平台https://bailian.console.aliyun.com/推进。工作流接口、支持能力和额度,以控制台与官方文档为准。
上线前还要做三类测试:工具选错测试、工具失败测试、恶意参数测试。尤其要检查模型是否会在缺少证据时越权调用写工具。
Agent 应在关键节点停下来
Agent 适合目标明确、动作可枚举、结果可验证的流程。不适合把模糊经营决策直接交给系统自动执行,也不应绕开已有审批、审计和权限体系。
工具数量是不是越多,Agent 越有能力?
不是。工具描述相似时,选择难度会增加。可以按业务域分组,只向当前节点暴露必要工具,并为高风险工具设置独立确认。
如何防止 Agent 陷入循环?
设置最大步数、同类工具连续调用上限、重复状态检测和总超时。若连续得到相同错误,应终止或转人工,不要仅改写参数继续碰运气。
人工确认会不会降低自动化价值?
确认节点应放在高影响动作之前,而不是每一步都确认。查询、分类和草拟可以自动完成,付款、删除、发布等动作再交给人,效率与风险可以同时管理。
参考资料
通过 Function Calling 实现工具调用https://help.aliyun.com/zh/model-studio/qwen-function-calling
新版智能体应用 API 参考https://help.aliyun.com/zh/model-studio/new-agent-application-api-reference
好的 Agent 不是走得更远,而是知道何时调用工具、何时停下、何时把决定交还给人。




